k8s-kubernetes-deployment
本文深入探讨Kubernetes Deployment的yaml格式、功能特性、与ReplicaSet的区别,以及如何通过Deployment管理pod,包括运行、缩容、高可用验证,直至通过标签控制pod在特定节点的运行。
文章信息
- 原文链接:https://jiayq.blog.csdn.net/article/details/102729757
- 发布时间:2019-10-24 19:08:44
- 阅读量:1
- 分类:kubenetes专栏收录该内容, 订阅专栏
- 标签:#kubernetes, #k8s的deployment, #滚动升级, #标签控制pod位置, #每个节点最多运行一个服务
摘要
文章浏览阅读1.6k次。本文深入探讨Kubernetes Deployment的yaml格式、功能特性、与ReplicaSet的区别,以及如何通过Deployment管理pod,包括运行、缩容、高可用验证,直至通过标签控制pod在特定节点的运行。
k8s-kubernetes-deployment
- 1.deployment的yaml格式
- 2.deployment介绍
- 3.deployment和ReplicaSet
- 4.运行deployment
- 5.每个节点最多运行一个pod的deployment
- 6.通过标签控制pod的位置
1.deployment的yaml格式
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
apiVersion: extensions/v1beta1   #接口版本
kind: Deployment                 #接口类型
metadata:
  name: cango-demo               #Deployment名称
  namespace: cango-prd           #命名空间
  labels:
    app: cango-demo              #标签
spec:
  replicas: 3
  strategy:
    rollingUpdate:  ##由于replicas为3,则整个升级,pod个数在2-4个之间
      maxSurge: 1      #滚动升级时会先启动1个pod
      maxUnavailable: 1 #滚动升级时允许的最大Unavailable的pod个数
  template:
    metadata:
      labels:
        app: cango-demo  #模板名称必填
    sepc: #定义容器模板,该模板可以包含多个容器
      containers:
        - name: cango-demo                                                           #镜像名称
          image: swr.cn-east-2.myhuaweicloud.com/cango-prd/cango-demo:0.0.1-SNAPSHOT #镜像地址
          command: [ "/bin/sh","-c","cat /etc/config/path/to/special-key" ]    #启动命令
          args:                                                                #启动参数
            - '-storage.local.retention=$(STORAGE_RETENTION)'
            - '-storage.local.memory-chunks=$(STORAGE_MEMORY_CHUNKS)'
            - '-config.file=/etc/prometheus/prometheus.yml'
            - '-alertmanager.url=http://alertmanager:9093/alertmanager'
            - '-web.external-url=$(EXTERNAL_URL)'
    #如果command和args均没有写,那么用Docker默认的配置。
    #如果command写了,但args没有写,那么Docker默认的配置会被忽略而且仅仅执行.yaml文件的command(不带任何参数的)。
    #如果command没写,但args写了,那么Docker默认配置的ENTRYPOINT的命令行会被执行,但是调用的参数是.yaml中的args。
    #如果如果command和args都写了,那么Docker默认的配置被忽略,使用.yaml的配置。
          imagePullPolicy: IfNotPresent  #如果不存在则拉取
          livenessProbe:       #表示container是否处于live状态。如果LivenessProbe失败,LivenessProbe将会通知kubelet对应的container不健康了。随后kubelet将kill掉container,并根据RestarPolicy进行进一步的操作。默认情况下LivenessProbe在第一次检测之前初始化值为Success,如果container没有提供LivenessProbe,则也认为是Success;
            httpGet:
              path: /health #如果没有心跳检测接口就为/
              port: 8080
              scheme: HTTP
            initialDelaySeconds: 60 ##启动后延时多久开始运行检测
            timeoutSeconds: 5
            successThreshold: 1
            failureThreshold: 5
          readinessProbe:
            httpGet:
              path: /health #如果没有心跳检测接口就为/
              port: 8080
              scheme: HTTP
            initialDelaySeconds: 30 ##启动后延时多久开始运行检测
            timeoutSeconds: 5
            successThreshold: 1
            failureThreshold: 5
          resources:              ##CPU内存限制
            requests:
              cpu: 2
              memory: 2048Mi
            limits:
              cpu: 2
              memory: 2048Mi
          env:                    ##通过环境变量的方式,直接传递pod=自定义Linux OS环境变量
            - name: LOCAL_KEY     #本地Key
              value: value
            - name: CONFIG_MAP_KEY  #局策略可使用configMap的配置Key,
              valueFrom:
                configMapKeyRef:
                  name: special-config   #configmap中找到name为special-config
                  key: special.type      #找到name为special-config里data下的key
          ports:
            - name: http
              containerPort: 8080 #对service暴露端口
          volumeMounts:     #挂载volumes中定义的磁盘
          - name: log-cache
            mount: /tmp/log
          - name: sdb       #普通用法,该卷跟随容器销毁,挂载一个目录
            mountPath: /data/media
          - name: nfs-client-root    #直接挂载硬盘方法,如挂载下面的nfs目录到/mnt/nfs
            mountPath: /mnt/nfs
          - name: example-volume-config  #高级用法第1种,将ConfigMap的log-script,backup-script分别挂载到/etc/config目录下的一个相对路径path/to/...下,如果存在同名文件,直接覆盖。
            mountPath: /etc/config
          - name: rbd-pvc                #高级用法第2中,挂载PVC(PresistentVolumeClaim)

#使用volume将ConfigMap作为文件或目录直接挂载,其中每一个key-value键值对都会生成一个文件,key为文件名,value为内容,
  volumes:  # 定义磁盘给上面volumeMounts挂载
  - name: log-cache
    emptyDir: {}
  - name: sdb  #挂载宿主机上面的目录
    hostPath:
      path: /any/path/it/will/be/replaced
  - name: example-volume-config  # 供ConfigMap文件内容到指定路径使用
    configMap:
      name: example-volume-config  #ConfigMap中名称
      items:
      - key: log-script           #ConfigMap中的Key
        path: path/to/log-script  #指定目录下的一个相对路径path/to/log-script
      - key: backup-script        #ConfigMap中的Key
        path: path/to/backup-script  #指定目录下的一个相对路径path/to/backup-script
  - name: nfs-client-root         #供挂载NFS存储类型
    nfs:
      server: 10.42.0.55          #NFS服务器地址
      path: /opt/public           #showmount -e 看一下路径
  - name: rbd-pvc                 #挂载PVC磁盘
    persistentVolumeClaim:
      claimName: rbd-pvc1         #挂载已经申请的pvc磁盘
2.deployment介绍
deployment与Replication Controller基本一样,deployment全部继承了Replication Controller的功能,还实现了下面的特性:
- 事件和状态查看:可以查看Deployment的升级详细进度和状态
- 回滚:当升级pod的镜像或者参数出现问题时,可以使用回滚操作回退到上个稳定的版本或者指定的版本。
- 版本记录:每一次对deployment的操作,都能保存下来,以备回滚。
- 暂停和启动:对于每一次升级,都能够随时暂停和启动。
- 多种升级方案:主要是重建、滚动升级等。
3.deployment和ReplicaSet
Replication Controller复制控制器,在之前的版本中,Replication Controller保证pod的健康状态和数量,当存在异常的pod时,Replication Controller就会重新创建pod用于替换有问题的、不健康的pod.
同时Replication Controller也是k8s的高可用的保证。
RelicaSet和Replication Controller除了名字完全相同。
有一点区别:
ReplicaSet支持集合式的选择器;而Replication Controller只支持等式选择。
即ReplicaSet比Replication Controller的功能更加强大。
k8s不建议用户直接去操作ReplicaSet,而是通过deployment去管理ReplicaSet.
4.运行deployment
tomcat-deployment.yaml
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
apiVersion: apps/v1
kind: Deployment
metadata:
  name: tomcat-deployment
  namespace: study
  labels:
    tomcat: deployment
spec:
  replicas: 3
  selector:
    matchLabels:
      tomcat: template
  strategy:
    rollingUpdate:
      maxSurge: 1
      maxUnavailable: 1
  template:
    metadata:
      labels:
        tomcat: template
    spec:
      containers:
      - name: tomcat-pod
        image: tomcat
        imagePullPolicy: IfNotPresent
        command: ["/usr/local/tomcat/bin/catalina.sh","run"]
        workingDir: /usr/local/tomcat/
        livenessProbe:
          tcpSocket:
            port: 80
          initialDelaySeconds: 180
          timeoutSeconds: 30
          periodSeconds: 600
        resources:
          limits:
            cpu: 500m
            memory: 500Mi
          requests:
            cpu: 200m
            memory: 50Mi
        ports:
        - name: tomcat-80
          containerPort: 80
          hostPort: 10080
          protocol: TCP
        - name: tomcat-8080
          containerPort: 8080
          hostPort: 18080
          protocol: TCP
        - name: tomcat-443
          containerPort: 443
          hostPort: 10443
          protocol: TCP
        env:
        - name: ORACLE_HOME
          value: oracle
        volumeMounts:
        - name: tomcat-log
          mountPath: /usr/local/tomcat/logs/
          readOnly: false
      volumes:
      - name: tomcat-log
        nfs:
          server: 10.0.228.93
          path: /userdata/testtomcatlog
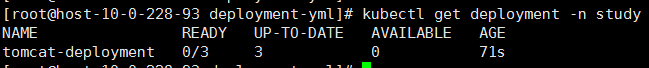
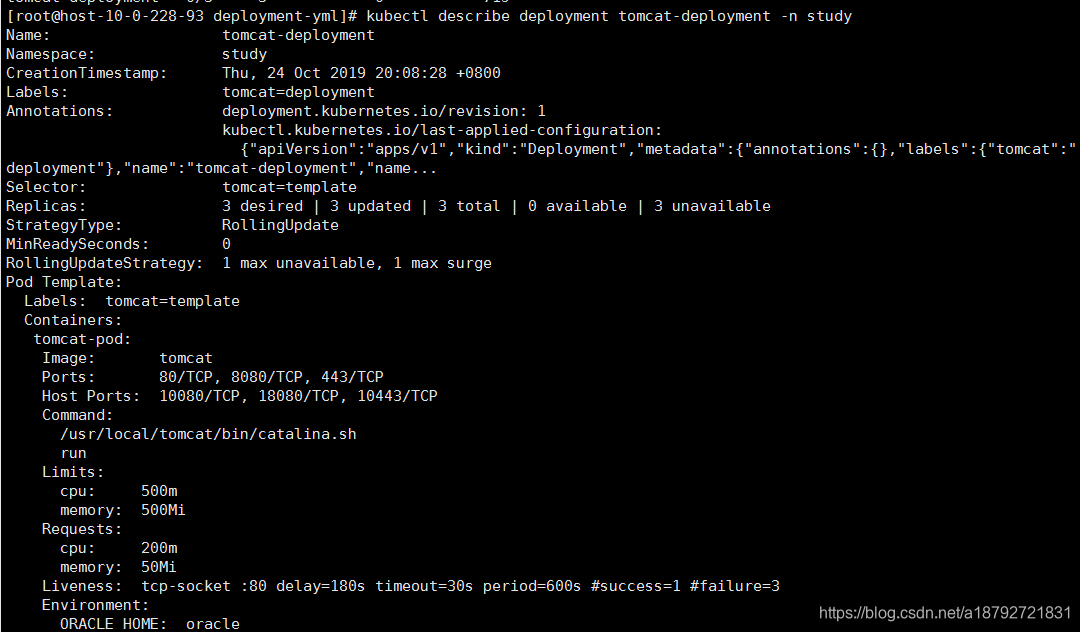
查看deployment
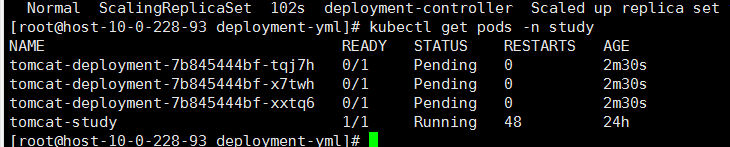
查看pod
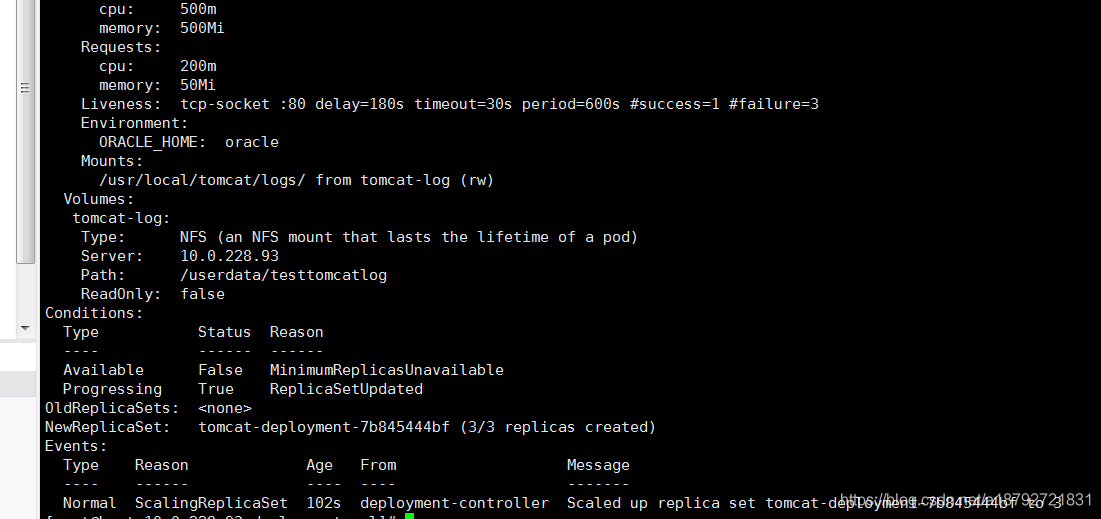
查看ReplicaSet
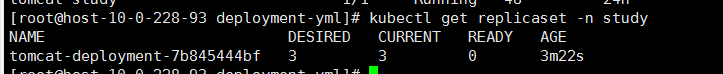
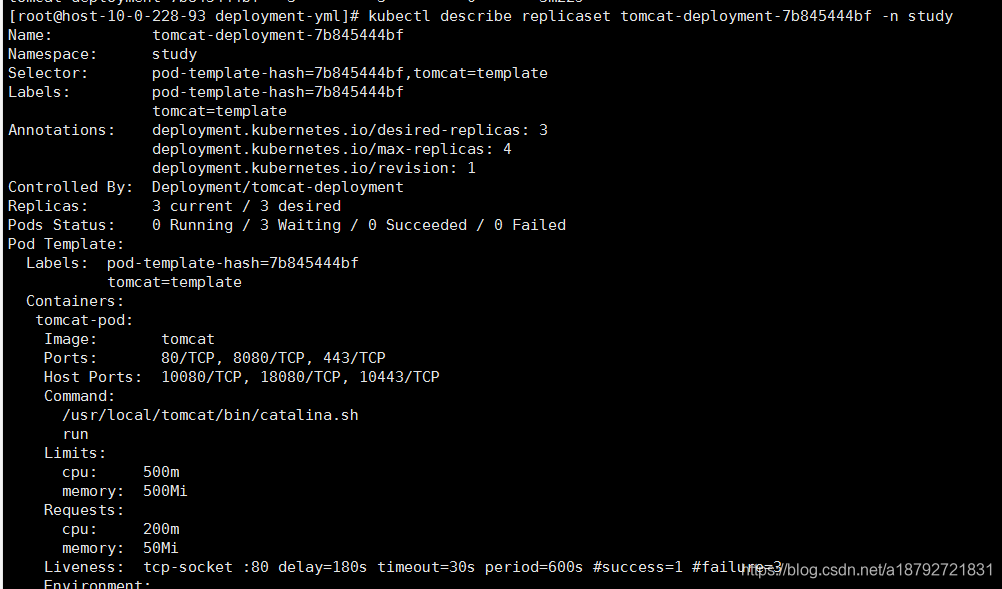
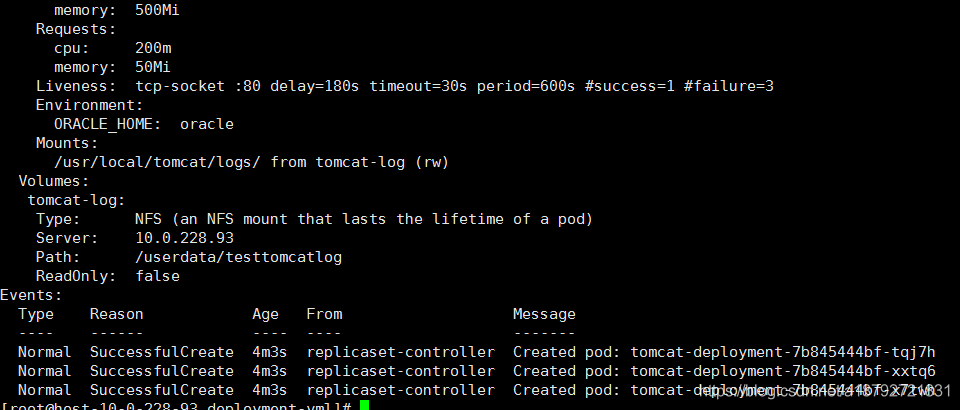
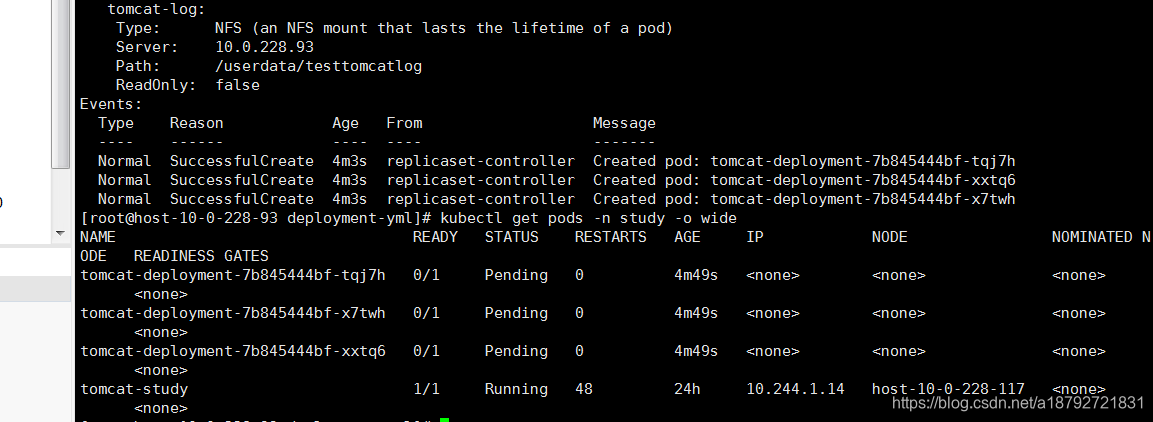
好长时间了,没有创建成功,为什么呢?
查看pod的详细信息
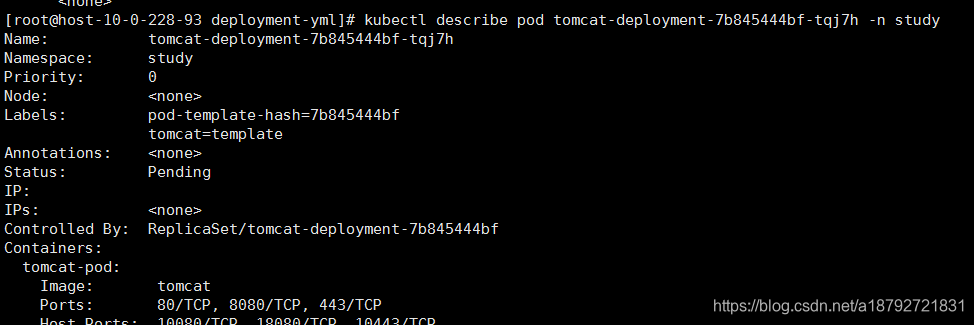
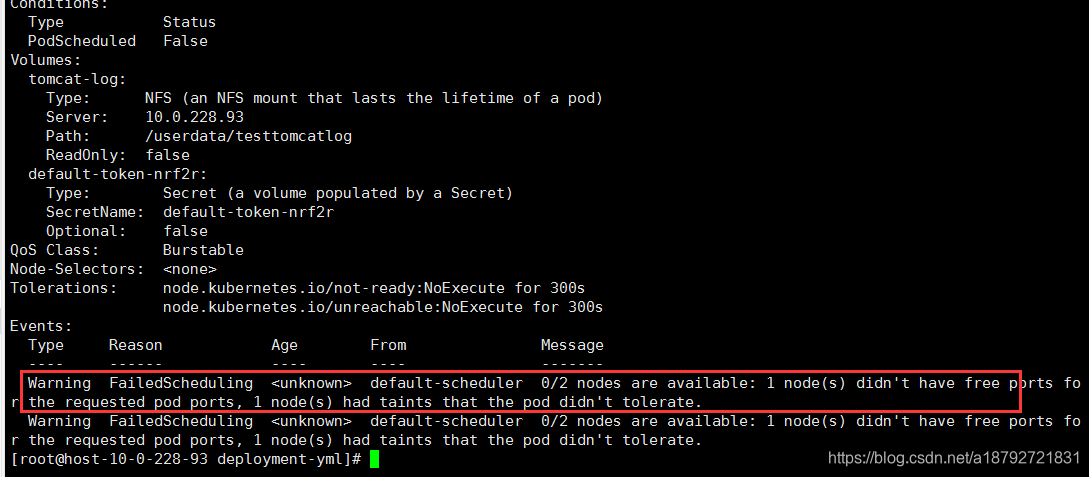
发现原因了,为什么deployment没有创建成功呢?
1.原来的pod:tomcat-study是用pod的yaml启动的,tomcat-study就占用node节点的18080、10443、10080端口,所以node节点上分配的pod因为端口占用,全部启动失败;
2.按照我们的理解,master节点也应该被分配pod,这样master节点就会启动pod,正好master节点也没有端口占用问题。但是实际上,master节点默认不允许分配用户pod,只能存在一些k8s系统的pod。
3.我们需要3个pod,但是实际上只有两个pod,因为端口占用问题,第三个pod永远不会被创建成功。
如何解决呢?
第一步,删除原来的tomcat-study的这个pod,这样k8s集群中暂时全部都是我们deployment的pod了

然后我们看下pod的分配情况:
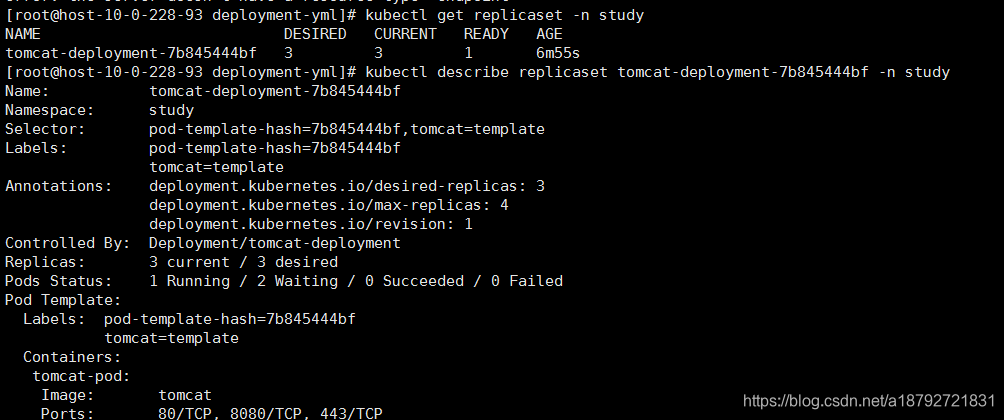
发现node节点的已经成功启动了,但是因为默认不允许分配用户pod到master上,所以只成功了一个:
现在我们去掉这个限制,允许master节点分配pod
1
kubectl taint nodes --all node-role.kubernetes.io/master-

他会报错,不要管。这个限制已经去掉了,接下来我们看下pod的情况
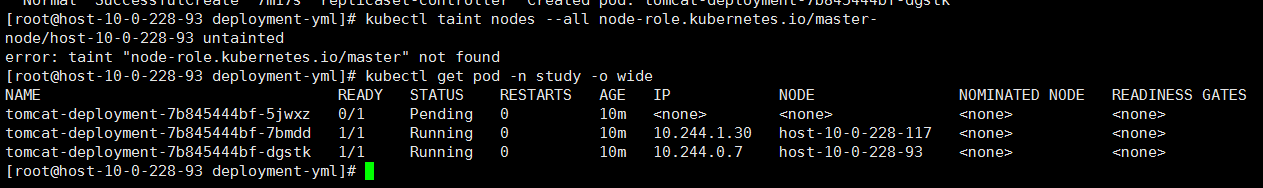
现在还有一个无法分配,因为我们所有的机器都被分配了。
正好试试缩容
1
kubectl scale deployment tomcat-deployment --replicas=2 -n study
将副本的数量设置为2
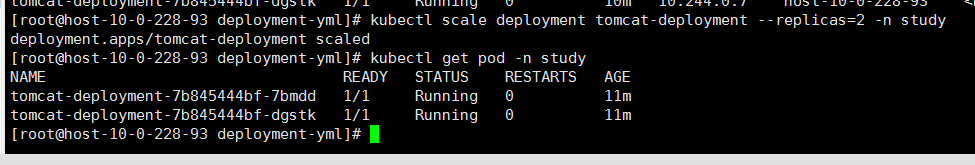
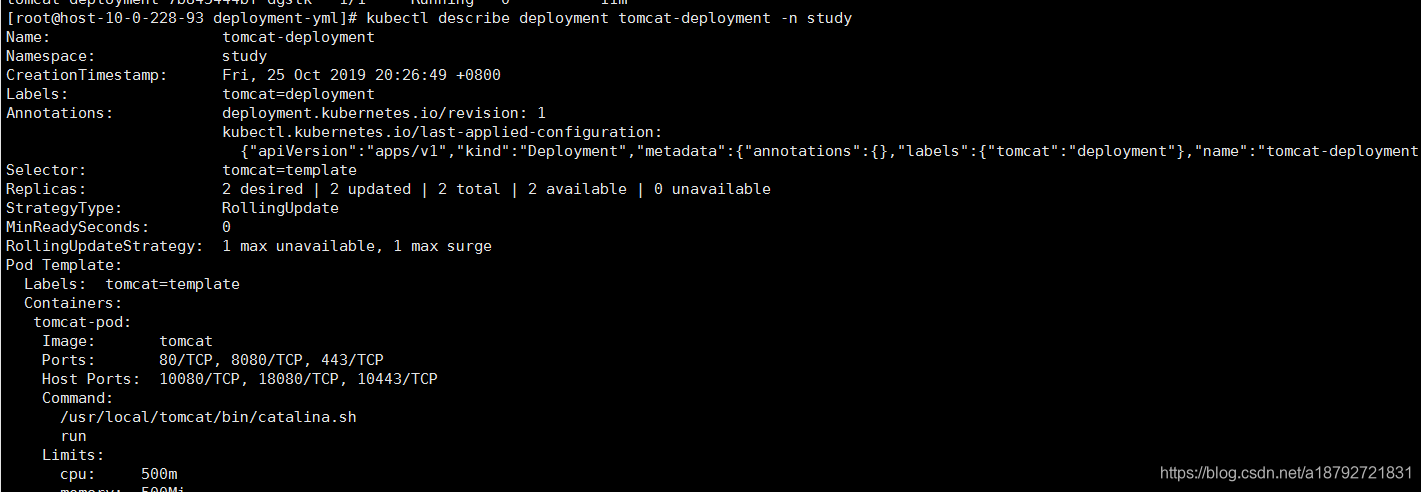
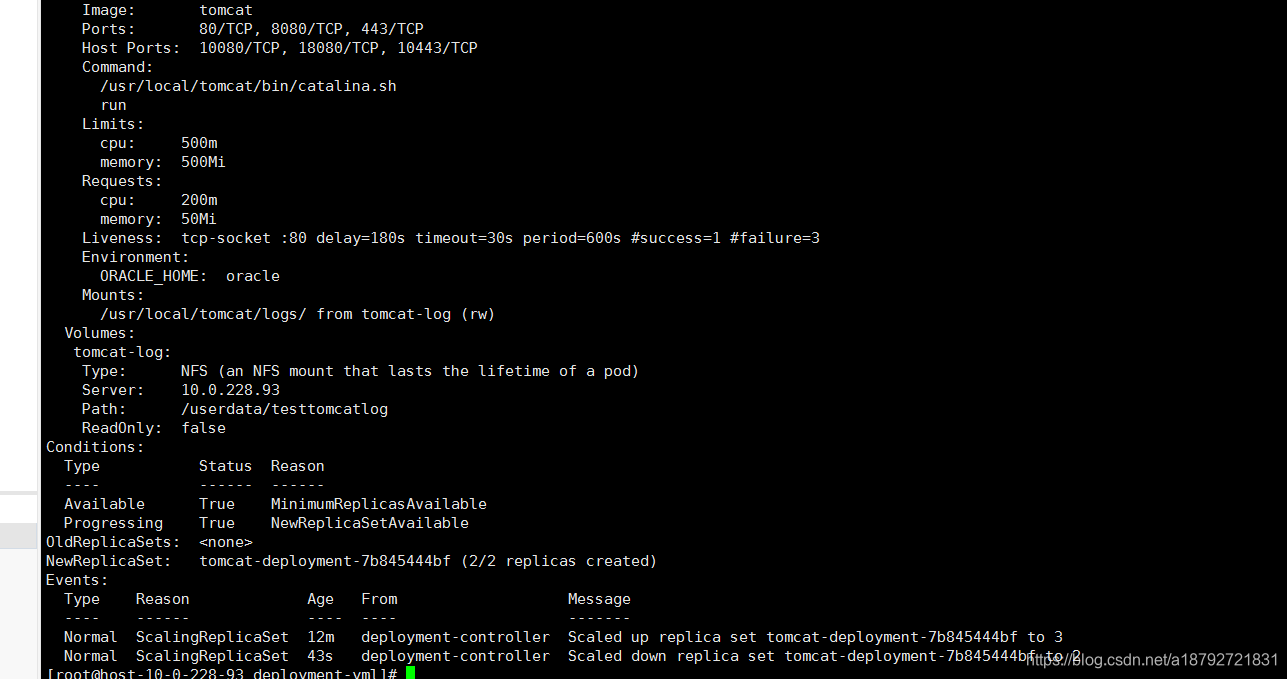
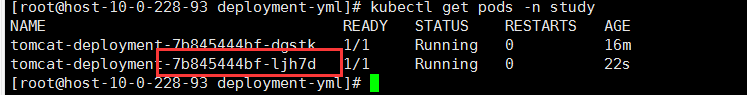
接下来我们主动手动删除一个pod,验证k8s的高可用。
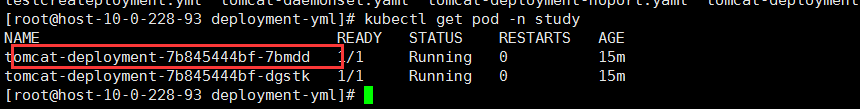
就是这个删除掉7bmdd

它马上又新建了一个
5.每个节点最多运行一个pod的deployment
在4中,因为pod端口映射了物理端口,会造成端口占用,导致每个节点最多启动一个pod,但是,很多时候我们创建deployment时,并不能准确的确定有多少个节点,没增加一个节点就需要更新deployment的副本数量,非常的麻烦。
那么,如何解决这个问题呢?
那就是DaemonSet
先删除4的deployment
然后拷贝4中的yaml文件
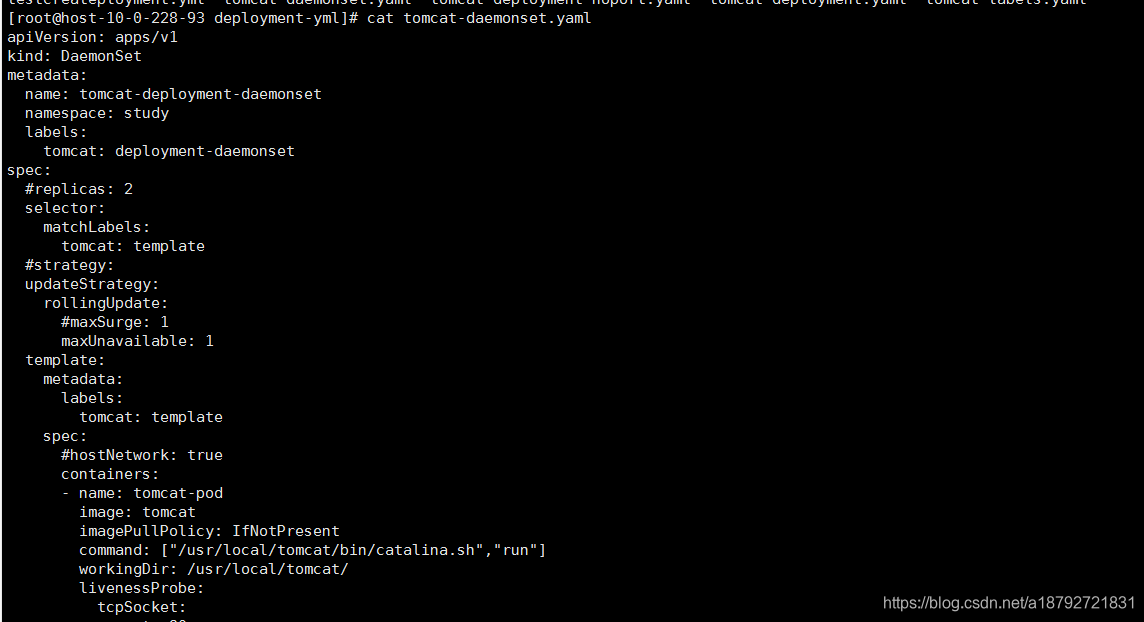
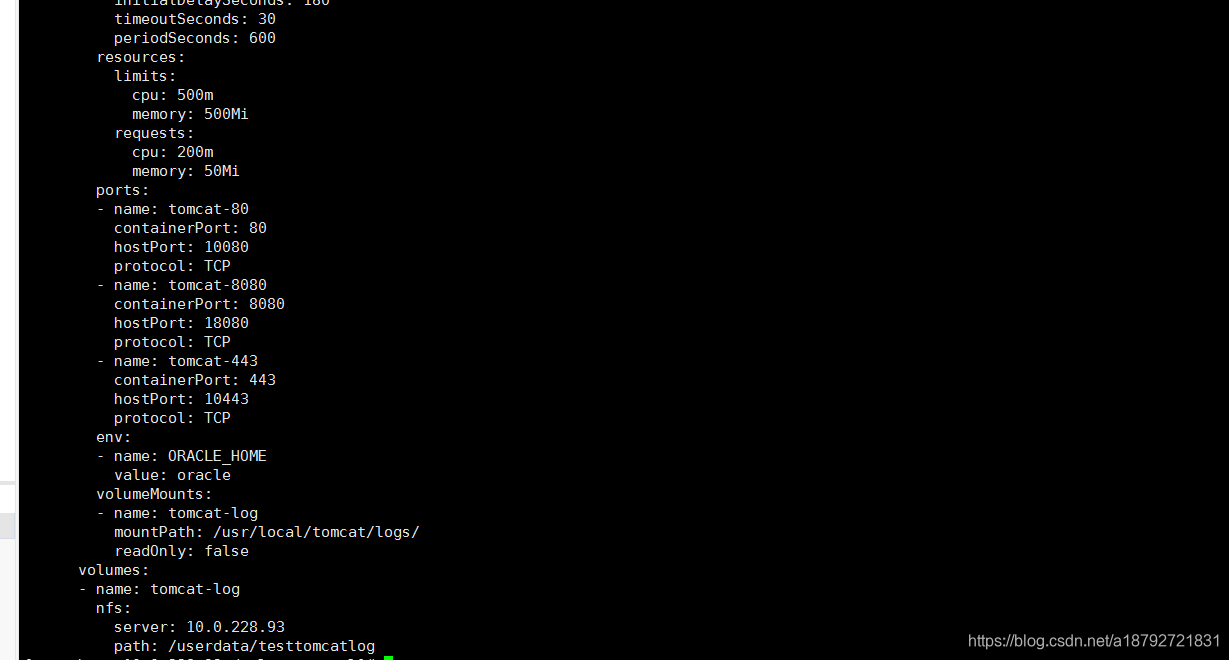
需要改动的地方:
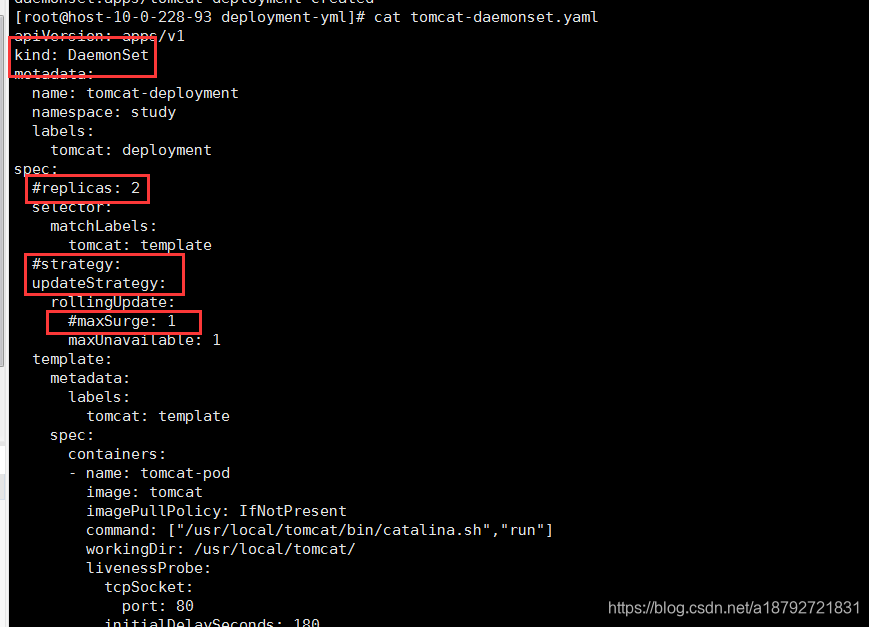



但是为了安全起见,一般master不允许分配用户pod,所以我们增加这个限制:
1
kubectl taint nodes k8s node-role.kubernetes.io/master=true:NoSchedule
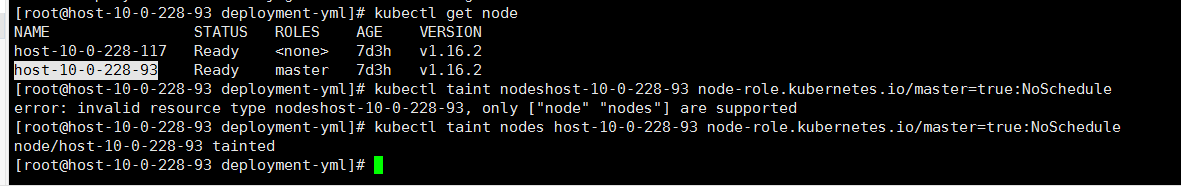
少了一个空格。。。
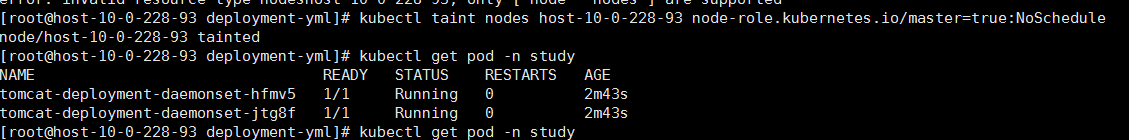
虽然我们限制了master不允许分配pod,分配pod是在创建的时候做的,现在pod已经分配完了,所以我们做个测试:
k8s的高可用,可以重新创建pod用来替换异常pod,那么

我们先删除node节点的pod
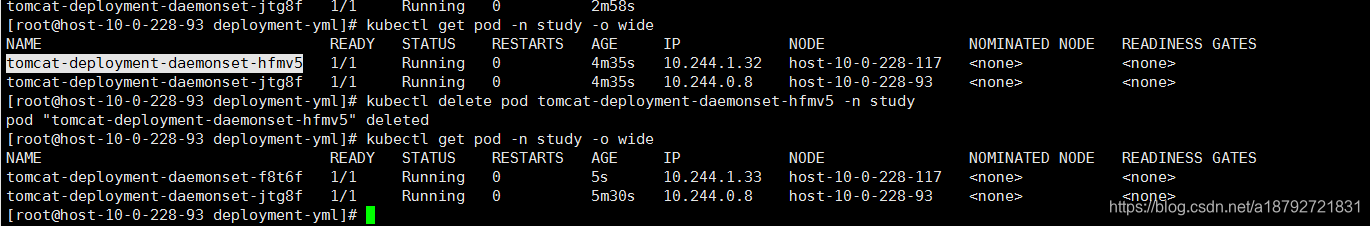
k8s马上又重新创建了一个pod,保证node节点有一个pod
那么master呢?
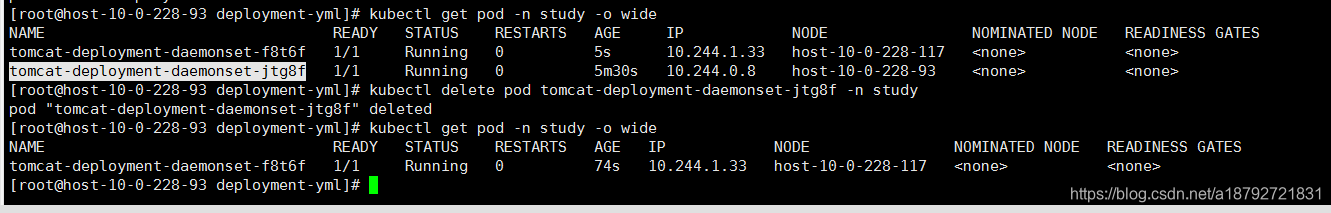
因为master现在不允许分配pod了,所以整个集群里面就只有1个pod了
6.通过标签控制pod的位置
但是有时候我们希望特定的pod运行在特定的node上,通过标签控制pod的位置,pod我们知道,pod可以定义定义自己的标签,但是只pod有标签还不够,为了使得pod的标签和node能够对应,node应该也有自己的标签。
所以,第一步就是给node打标签
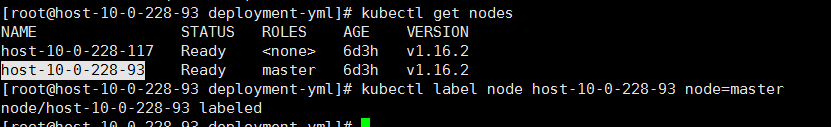
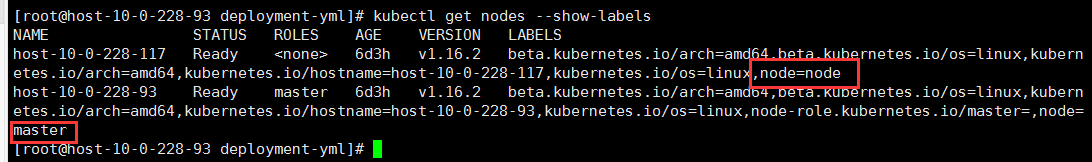
然后拷贝4的yaml文件
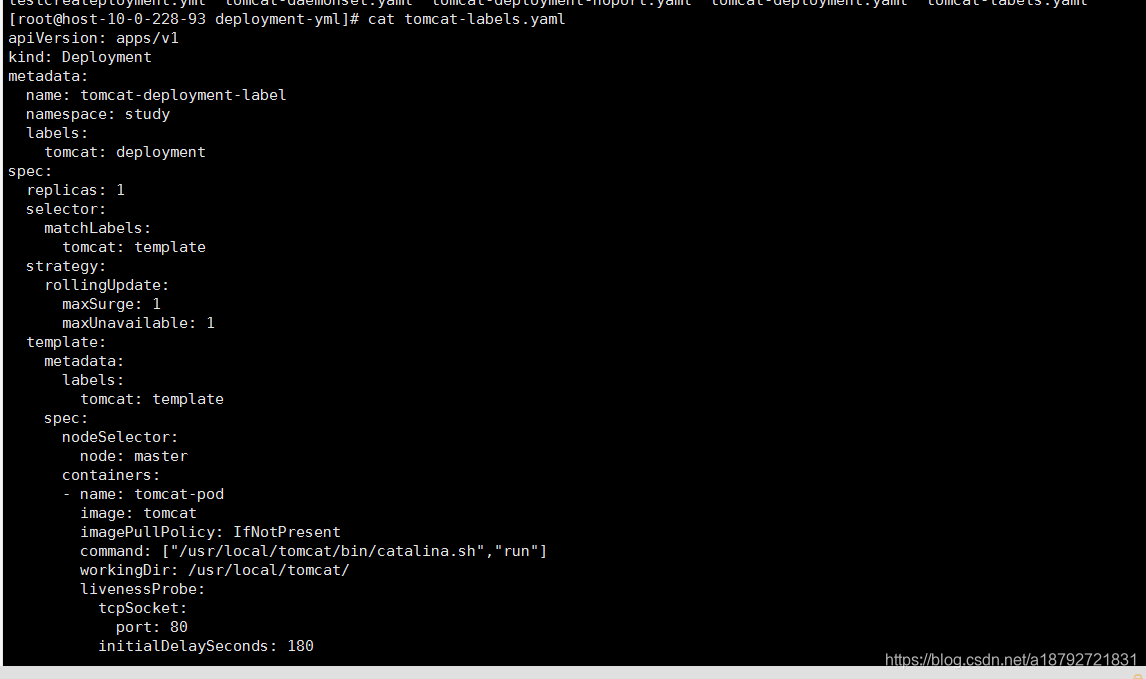
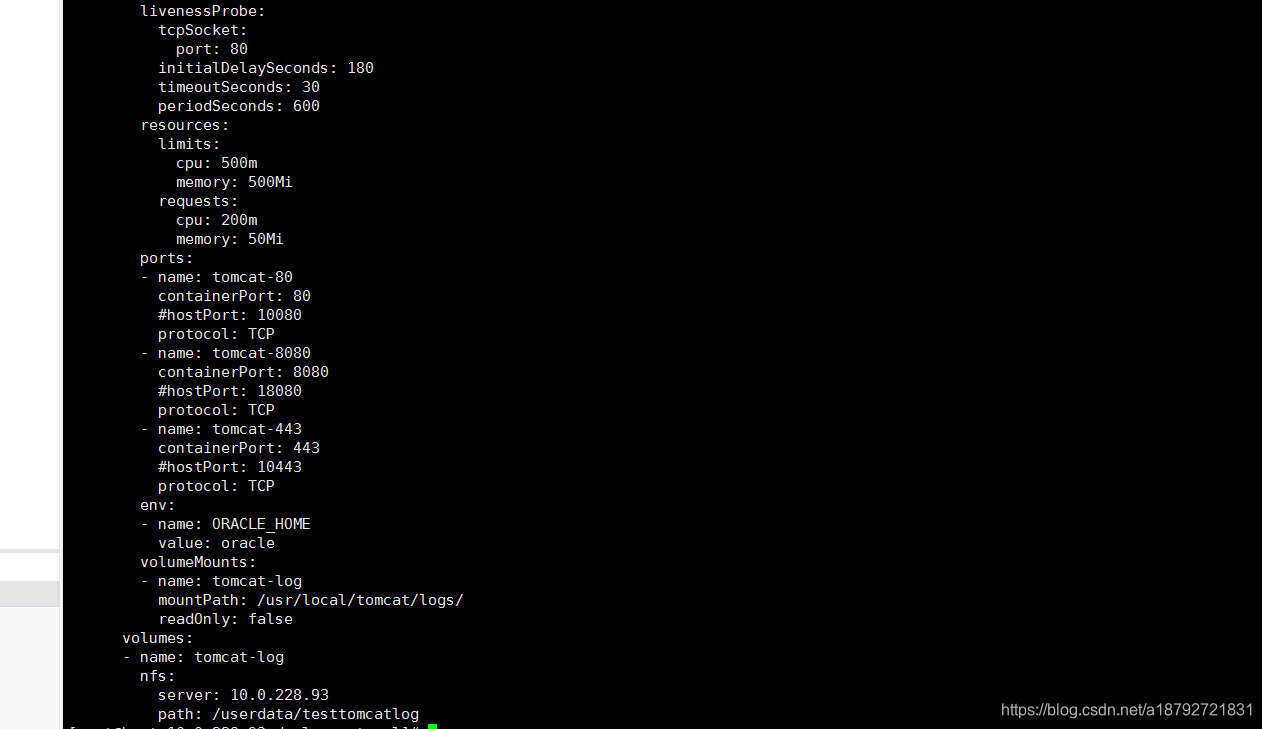
修改其中的设置:
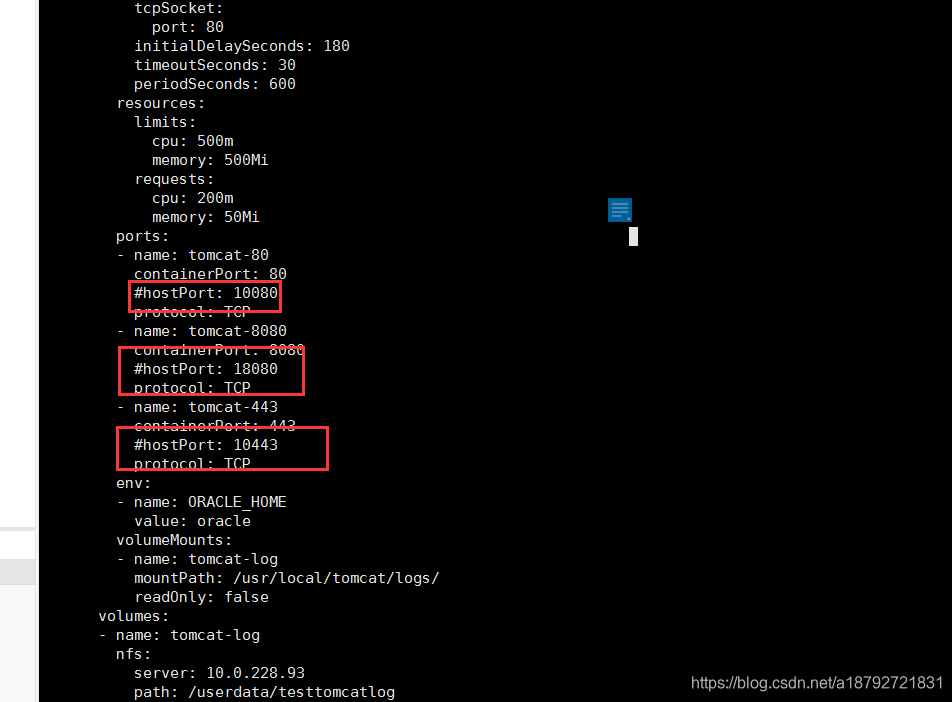
去掉pod的端口映射:
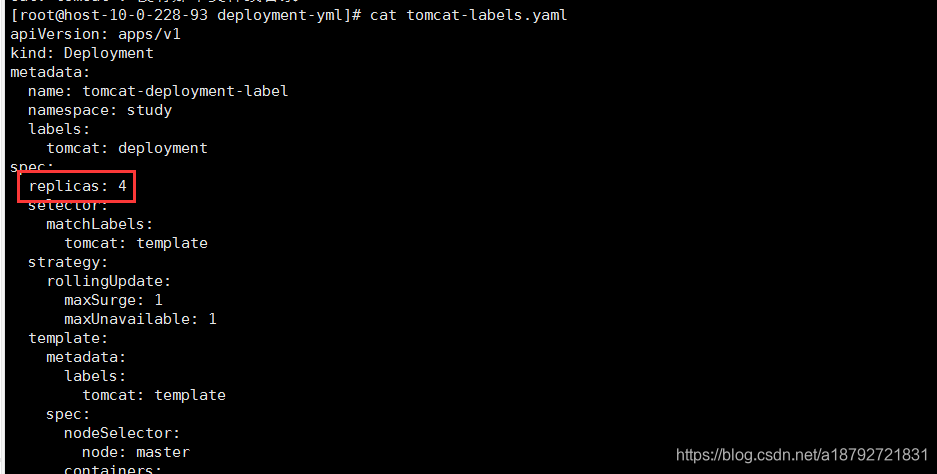
然后设置副本数量为4
暂时先开启master允许分配pod

要求pod必须在master上
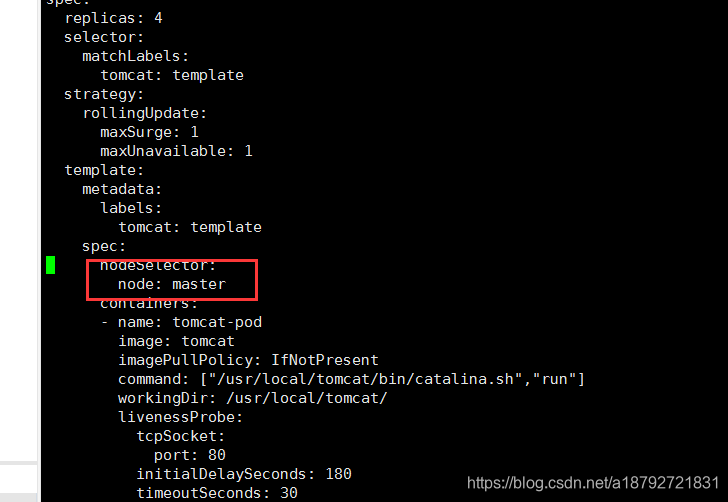
tomcat-label.yaml的完整内容:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
apiVersion: apps/v1
kind: Deployment
metadata:
  name: tomcat-deployment-label
  namespace: study
  labels:
    tomcat: deployment
spec:
  replicas: 4
  selector:
    matchLabels:
      tomcat: template
  strategy:
    rollingUpdate:
      maxSurge: 1
      maxUnavailable: 1
  template:
    metadata:
      labels:
        tomcat: template
    spec:
      nodeSelector:
        node: master
      containers:
      - name: tomcat-pod
        image: tomcat
        imagePullPolicy: IfNotPresent
        command: ["/usr/local/tomcat/bin/catalina.sh","run"]
        workingDir: /usr/local/tomcat/
        livenessProbe:
          tcpSocket:
            port: 80
          initialDelaySeconds: 180
          timeoutSeconds: 30
          periodSeconds: 600
        resources:
          limits:
            cpu: 500m
            memory: 500Mi
          requests:
            cpu: 200m
            memory: 50Mi
        ports:
        - name: tomcat-80
          containerPort: 80
          #hostPort: 10080
          protocol: TCP
        - name: tomcat-8080
          containerPort: 8080
          #hostPort: 18080
          protocol: TCP
        - name: tomcat-443
          containerPort: 443
          #hostPort: 10443
          protocol: TCP
        env:
        - name: ORACLE_HOME
          value: oracle
        volumeMounts:
        - name: tomcat-log
          mountPath: /usr/local/tomcat/logs/
          readOnly: false
      volumes:
      - name: tomcat-log
        nfs:
          server: 10.0.228.93
          path: /userdata/testtomcatlog
接着启动deployment
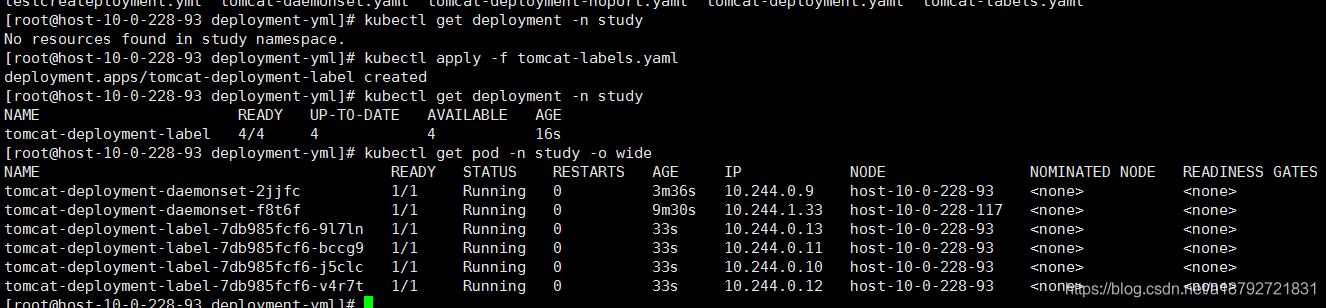
为什么会有这么多呢?
首先tomcat-daemonset就是保证每个节点有一个pod,之前master不允许分配pod,所以master节点上没有这个daemonset的pod,现在允许分配了,所以k8s马上就启动一个pod在master节点上。
而tomcat-deployment-label是因为我们制定pod必须在master的节点上启动。
为什么不会出现端口占用呢?
因为每个pod都是完全独立的,所以就不会存在端口占用的问题了。
那么,我们如何访问这些pod呢?
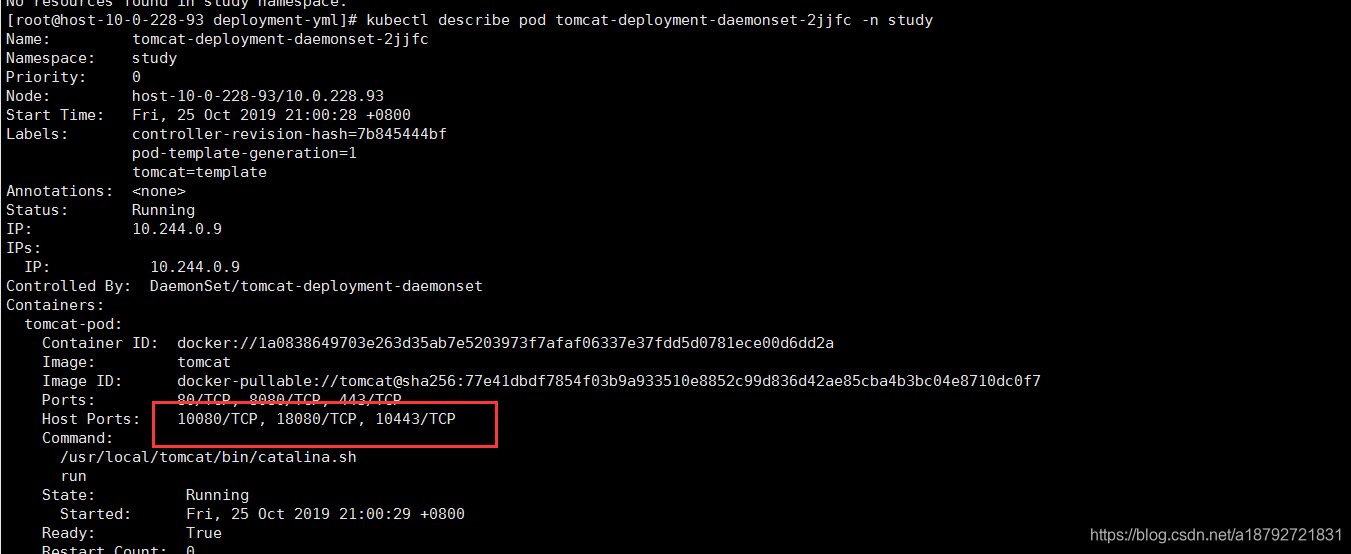
首先:
daemonset的pod是绑定了端口的
但是在内网就这样访问
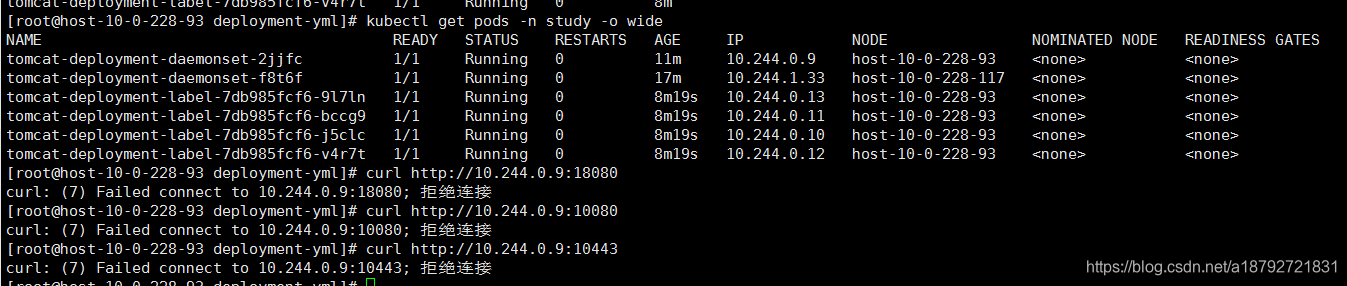
因为现在不是NodePort启动模式,而是ClusterIP的方式,即内网模式。
因为是内网模式,所以在没有使用其他的方式下,无法直接访问pod内的服务。
可以通过k8s的apiserver去访问:
https://masterIP:6443/api/v1/proxy/namespaces/{namespace}/pods/{pod-name}:{pod-port}
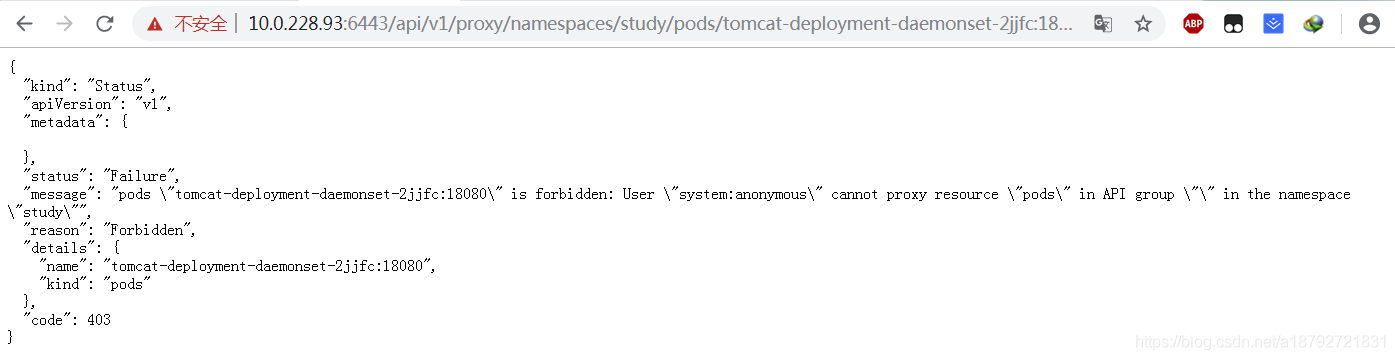
虽然没有成功的访问,但是至少pod能够收到请求,也给我们返回了信息:没有权限?
为了我们外网能够访问,我们需要创建service。
tomcat-service-clusterip.yaml
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
apiVersion: v1
kind: Service
metadata:
  name: tomcat-service
  namespace: study
  labels:
    name: tomcat-service
spec:
  selector:
    tomcat: template
  type: ClusterIP
  ports:
  - name: tomcat-service-8080
    protocol: TCP
    port: 19876
    targetPort: 8080
  - name: tomcat-service-443
    protocol: TCP
    port: 19877
    targetPort: 443
这个表示内网模式的服务,只能内网访问,映射的是19877:443,19876:8080
ok,我们创建这个service
接下来,我们内网访问:
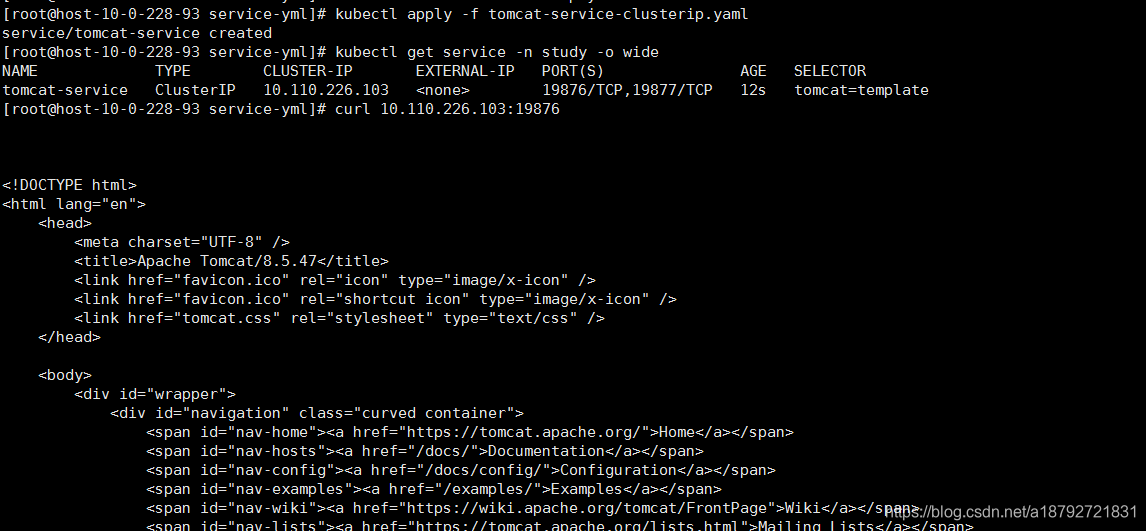
可以看到正确的返回了
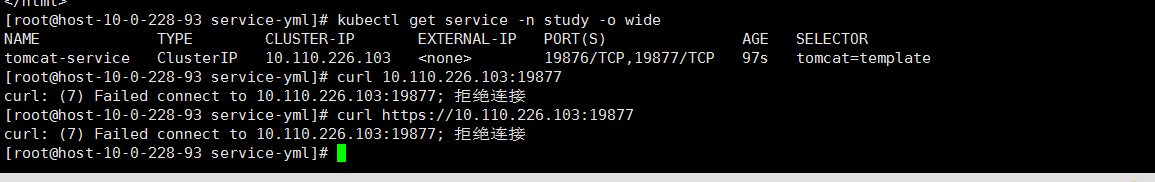
但是https的却拒绝了
到此,daemonset的pod可以正确的返回了。
但是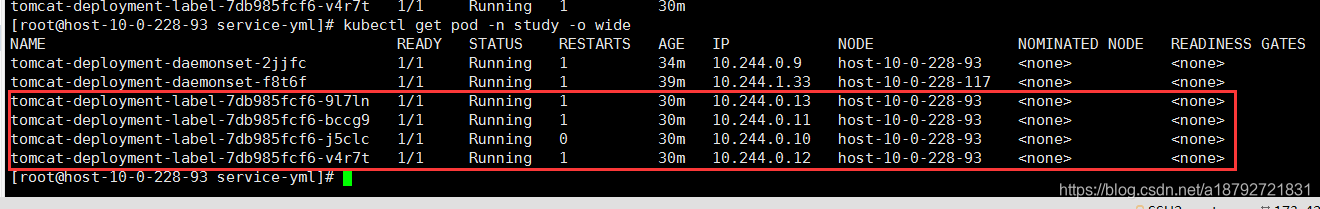
这四个还是无法访问的。。
我们看下这四个pod的label
发现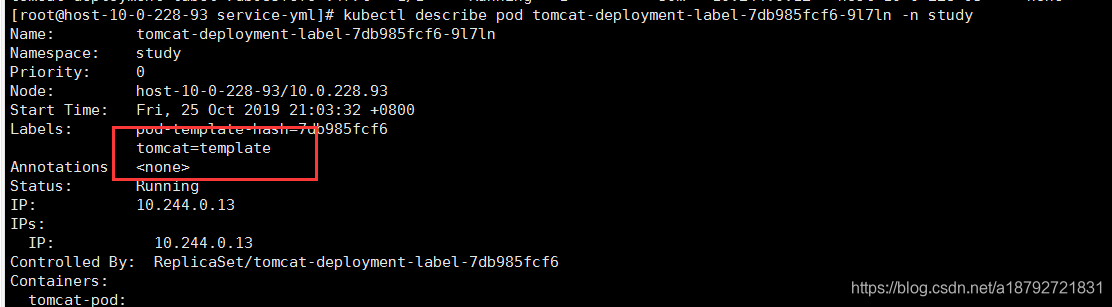
这个label已被service包含了。
也就是说,我们访问服务可能来自这6个服务中的随机的一个
怎么验证呢?
我们删除掉daemonset
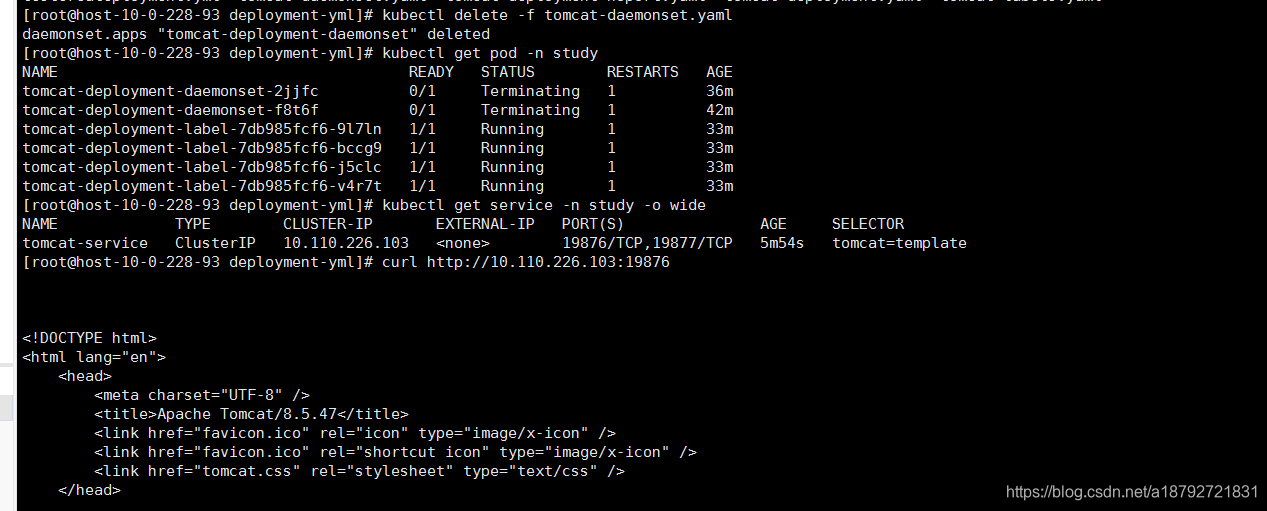
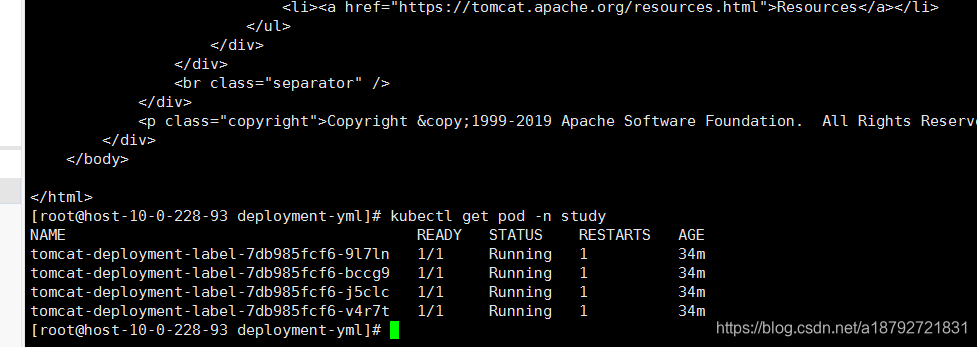
迄今为止,我们剩下了4个pod,都是未绑定节点任何端口的pod,且内网访问没有问题,那么我们该如何在外网访问呢?
在保留内网服务的情况下,创建外网服务:
tomcat-service-nodePort.yaml
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
apiVersion: v1
kind: Service
metadata:
  name: tomcat-service-node
  namespace: study
  labels:
    name: tomcat-service
spec:
  selector:
    tomcat: template
  type: NodePort
  ports:
  - name: tomcat-service-8080
    protocol: TCP
    port: 19876
    targetPort: 8080
    nodePort: 30001
  - name: tomcat-service-443
    protocol: TCP
    port: 19877
    targetPort: 443
    nodePort: 30002
然后启动
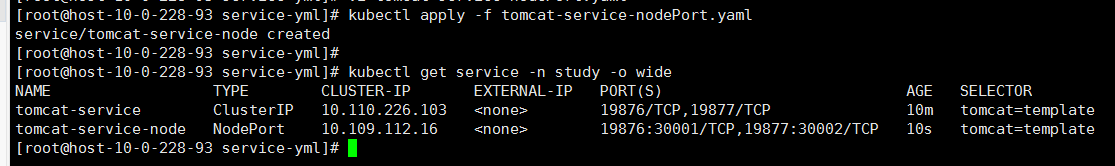
这下呢,内网就通过tomcat-service访问,外网就通过tomcat-service-node访问
试试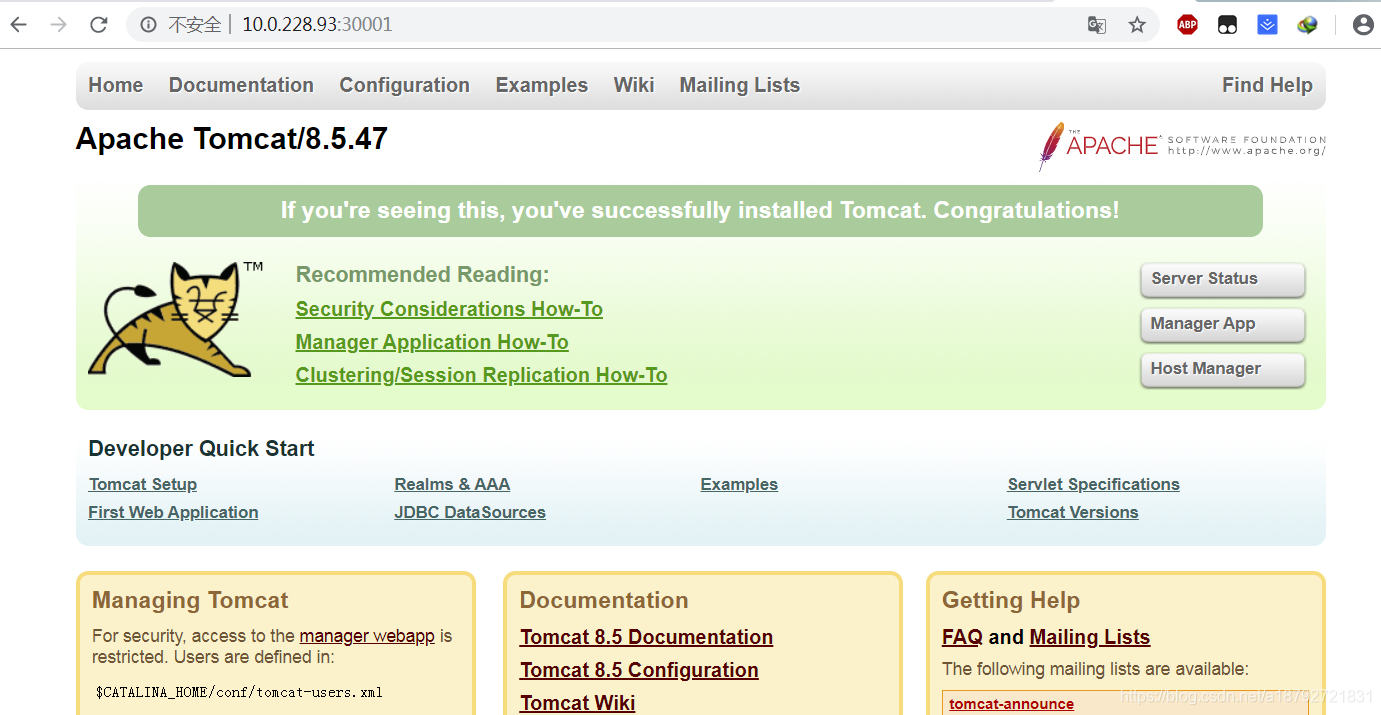
同样的,https还是无法访问
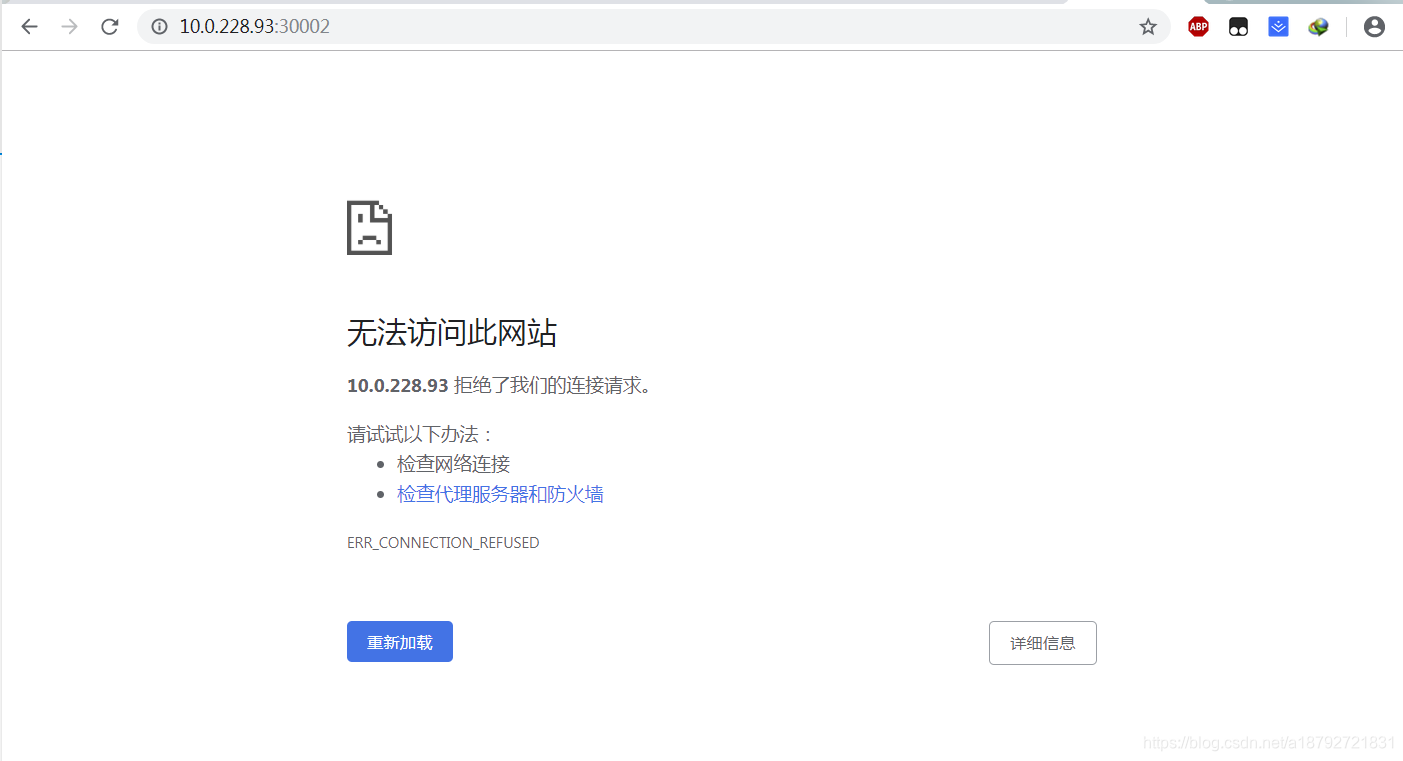
应该和角色、账号等有关吧。
最后一个,验证k8s的高可用,关闭master允许pod
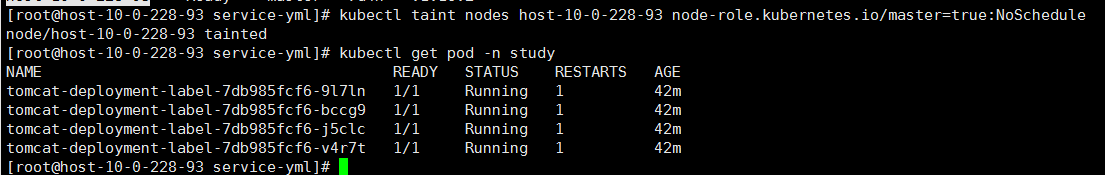
删除一个master的pod
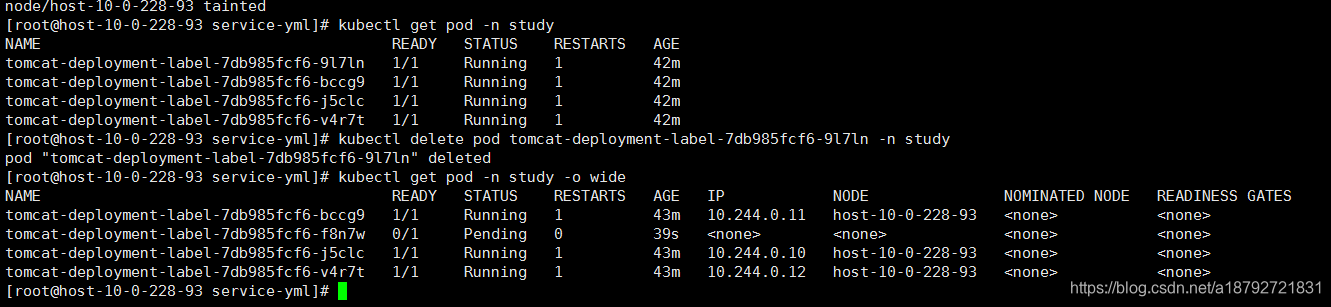
这是因为我们的tomcat-deployment-label中指定pod必须启动在master节点上的原因导致的。
删除这个限制就可以了。
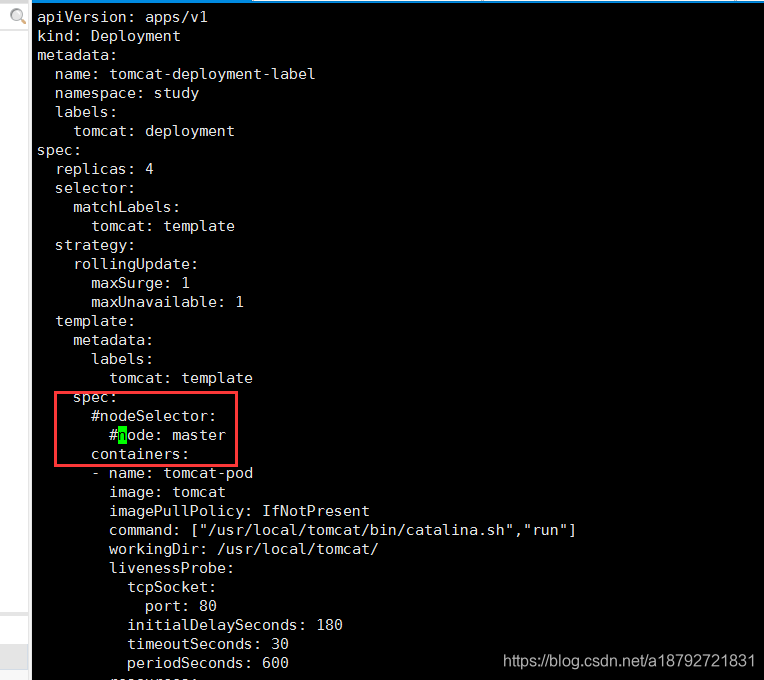
因为我们去掉这个限制,同时不允许master分配,所以在Pod无法重新分配的条件下:
deployment需要在master上运行
而master又禁止分配,
所以k8s不做任何改动,保持启动的pod可用。
当我们去掉deployment的限制后,因为master禁止分配用户pod,所以k8s进行了重新分配:
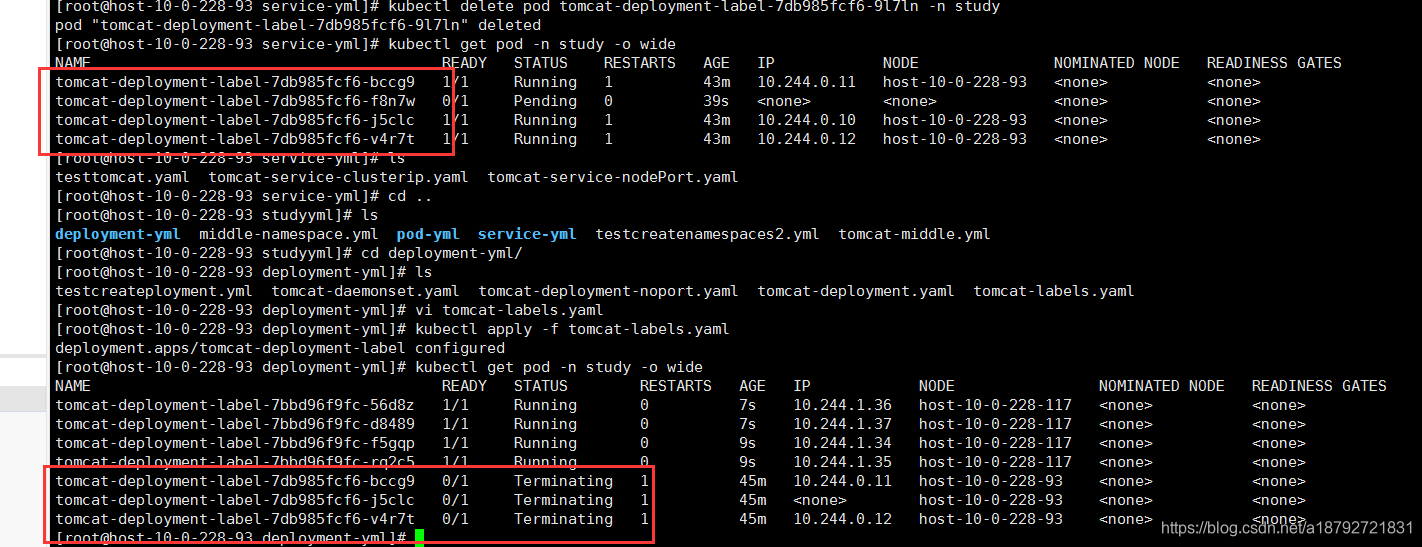
将运行的pod迁移到了符合条件的节点上。
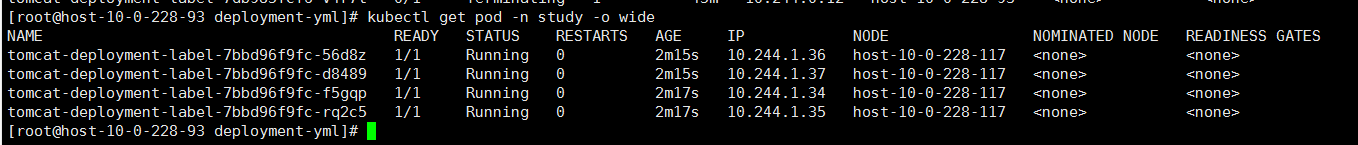
因为我们的pod迁移速度太快,所以没有感觉,根据配置,应该是先启动pod,然后删除pod,即滚动升级,且每次一个
所以在上面第二张图中是有3个停止的。
每次滚动升级的pod数量是1个。