【教程】给AI编程助手装上代码眼睛:serena 与 codebase-memory 双引擎实践
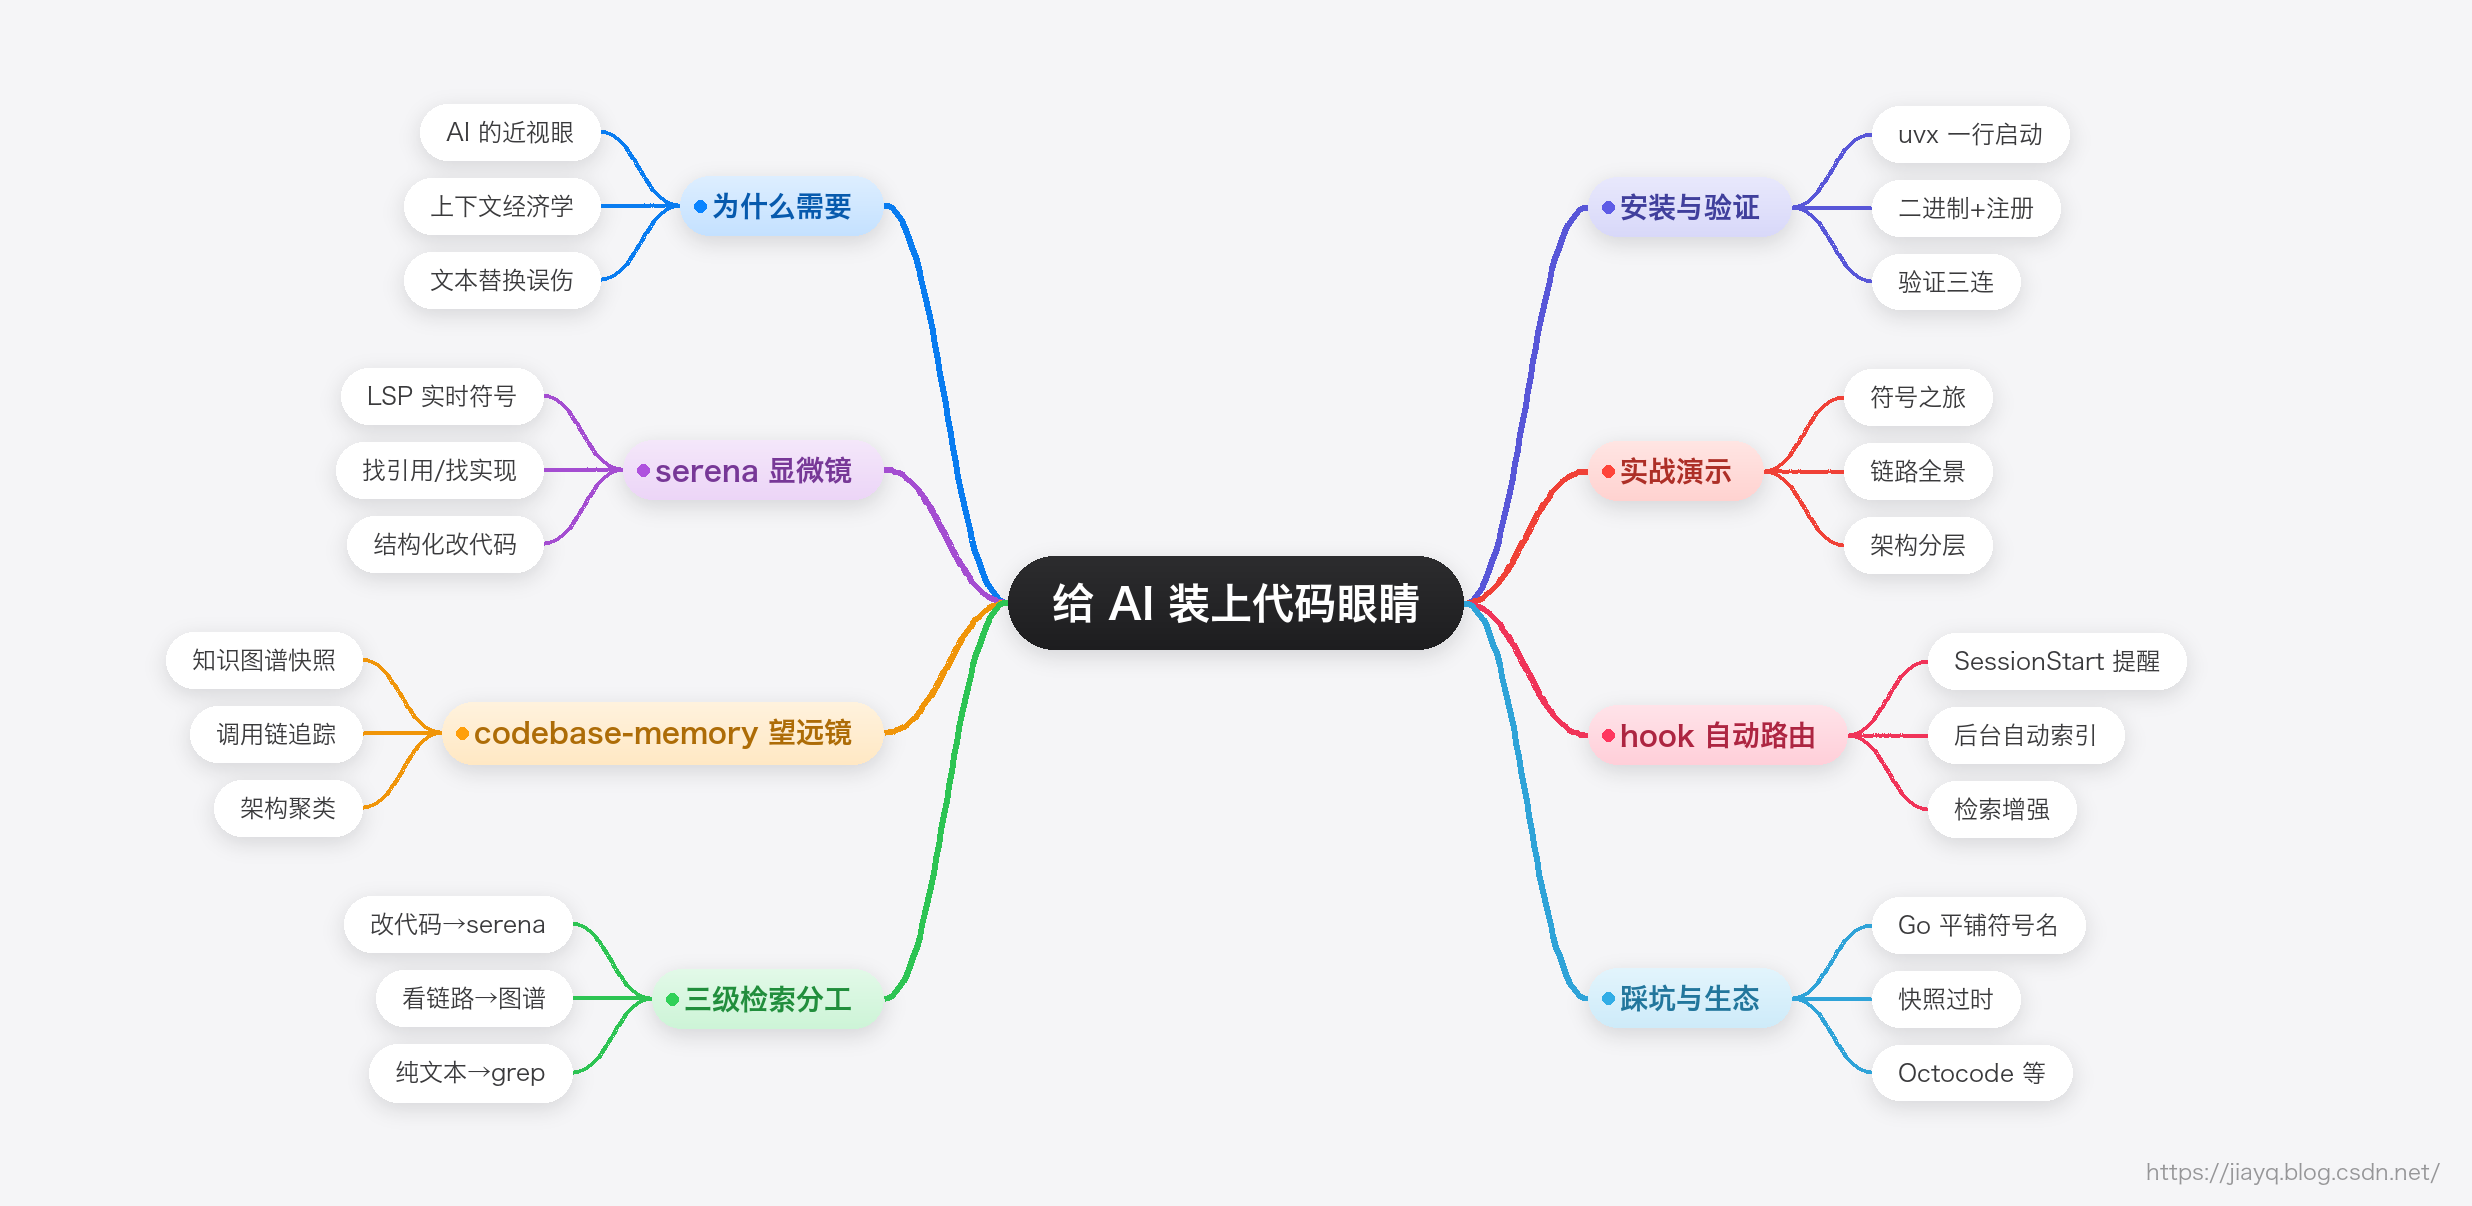
AI 编程助手默认是用 grep看代码的:Read 全文烧上下文,文本匹配分不清调用和注释,Edit 改代码会误伤同名。本文介绍一对 MCP 工具:serena(基于 LSP 的显微镜,符号级读改代码,实时)和 codebase-memory(知识图谱的望远镜,调用链、影响面、架构,全局),以及最重要的三级检索分工规则和 hook 自动路由,让 AI 自己选对引擎。所有工具调用都来自真实演示项目,截图即实录。
文章信息
- 原文链接:https://jiayq.blog.csdn.net/article/details/166483164
- 发布时间:2026-09-23 14:49:41
- 标签:#MCP, #Claude, #AI, #Agent, #coding
【教程】给AI编程助手装上代码眼睛:serena 与 codebase-memory 双引擎实践
摘要
AI 编程助手默认是用 grep”看”代码的:Read 全文烧上下文,文本匹配分不清调用和注释,Edit 改代码会误伤同名。本文介绍我用的一对 MCP 工具:serena(基于 LSP 的显微镜,符号级读改代码,实时)和 codebase-memory(知识图谱的望远镜,调用链/影响面/架构,全局),以及最重要的——三级检索分工规则和 hook 自动路由,让 AI 自己选对引擎。所有工具调用都来自真实演示项目,截图即实录。
1. 为什么 AI 编程助手需要”代码眼睛”
1.0 先看最终效果
先上成品。一个陌生仓库,你问 AI:”谁在调用 Refund?改它会波及哪里?”
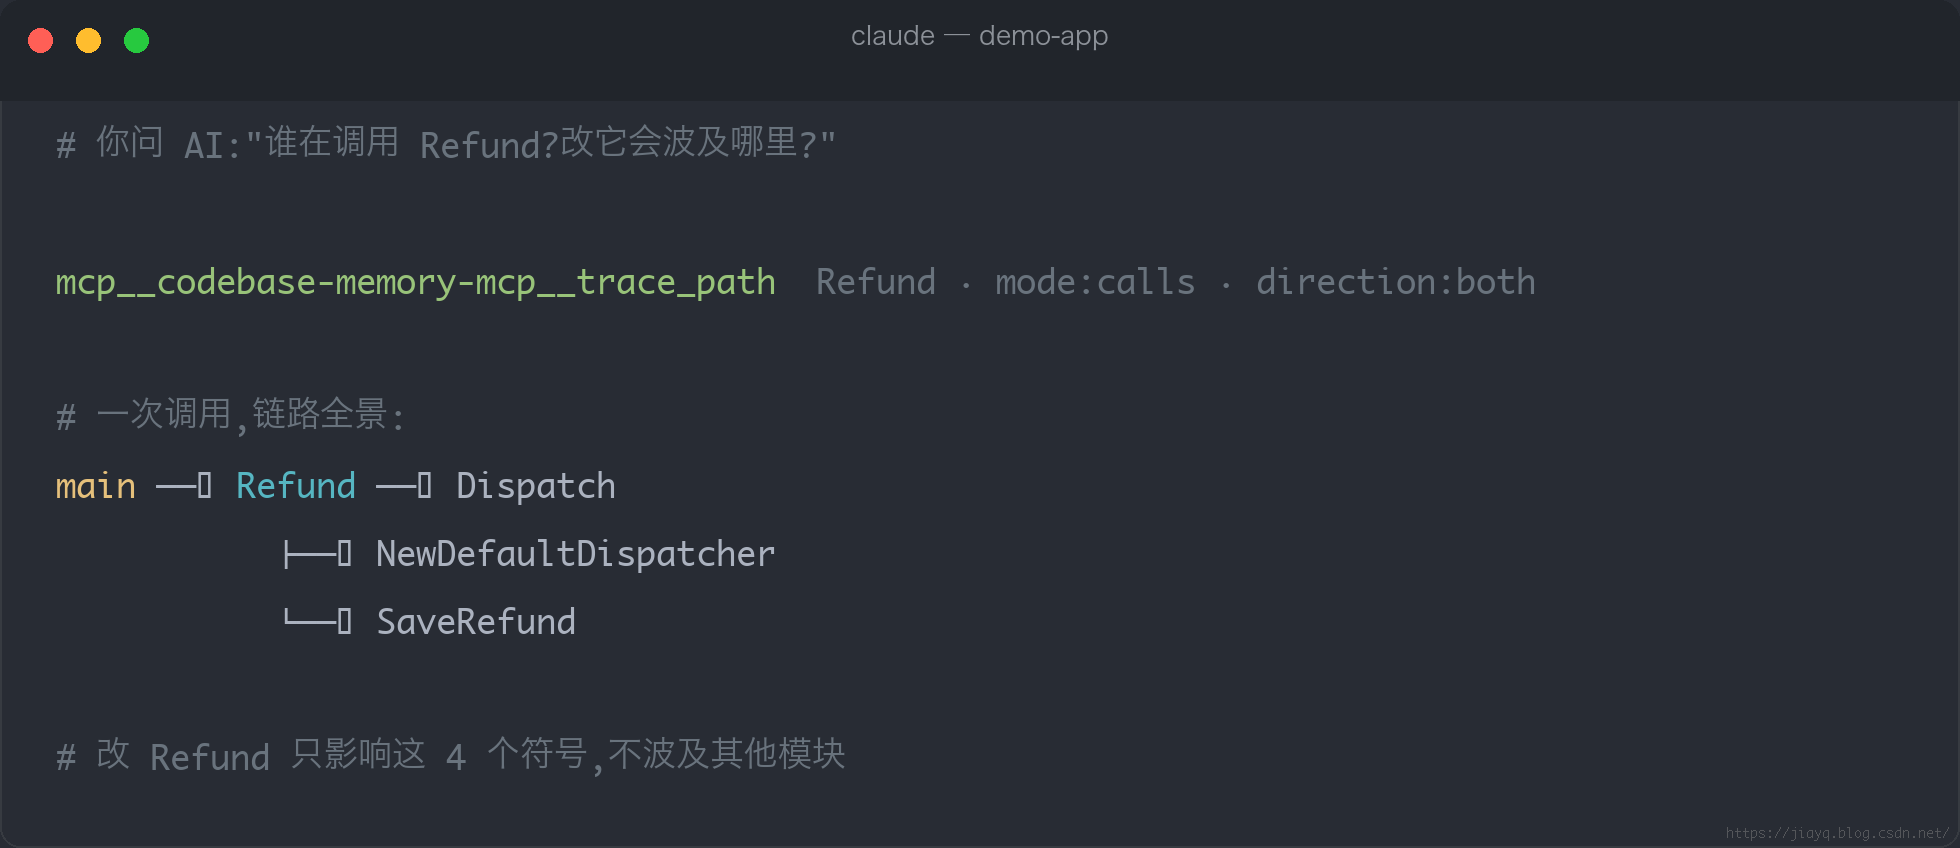
一次工具调用,调用链全景直接回来:main → Refund → Dispatch / SaveRefund。不用打开一个文件,不用 grep 一次,答案就在那。
1.1 没有眼睛的 AI 是什么样
AI 编程助手天生是”近视眼”,它看代码只有三招,每招都有代价:
第一招:Read 全文。 问它一个函数,它把整个文件读进来——一个 800 行的文件,你可能只需要其中 30 行,剩下的 770 行全是上下文噪音,烧的是 token,慢的是对话。
第二招:grep 文本。 问”谁调用了这个函数”,它 grep 函数名,然后你会得到:调用处、注释、日志字符串、同名变量、隔壁模块的同名方法……再人工(或者让 AI)筛一遍。文本匹配不懂代码结构,这是根上的问题。
第三招:Edit 字符串替换。 改代码靠文本匹配替换,工程里最怕的就是这个:Refund 这个词出现在五个地方,只有一处是你要改的,替换错了就是事故。
这三招的本质是:AI 拿着代码当纯文本,而不是结构化的符号系统。人类工程师有 IDE——跳定义、找引用、看调用层级、重构改名一键全仓更新。AI 凭什么用裸 grep?
给它装上”眼睛”,就是让 AI 也获得 IDE 级(甚至更强)的代码理解能力。我的方案是双引擎:一台显微镜加一台望远镜。
2. 双引擎:serena 与 codebase-memory
2.1 serena:显微镜(LSP 实时)
serena 是基于 LSP(语言服务器协议) 的 MCP server。语言服务器(gopls、jdt-ls 这类)本来就存在,IDE 的跳定义/找引用全靠它——serena 把这套能力开放给 AI,再配上结构化编辑:
| 能力 | 工具 | 干什么 |
|---|---|---|
| 读 | get_symbols_overview | 列出文件全部符号,新接手一个文件的第一步 |
| 读 | find_symbol(include_body) | 按符号名直达函数体,不带全文 |
| 查 | find_referencing_symbols | 谁引用了它(带上下文片段) |
| 查 | find_implementations / find_declaration | 接口找实现、引用找声明 |
| 改 | replace_symbol_body | 整符号替换,精准到函数边界 |
| 改 | rename_symbol | 跨文件重命名,引用全同步 |
| 改 | replace_content / replace_in_files | 正则/字面量替换,支持 dry-run 批量预览 |
它最大的特点是实时:LSP 直连语言服务器,代码一改,下一次查询立即可见,没有”索引”这个步骤。SolidLSP 支持按需下载各语言服务器,Go/Java/Python/TS 主流语言都覆盖。
2.2 codebase-memory:望远镜(知识图谱快照)
codebase-memory-mcp 是另一种思路:把整个仓库索引成知识图谱——函数/类/接口是节点,调用/实现/引用是边,存进本地图数据库,然后随便查:
| 能力 | 工具 | 干什么 |
|---|---|---|
| 索引 | index_repository | 仓库建图(fast/moderate/full 三档) |
| 查 | search_graph / search_code | 按符号名/正则搜,结果按”定义>热门>测试”排序 |
| 读 | get_code_snippet | 按 qualified_name 精确取源码 |
| 链路 | trace_path | 追调用链/数据流/跨服务调用 |
| 图 | query_graph | 直接跑 Cypher,多跳模式的唯一解 |
| 架构 | get_architecture | 包依赖、分层、Leiden 社区聚类、热点函数 |
| 影响 | detect_changes | 对比基线,输出变更影响范围 |
它是快照型的:索引一次,查询毫秒级;代价是代码变更后图不会自己更新,要重跑索引(或用 detect_changes 先看影响)。
2.3 一张表看懂互补
| 维度 | serena | codebase-memory |
|---|---|---|
| 数据模型 | LSP 符号表(实时) | 知识图谱(快照) |
| 新鲜度 | 代码一改即生效 | 需重索引 |
| 擅长 | 读/改单个符号 | 全局链路、影响面、架构 |
| 查询形态 | 按符号名直达 | 图遍历 / Cypher |
| 使用成本 | 每次实时解析 | 一次索引反复查询 |
一句话:serena 是显微镜,codebase-memory 是望远镜。改代码用前者,看结构用后者。只装一个行不行?只装 serena,跨文件影响面要一个个跳着查;只装 codebase-memory,改代码缺实时性。所以我两个都装。
3. 三级检索分工
工具装了,下一个问题是:AI 怎么知道什么时候用哪个?靠规则。我在 CLAUDE.md 里写死了一条分工:
1
2
3
4
## 代码检索三级分工
- 符号级查询(看符号/查定义/读实现/找引用)与改代码 → serena
- 链路/调用关系/影响面/架构分析 → codebase-memory
- 纯文本/文件名匹配 → grep/glob
就三行,但它是整套体系的”宪法”。grep 并没有被淘汰——查一个字符串字面量、找一个配置文件,grep 依然是最快的;被淘汰的是”用 grep 回答结构问题”。
这条规则有个隐藏收益:上下文省钱。以前 AI 找一个函数要 Read 三个文件,现在一次 find_symbol 只回函数体本身,一来一回,省的都是 token。
4. 安装与验证
两个工具的安装详情(依赖、配置、坑)都在我的 Agent 工具箱里各有一份 README,这里给最短路径。
4.1 serena
依赖只要一个 uv(现代 Python 包管理器),语言服务器首次使用时自动下载。注册进 Claude Code 的 settings.json:
1
2
3
4
5
6
7
8
9
10
11
{
  "mcpServers": {
    "serena": {
      "command": "uvx",
      "args": [
        "--from", "git+https://github.com/oraios/serena",
        "serena", "start-mcp-server", "--context", "ide-assistant"
      ]
    }
  }
}
--context ide-assistant 必须带:它裁剪工具集并注入使用手册,是给 AI 编程助手的推荐姿势(上游文档同款建议)。
4.2 codebase-memory
二进制发行(约 260MB,内嵌多语言解析器,本机实测 0.8.1),从上游 release 下载放进 PATH,注册:
1
2
3
4
5
6
7
8
{
  "mcpServers": {
    "codebase-memory-mcp": {
      "command": "/Users/<你>/.local/bin/codebase-memory-mcp",
      "timeout": 60000
    }
  }
}
4.3 验证三连
装完连发三问,有响应即通:get_current_config(serena 当前项目)、list_projects(cbm 已索引列表)、任选一个文件 get_symbols_overview。
5. 实战:一个支付模块的检索之旅
以下全部实录。演示项目是我写的一个小 Go 仓库:main 调用 PaymentService.Refund,内部经过 Dispatcher 接口分发,最后 RefundRepo.SaveRefund 落库——麻雀虽小,接口、实现、调用链、分层全都有。
5.1 serena:读符号、找调用、改代码
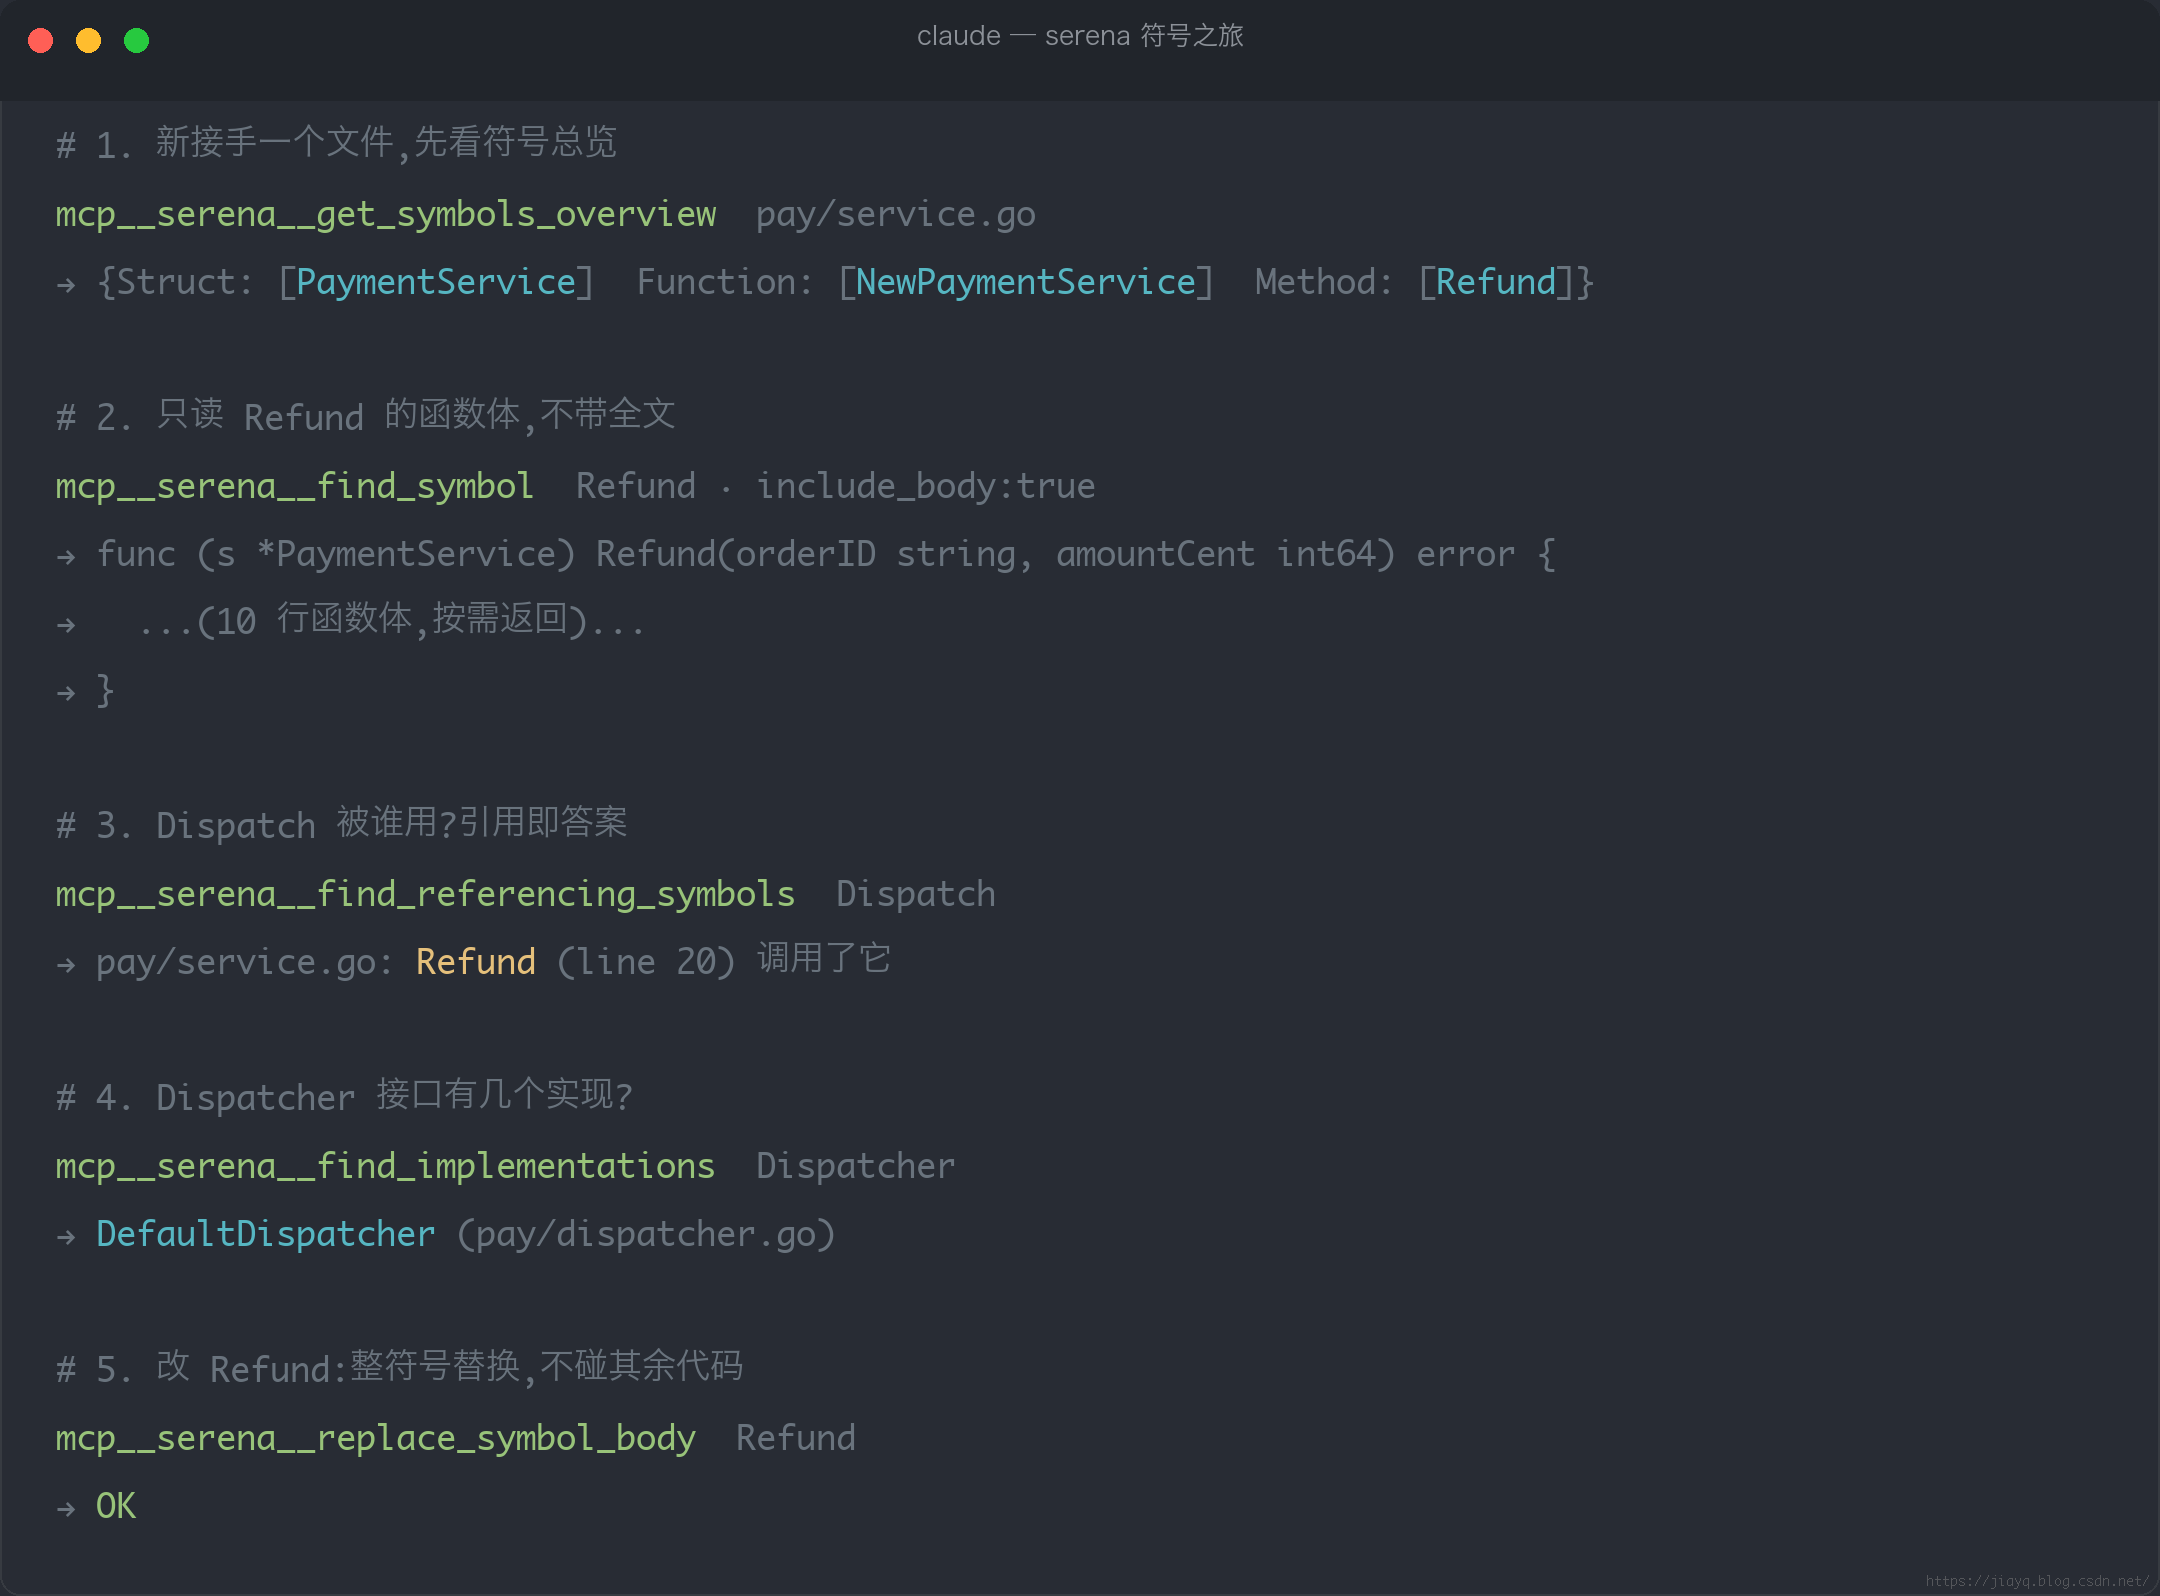
五个动作串起来就是一次日常的代码理解:
- 新接手文件:
get_symbols_overview扫一眼,{Struct: PaymentService, Function: NewPaymentService, Method: Refund},这个文件有什么一目了然,一行废话没读; - 读实现:
find_symbol Refund · include_body:true,只回这个函数的 10 行,不带全文件; - 找调用方:
find_referencing_symbols Dispatch,答案带文件带行号——pay/service.go: Refund (line 20) 调用了它; - 接口找实现:
find_implementations Dispatcher→DefaultDispatcher,接口有几个实现一眼看清; - 改代码:
replace_symbol_body整符号替换,我实测给它插入了一行审计日志 TODO,精准落在函数体内,其余代码分毫未动。
对比一下第 3 步:同样的答案,grep 版本要搜 “Dispatch”、过滤掉接口声明和注释、再拼出行号——AI 干三轮,还可能漏。
5.2 codebase-memory:索引、追链路、看架构
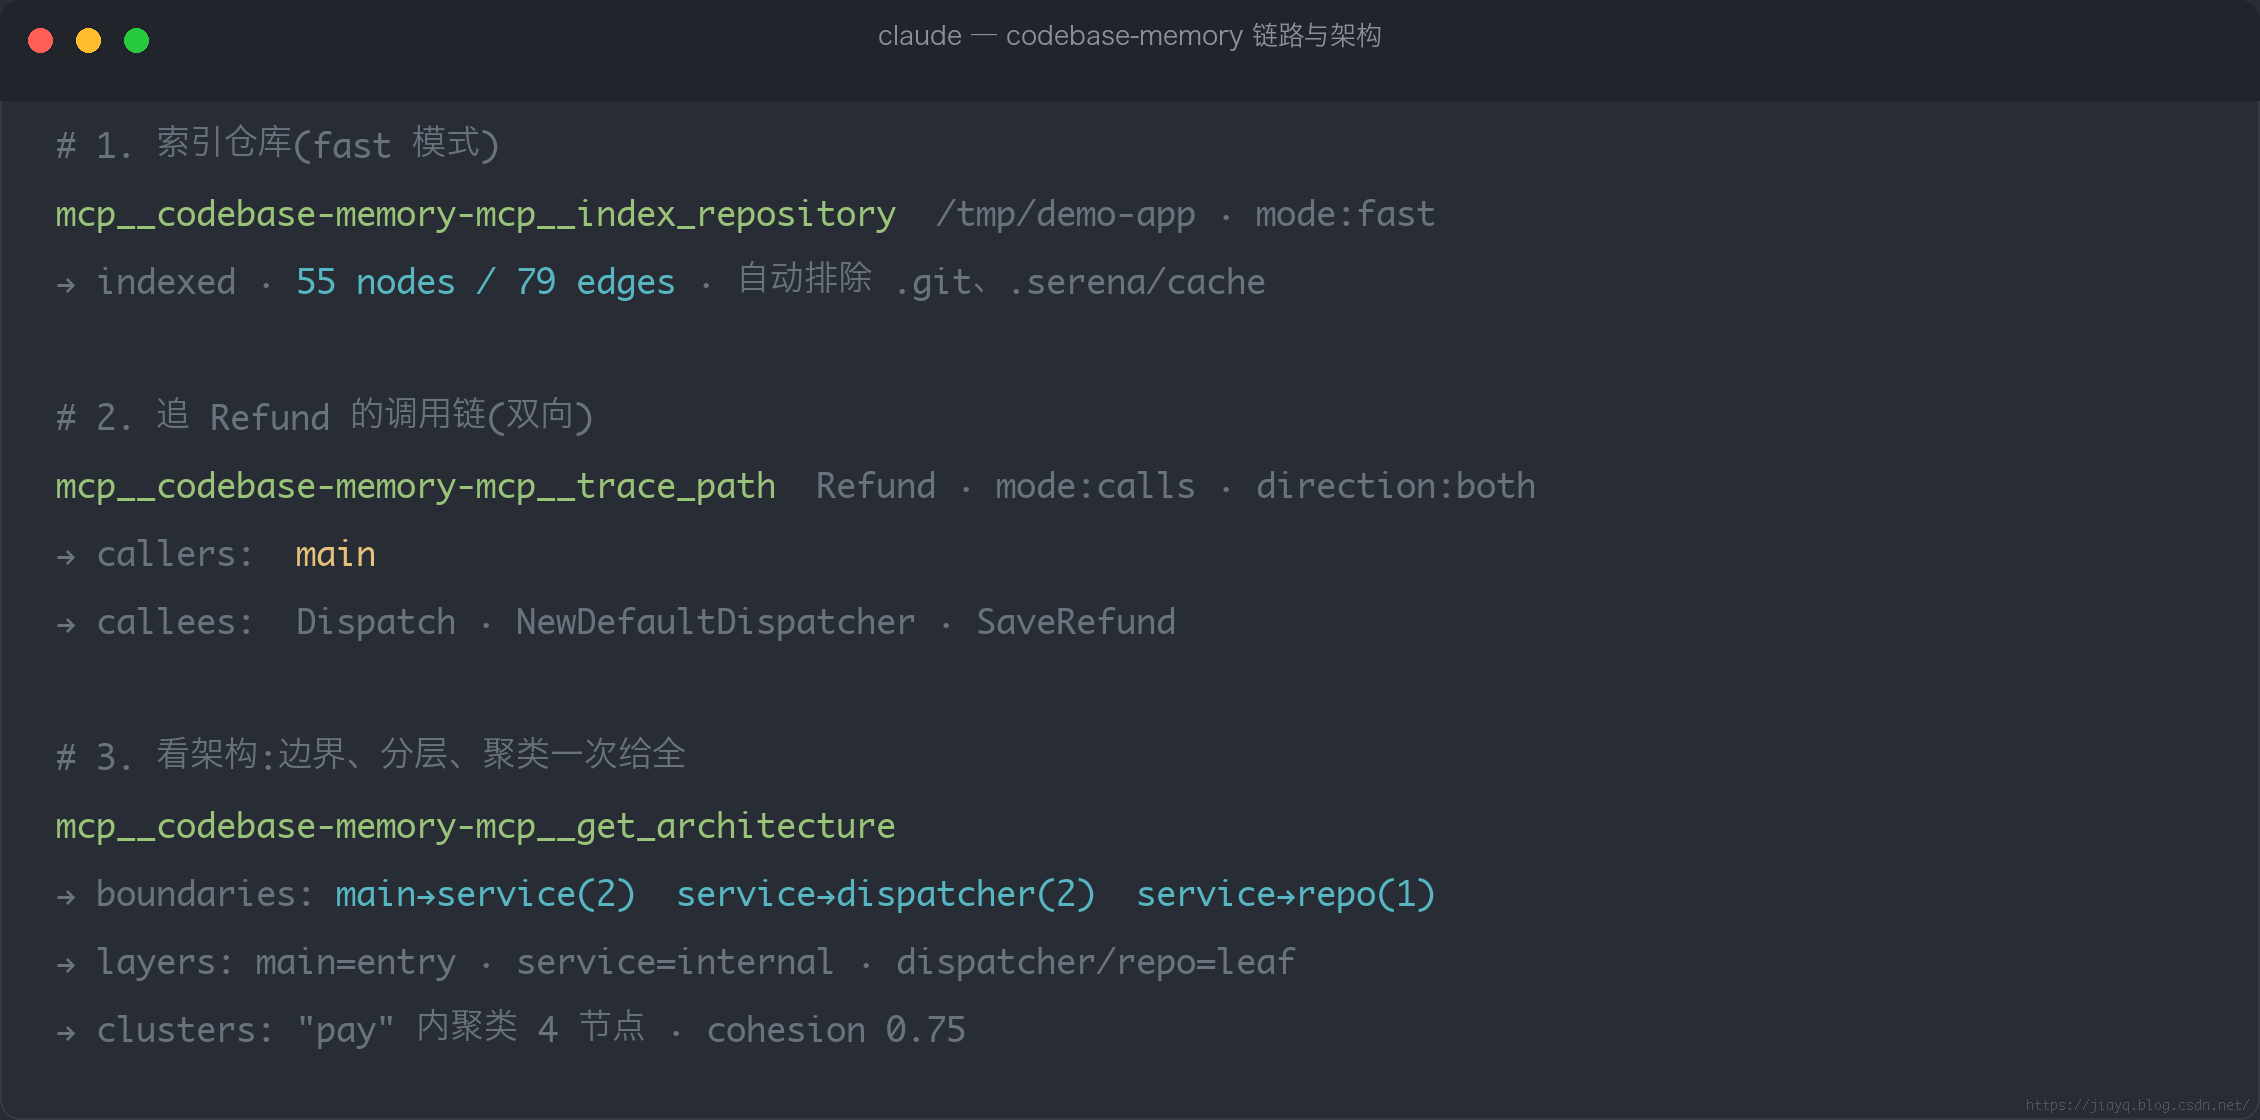
显微镜看完局部,换望远镜看全局:
- 索引:
index_repository mode:fast→ 55 nodes / 79 edges。注意细节:它自动排除了.git和.serena/cache——两个工具在同一仓库里同居,互不污染; - 追链路:
trace_path Refund · calls · direction:both→ callers 是main,callees 是Dispatch / NewDefaultDispatcher / SaveRefund。这就是 1.0 节那张图; - 看架构:
get_architecture一次给全——边界(main→service(2) service→dispatcher(2) service→repo(1))、分层(main=entry,service=internal,dispatcher/repo=leaf)、聚类(“pay” 内聚 0.75)。
第 3 步值得多说一句:新接手一个几万行的仓库,get_architecture 先看聚类和模块边界,比翻半天目录结构快得多——入口在哪、哪些是叶子模块、谁是热点函数,一张报告全出来。
6. 进阶:让 AI 自动选对引擎
到这里,工具和规则都齐了,但还差一环:AI 会不会忘了用? 每个会话开始时,AI 是一张白纸,不记得这仓库索引过没有、serena 激活没激活。我的解法是三个本地 hook,把”选引擎”自动化:
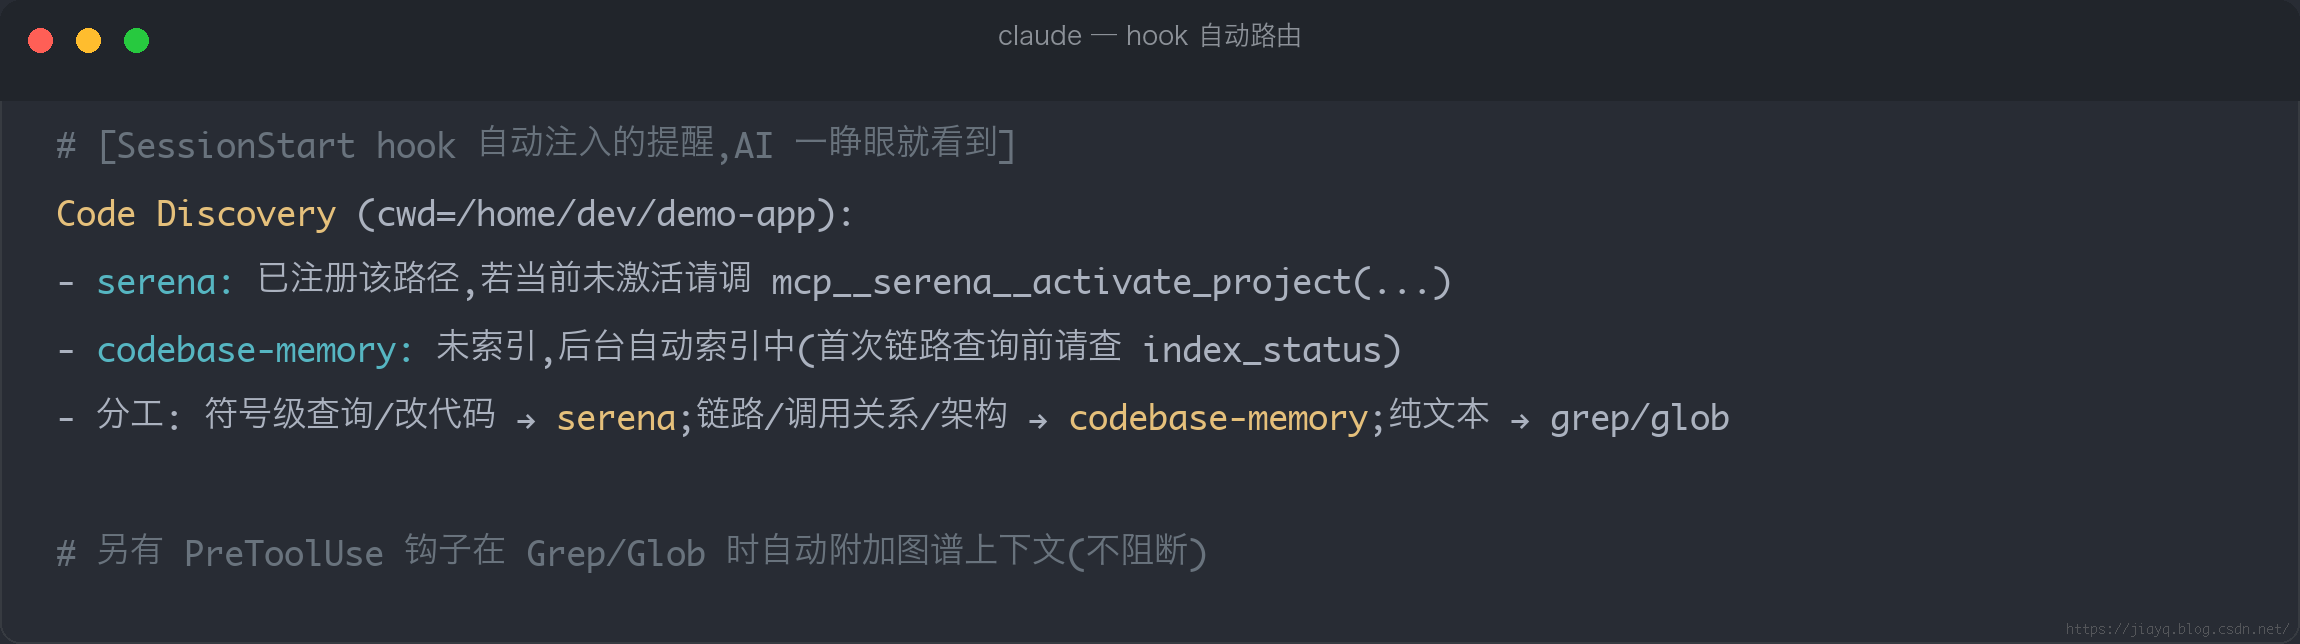
三件套:
- SessionStart 提醒:会话启动时,一个 hook 脚本检测当前仓库的 serena 注册状态和 codebase-memory 索引状态,把针对性提醒注入 AI 上下文——注册了没激活就提示激活,没索引就自动触发后台索引并提示”首次链路查询前先查 index_status”;
- 后台索引:未索引的仓库,
nohup挂一个 fast 模式索引任务,建 marker 文件防止重复索引,不阻塞会话启动; - 检索增强:PreToolUse 钩子挂在 Grep/Glob 上,AI 每次用 grep 搜代码时,自动附加图谱上下文(只增强,永不阻断——失败也静默)。
效果是:AI 不需要”记得”用哪个引擎,它一睁眼就知道这个仓库的引擎状态和分工规则。这和状态栏那篇(见相关阅读)是同一个思路——不要指望 AI 自觉,把期望变成环境的一部分。
成本几乎为零:三个 hook 都是本地脚本,注入的提醒只有几行文本。
7. 踩坑与生态位
7.1 踩坑实录
写这篇博客跑演示时,我自己就把坑踩了一遍:
- Go 符名用平铺名:
find_symbol用PaymentService/Refund这种类路径写法查不到,直接用Refund就行——Go 的方法在符号表里是顶级符号; - LSP 冷启动:激活项目后立刻
find_symbol,返回空。语言服务器在预热,等几秒重试就好,预热后毫秒级; - serena 一次只有一个激活项目:多仓库并行记得
activate_project切换,忘了切会在错误的仓库里找不到符号; - 快照会过时:codebase-memory 的图不会自己更新,代码改完要重跑
index_repository,或者先detect_changes看影响——忘了会查到旧链路; - Cypher 有 10 万行上限:宽查询自己在语句里加
LIMIT,或改用search_graph分页。
7.2 生态位
代码智能这个方向,两个引擎各代表一条路线,也各有同路人:serena 是 LSP 派的开源代表;图谱派除了本文的 codebase-memory,还有商业化的 Octocode(Graph + Search + LSP 三合一),社区里 codescout、sense 这类小项目也在生长。闭源阵营里,Cursor 和 Copilot 内置了私有索引,不开 MCP。
选型逻辑和状态栏那篇一样:闭源内建的舒适,开源自组的自由。我的组合胜在两级互补 + 全套规则和 hook 托管在Agent 工具箱,换一台机器,十分钟复刻。
总结
回头看这套体系:serena 和 codebase-memory 各管一段,一个实时一个全局,中间用三级分工规则缝合,再用 hook 把”记得用”变成”自动用”。AI 从裸 grep 的近视眼,变成了手持显微镜和望远镜的工程师。
我自己感受最深的是第 6 节那一步。装工具不难,写分工规则不难,难的是承认一个事实:规则写在 CLAUDE.md 里,AI 也会忘。把规则变成 hook、变成启动提醒、变成检索增强,环境替 AI 记住了一切——工具是死的,环境设计是活的。
这套东西还能往前走:索引的按需自动触发、detect_changes 接进提交流程、甚至用图谱给 AI 生成”改动影响清单”。做了再写。
参考资料
- 我的 Agent 工具箱(serena 与 codebase-memory 的完整安装使用指南)
- serena 官方仓库
- codebase-memory-mcp 官方仓库
- Octocode(图谱派商业化代表)
相关阅读
- 【教程】打造Agent状态栏:给AI编程助手装上仪表盘(同系列上一篇:状态栏让 AI 的状态可见,双引擎让 AI 看得见代码)
版权声明:本文为博主原创文章,遵循 CC 4.0 BY-SA 版权协议,转载请附上原文出处链接和本声明。
原文出处:贾永琪的博客