MySQL 数据迁移(一)为什么迁、怎么迁、怎么评——三大方案总览
MySQL 到 MySQL 的数据迁移是每个 DBA 和后端开发绕不开的课题。本篇是这个系列的开篇,先把三个问题讲透:为什么要迁移、迁移有哪些方案、怎么科学地评测一个迁移方案。后续三篇将分别实战三种方案:原生 mysqldump、多线程 mydumper/myloader、物理数据文件迁移,全部基于真实环境压测数据说话。
文章信息
- 原文链接:https://jiayq.blog.csdn.net/article/details/166593341
- 发布时间:2026-09-24 15:01:49
- 标签:#mysql, #数据库, #mysqldump, #mydumper, #myloader, #DTS
MySQL 数据迁移(一)为什么迁、怎么迁、怎么评——三大方案总览
摘要
MySQL 到 MySQL 的数据迁移是每个 DBA 和后端开发绕不开的课题。本篇是这个系列的开篇,先把三个问题讲透:为什么要迁移、迁移有哪些方案、怎么科学地评测一个迁移方案。后续三篇将分别实战三种方案:原生 mysqldump、多线程 mydumper/myloader、物理数据文件迁移,全部基于真实环境压测数据说话。
1. 为什么要做 MySQL 到 MySQL 的数据迁移
有人会问:都是 MySQL,直接把程序连接串一改不就行了?哪有那么简单。数据不会自己长脚走到另一台机器上,只要数据库实例换了,数据就得搬。真实场景中,MySQL 到 MySQL 的迁移需求远比想象中常见。
1.1 真实的迁移场景
场景一:机器迁移。老机器硬件老化、租约到期、故障率高,需要把数据搬到新机器。数据库实例的宿主变了,数据必须跟着走。
场景二:机房/云迁移。业务从自建机房上云,或者从 A 云商搬到 B 云商,或者同一家云商内跨地域搬迁(比如从上海机房搬到广州机房)。这是最常见的”上云迁移”,数据从源 MySQL 导出,导入到云上的 MySQL(云厂商的 DTS 服务底层做的就是这件事)。
场景三:版本升级。MySQL 5.6 → 5.7 → 8.0 的大版本升级,跨大版本不支持原地升级(或原地升级风险高)时,就需要”新建目标版本实例 + 迁移数据 + 切流”的方式。我们生产环境从 5.7 升 8.0 用的就是这个方案。
场景四:架构调整。单机扛不住要拆主从;主从扛不住要拆分库分表;反过来多个小实例要合并成一个大实例。数据重新分布,本质上也是迁移。
场景五:测试数据构造。生产数据脱敏后导入测试环境,让测试环境有真实规模的数据,压测结果才有参考价值。
1.2 迁移的本质:导出 → 传输 → 导入 → 校验
不管场景怎么变,一次完整的数据迁移在技术上就是四步:
1
源端 MySQL ──导出──> 中间产物(SQL文件 / 数据文件)──传输──> 目标端 MySQL ──导入──> 数据校验
- 导出:从源库把数据和表结构读出来,形成中间产物
- 传输:把中间产物从源端机器搬到目标端机器(scp、对象存储、管道流式传输)
- 导入:目标端 MySQL 加载中间产物,还原出数据
- 校验:确认两边数据一致(行数、checksum、抽样比对)
看起来简单,但每一步都有坑:导出会不会把源库拖垮?传输过程中业务还在写,新数据怎么办?导入期间目标库能不能对外服务?怎么确认一条数据都没丢?这个系列后面的每一篇,都会围绕这几个问题展开。
2. 三种迁移方案总览
MySQL 到 MySQL 的迁移方案,按照中间产物的形态,可以归为三大类。
2.1 方案一:原生 mysqldump 逻辑迁移
mysqldump 是 MySQL 自带的逻辑导出工具,导出产物是 SQL 文本文件(CREATE TABLE + INSERT 语句),导入时用 mysql 客户端执行(source 命令或管道重定向)。
1
mysqldump 导出 .sql 文件 ──> 传输 ──> mysql source 逐条执行 INSERT
- 优点:MySQL 自带、零额外依赖,逻辑清晰,SQL 文件可读可编辑,跨版本兼容性最好
- 缺点:单线程导出、单线程导入,大表场景速度慢;导入时 SQL 要经过解析器,开销大
- 适用:生产经验值 300GB 以内的数据量,对迁移时间不敏感的场景
2.2 方案二:mydumper/myloader 多线程逻辑迁移
mydumper/myloader 是开源社区(现在由 Percona 维护)的多线程逻辑备份恢复工具,思路和 mysqldump 一样是导 SQL,但导出按表/按块切分后多线程并行,导入同样多线程并行。
1
mydumper 多线程导出(每表两个 .sql 文件:schema 建表文件 + 数据文件,大表数据再切成多个 chunk)──> myloader 多线程并行导入
- 优点:多线程导出导入,速度比 mysqldump 快数倍;一致性快照由主线程统一控制;产物按表拆分,便于断点处理
- 缺点:需要额外安装;线程数开多了对源库的冲击更猛;还是逻辑导入,仍要过 SQL 解析层
- 适用:生产经验值 15TB 以内的数据量、要求迁移窗口尽量短的场景
2.3 方案三:数据文件物理迁移
直接拷贝 InnoDB 的物理数据文件(.ibd 文件等),绕过 SQL 层。典型代表是 Percona XtraBackup(生产最常用,云厂商物理备份的底层),导出产物是数据文件的流式归档(xbstream 格式,配合 qpress 压缩),目标端解压后直接挂载恢复;另外还有”可传输表空间”(Transportable Tablespace)方案,直接拷贝单表的 .ibd 文件。
1
xtrabackup 物理备份(xbstream+qpress 流式压缩)──> 传输 ──> 解压 + prepare ──> 直接作为数据目录启动
- 优点:不经过 SQL 解析层,拷贝的是二进制数据文件,速度最快;导出压力主要是顺序读磁盘,对源库业务冲击相对小
- 缺点:物理文件和 MySQL 版本、
innodb_page_size、row_format强相关,兼容性约束多;恢复目标端必须是”空实例”,不能像逻辑导入那样往已有库里加表;恢复时目标端必须停机替换数据目录(先停库、清空 datadir、拷入备份文件再启动),不像逻辑导入可以在线进行;操作复杂度最高 - 适用:生产经验值 10TB 以上的超大数据量、要求迁移窗口最短的场景
2.4 三方案对比速查表
| 维度 | mysqldump | mydumper/myloader | 物理文件(XtraBackup) |
|---|---|---|---|
| 中间产物 | 单个 .sql 文本 | 多个 .sql 文本(按表/块拆分) | 数据文件归档(xbstream/qpress) |
| 导出并发 | 单线程 | 多线程 | 单线程顺序读(IO 密集) |
| 导入并发 | 单线程 | 多线程 | 文件级拷贝/恢复 |
| 产物可读性 | 可读可编辑 | 可读可编辑 | 二进制不可读 |
| 跨版本兼容 | 最好 | 好 | 差(同版本/同参数最稳) |
| 目标端要求 | 库存在即可 | 库存在即可 | 空实例/整库替换 |
| 典型数据量级 | < 300GB | 300GB ~ 15TB | 10TB+ |
| 上手难度 | 低 | 中 | 高 |
注意:表中”典型数据量级”是生产经验值,实际选型还要结合迁移窗口、源库负载、版本约束灵活判断;本系列后面三篇会在实验环境里实测验证各方案的性能特征。
3. 迁移过程中的典型问题
方案选型之前,先知道会踩什么坑。下面这些问题贯穿整个系列,每一篇实战都会遇到其中几条。
3.1 对源库的冲击
导出本质上是从源库读数据。有人觉得”读操作不影响写入”,太天真了:
- mysqldump 全量导出走一致性快照(
--single-transaction),长事务会导致 InnoDB undo 版本链膨胀, purge 滞后,源库磁盘可能被 undo 撑爆 - 大表全表扫描会把 buffer pool 里的热数据挤出去(buffer pool 污染),业务查询命中率下降、性能抖动
- mydumper 多线程并发读,网络带宽和磁盘 IO 打满,业务响应时间直接飙升
- XtraBackup 物理备份看似”只读文件”,冲击反而可能最重:一边顺序读满整个数据目录、一边持续追踪 redo log,双重 IO 占用;高写入负载下甚至会出现备份追不上 redo 轮转而失败的情况;恢复侧还必须停机——目标端要停库、清空数据目录、替换成备份文件再启动,整个恢复窗口目标库不可用,逻辑导入则可以在线进行
3.2 数据一致性
先说一个容易被忽略的前提:数据迁移的生产级方案,默认源库开启了 binlog 和 GTID。binlog 是增量追赶(3.3 节)的物质基础;GTID 则给每个事务一个全局唯一编号,让目标端在回放增量时用 GTID 保证事务的执行顺序,不用再依赖”binlog 文件名 + 位点”这种脆弱的坐标——文件位点在主库切换、日志轮转后容易对不上,GTID 集合运算天然幂等。
有了这个前提,再看一致性问题本身:导出过程中业务还在写,怎么保证导出来的数据是某个一致时间点的?逻辑导出靠一致性快照(START TRANSACTION WITH CONSISTENT SNAPSHOT),物理导出靠备份期间的 redo 追赶(XtraBackup 的 prepare 阶段)。还有字符集陷阱:源库 utf8mb4 目标库 latin1,导入直接乱码。
3.3 增量追赶与割接
全量导出耗时可能几分钟到几小时,这期间源库新增的数据怎么办?生产级迁移都要”全量 + 增量”两阶段:全量迁移完成后,通过 binlog 复制追平增量,业务低峰期短暂停写,数据追平后切换连接串——这个动作叫割接(cutover)。本系列聚焦全量迁移,增量部分(binlog 追赶)属于复制话题,只在各篇的”注意事项”里点到。
3.4 目标端导入性能
导入是重灾区:
- 逻辑导入(source / myloader)的每条 INSERT 都要走 SQL 解析、binlog 写入、redo 刷新、索引维护,单线程导入速度的天花板极低
- 导入期间的
innodb_flush_log_at_trx_commit=1和sync_binlog=1(双 1 配置)会让每次提交都刷盘,导入速度断崖式下降,生产环境常常要临时调参(导入完再调回来) - 唯一键冲突、外键约束检查、触发器意外触发,都会让导入中途报错卡住
3.5 数据校验
导完了怎么确认没丢数据?最朴素的是行数比对,更严格的是 checksum 比对(比如按表 CHECKSUM TABLE,或者工具级校验如 pt-table-checksum)。校验不过关就敢切流,是对业务的不负责。
4. 迁移评测体系:怎么科学地比出方案优劣
网上讲迁移工具用法的文章很多,但大多数只讲”怎么用”,不讲”到底有多快、对业务有多大影响”。这个系列要做的不同:每种方案都在真实环境里跑一遍,边迁移边压测,用数据说话。
4.1 测试环境
实验在一台 Linux 开发机上完成(配置:10 核 CPU / 34GB 内存 / 系统盘 100GB + 数据盘 1TB,Docker 部署 MySQL 8.0,版本 8.0.46)。为了模拟不同生产形态,搭建了三套架构:
| 架构 | 实例 | 端口 | 说明 |
|---|---|---|---|
| A. 单节点 | mysql-single | 13306 | 最简形态,验证迁移动作对源库自身的影响 |
| B. 主从 | mysql-master / mysql-slave | 13307 / 13308 | 经典异步复制(GTID),观察迁移期间的复制延迟 |
| C. 读写分离 | mysql-rw / mysql-ro | 13309 / 13310 | 模拟”一写多读”形态:写走 rw,导出走 ro,验证从只读节点导出能否给写节点减压 |
另有 mysql-target(端口 13311)作为迁移目标端,每组实验前清空重建。
三套架构搭建完成后的就绪状态(容器状态 + 两组复制状态 + 数据集精确规模):
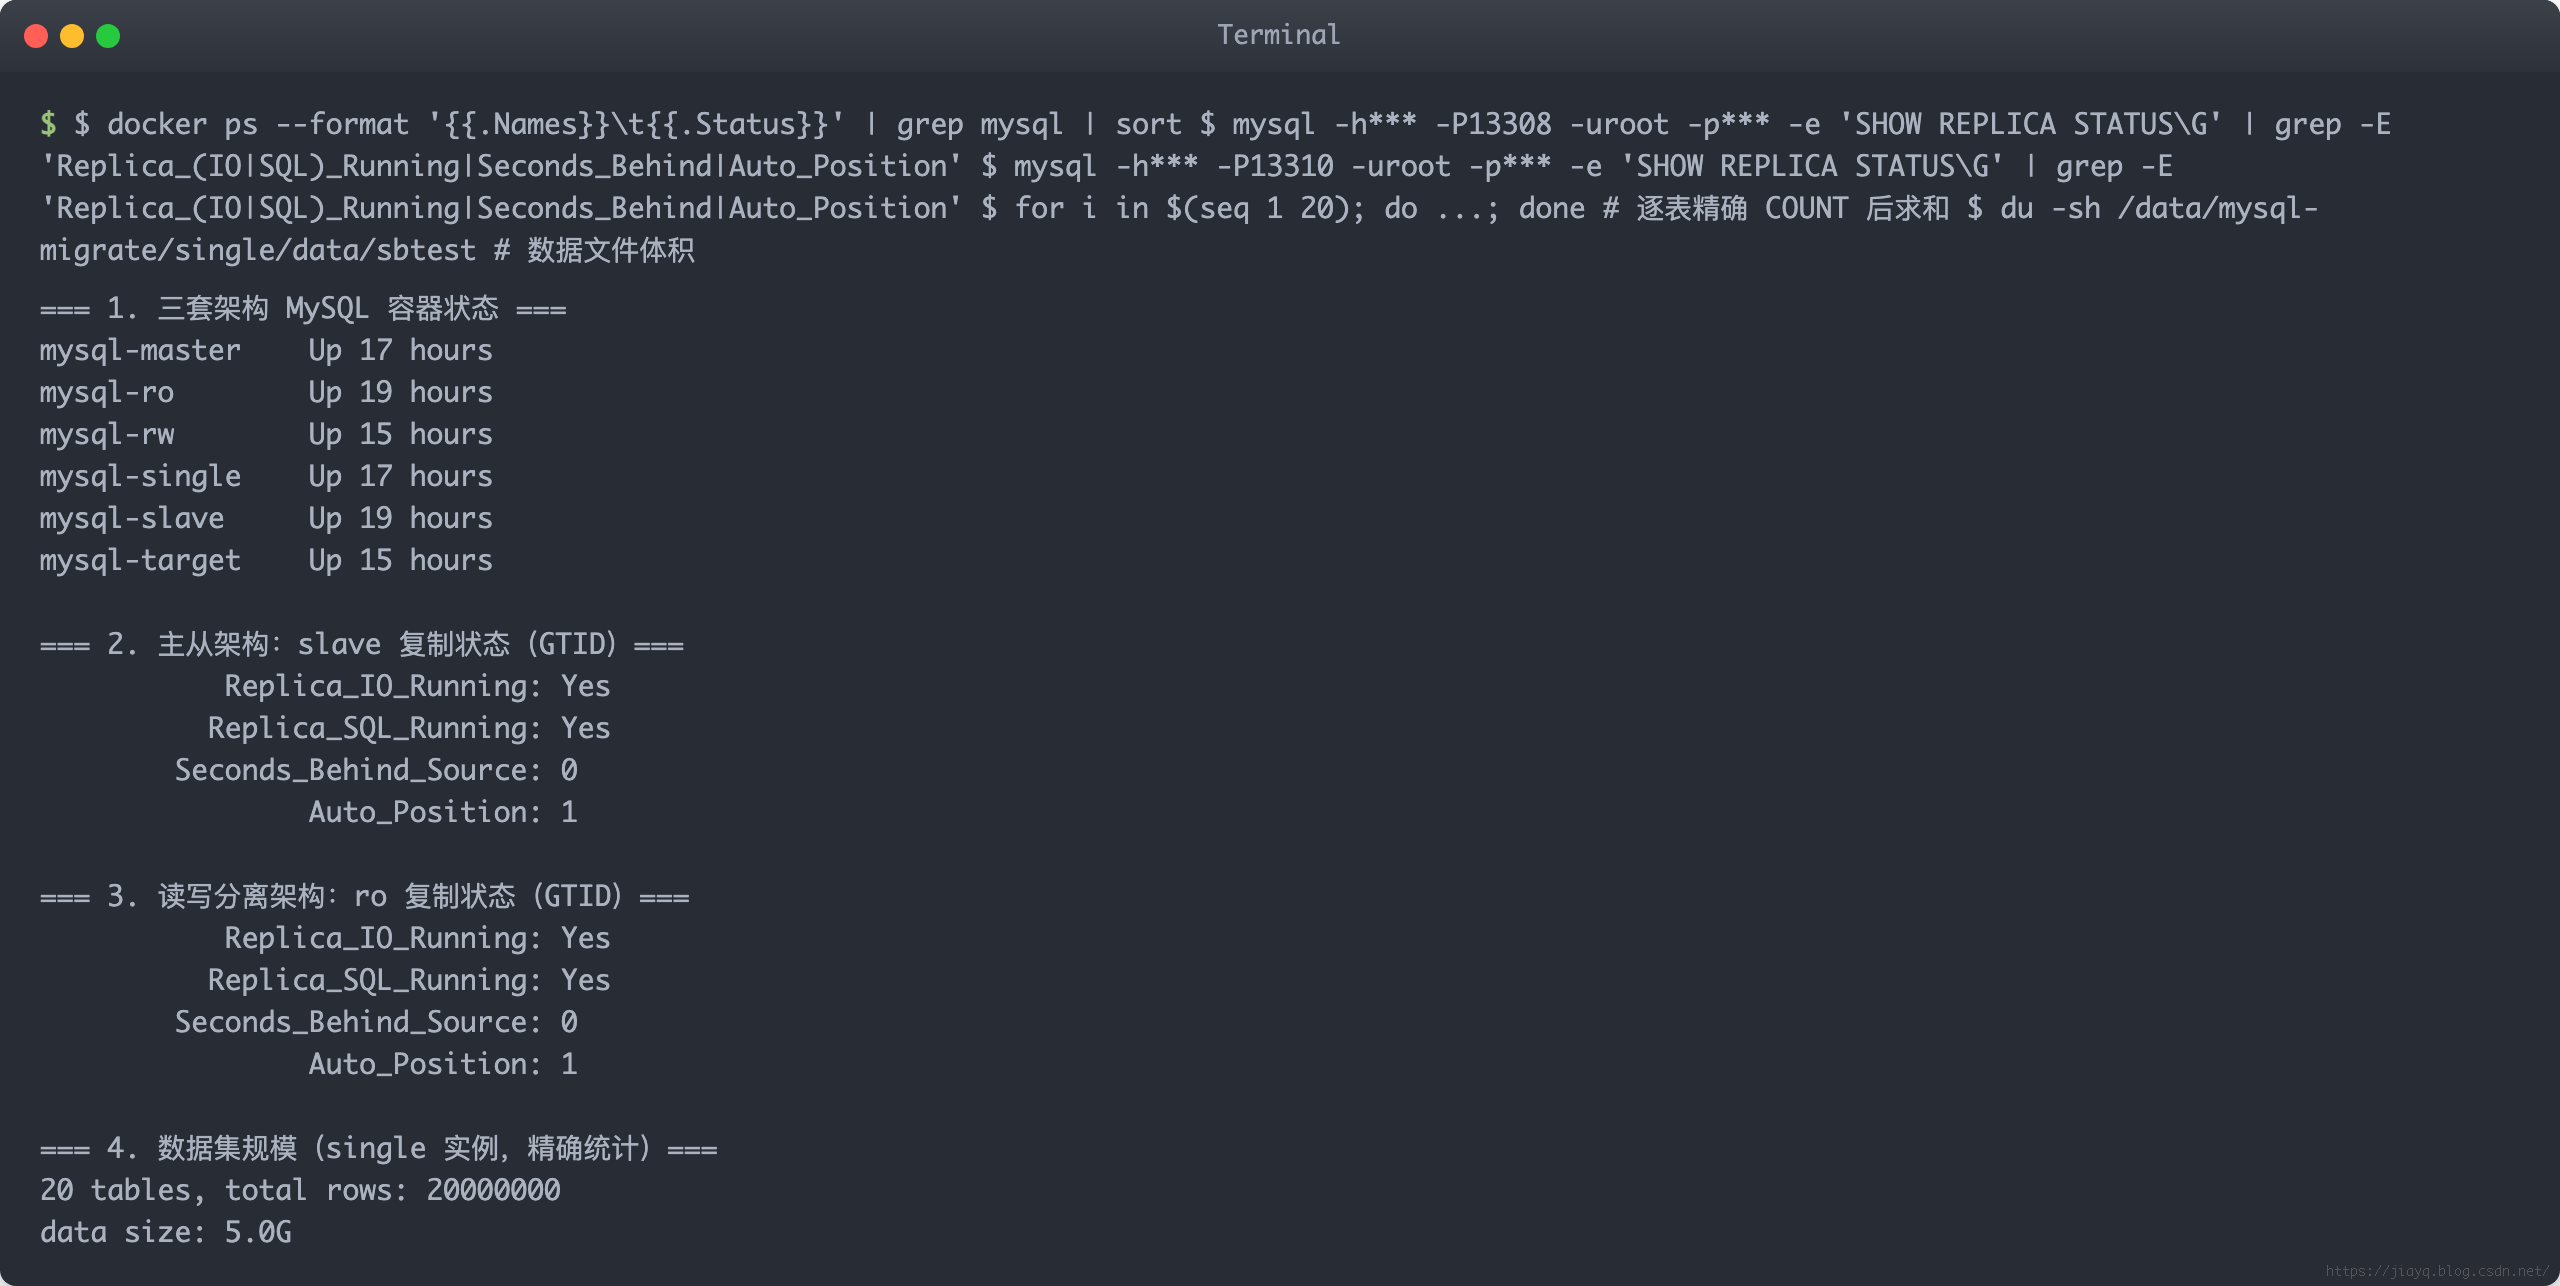
三套架构全部基于 GTID 复制搭建,核心参数保持一致:innodb_buffer_pool_size=4G、双 1 刷盘配置(innodb_flush_log_at_trx_commit=1、sync_binlog=1)、ROW 格式 binlog。
Docker 快速拉起一套主从的命令(脱敏后):
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
# 创建网络
docker network create mysql-migrate-net

# 主库:开 binlog + GTID
docker run -d --name mysql-master --network mysql-migrate-net -p 13307:3306 \
  -v /data/mysql-migrate/master/conf/my.cnf:/etc/mysql/conf.d/my.cnf:ro \
  -v /data/mysql-migrate/master/data:/var/lib/mysql \
  -e MYSQL_ROOT_PASSWORD=*** mysql:8.0

# 主库关键配置
# [mysqld]
# server-id=2001
# log-bin=mysql-bin
# binlog-format=ROW
# gtid-mode=ON
# enforce-gtid-consistency=ON

# 建复制账号后,从库执行
mysql> CHANGE REPLICATION SOURCE TO
    ->   SOURCE_HOST='mysql-master', SOURCE_PORT=3306,
    ->   SOURCE_USER='repl', SOURCE_PASSWORD=***,
    ->   SOURCE_AUTO_POSITION=1;
mysql> START REPLICA;
4.2 数据集:sysbench 造数
用 sysbench 的 oltp_read_write 场景造数据,规模如下:
| 参数 | 值 |
|---|---|
| 表数量 | 20 张(sbtest1 ~ sbtest20) |
| 每表行数 | 1,000,000 |
| 总行数 | 2000 万行 |
| 数据量 | 约 4.2GB(数据+索引;数据目录物理占用约 5.0GB,含碎片页) |
三套架构的源实例(single/master/rw)各自灌入相同数据集(从库/只读节点通过复制自动同步),保证控制变量。
1
2
3
4
5
6
7
8
# 造数据(--rand-type=uniform 让数据分布均匀)
sysbench oltp_read_write \
  --mysql-host=*** --mysql-port=13306 \
  --mysql-user=sbtest --mysql-password=*** \
  --mysql-db=sbtest --db-driver=mysql \
  --tables=20 --table-size=1000000 \
  --threads=8 --rand-type=uniform \
  prepare
4.3 评测指标定义
光说”方案 A 比方案 B 快”没有意义,必须定义清楚指标。本系列统一用以下四个维度评测:
指标一:迁移总时长(含导出、传输、导入各阶段分解)
每个阶段单独计时:
1
2
3
4
5
# 阶段计时用 date +%s 差值
start_ts=$(date +%s)
mysqldump ... > dump.sql
end_ts=$(date +%s)
echo "导出耗时: $((end_ts - start_ts))s"
指标二:迁移期间源库业务性能退化
这是本系列的核心评测方法:用 sysbench 对源库持续压测(oltp_read_write,8 线程),同时在另一个会话里执行导出,对比”无迁移基线”和”迁移期间”的 TPS / QPS / P95 延迟。
1
2
3
4
5
6
7
8
9
10
11
# 1. 先跑 5 分钟无迁移基线
sysbench oltp_read_write --mysql-host=*** --mysql-port=13306 \
  --mysql-user=sbtest --mysql-password=*** --mysql-db=sbtest \
  --tables=20 --table-size=1000000 --threads=8 --time=300 \
  --report-interval=10 --rand-type=uniform run > baseline.log

# 2. 再跑同样压测,压测进行中启动导出(另开会话)
sysbench oltp_read_write ... run > during_migration.log &
sleep 60
mysqldump --single-transaction ... > dump.sql   # 压测进行中导出
wait
对比两份日志中的 transactions:(TPS)和 95th percentile:(P95 延迟),得出性能退化百分比。sysbench 每 10 秒输出一次间隔统计(--report-interval=10),还能画出导出期间的性能曲线。
指标三:主从架构下的复制延迟
导出打在主库时,从库复制是否被拖累。每 10 秒采样一次 SHOW REPLICA STATUS 的 Seconds_Behind_Source,取最大值和平均值:
1
2
3
4
5
6
# 后台每 10s 采样复制延迟
while true; do
  mysql -h*** -P13308 -urepl -p*** -e "SHOW REPLICA STATUS\G" \
    | grep Seconds_Behind_Source
  sleep 10
done > replica_lag.log
指标四:导入后数据一致性
每组实验导入完成后校验:
1
2
3
4
# 行数比对
mysql> SELECT COUNT(*) FROM sbtest.sbtest1;
# checksum 比对(源库 vs 目标库)
mysql> CHECKSUM TABLE sbtest.sbtest1;
三套架构 × 三种方案 = 9 组实验,每组实验都执行”基线压测 → 压测中迁移 → 指标采集 → 数据校验”的完整流程。全部实验数据将在后续三篇中详细呈现。
4.4 一个容易忽略的评测陷阱
评测有个常见误区:只在安静环境里测导出。生产库 7×24 有流量,导出工具和业务请求是在抢资源的——buffer pool、磁盘 IO、网络带宽全是共享的。安静环境测出来的”导出 60 秒”,到了生产上可能是”业务 P95 翻倍的 60 秒”。
所以本系列的压测设计里,导出全程伴随 sysbench 业务流量,测出来的是”业务降级容忍度”下的导出性能,比裸测更接近生产真相。这个方法也是云厂商 DTS 性能白皮书里的标准做法。
导入阶段则相反:割接前的目标库是新实例、不接业务,所以导入用”纯速度”评测——并额外测”调参前 vs 调参后”的对比(关 binlog、弱化刷盘这些生产导入的常规操作),这比在空库上模拟并发流量更有意义。
5. 总结
本篇把 MySQL 数据迁移的”道”讲清楚了:
- 为什么迁:机器/机房/云迁移、版本升级、架构调整、测试数据构造,五大场景殊途同归——导出、传输、导入、校验四步走
- 怎么迁:三大方案——原生 mysqldump(简单慢)、mydumper/myloader(多线程快)、物理数据文件(绕过 SQL 层最快但约束多)
- 怎么评:迁移总时长、压测下的源库性能退化、复制延迟、数据一致性四个维度,全程伴随 sysbench 压测,三套架构(单节点/主从/读写分离)× 三方案共 9 组实验
直白说一句:mysqldump、mydumper、XtraBackup 三种方案没有绝对的好坏,要根据数据量、迁移窗口、源库负载、版本约束等实际情况灵活选用——本系列后续三篇的实测数据,就是帮你建立这种判断力。
下一篇开始,我们将逐个实战三种方案,所有命令可复制、所有数据可复现。
下一篇:MySQL 数据迁移(二)原生 mysqldump 逻辑迁移
版权声明:本文为博主原创文章,遵循 CC 4.0 BY-SA 版权协议,转载请附上原文出处链接和本声明。