从一条直线到大模型输出一个token(七):注意力权重与多头机制
从一条直线到大模型输出一个token(七):注意力权重与多头机制 建议先看:从一条直线到大模型输出一个token(六):QKV 三剑客 上一篇备齐了 Q(查询单)、K(名片)、V(内容),篇尾的热力图已经"偷看"了 Q·K 的配对分。这一篇把注意力的完整流程走通:打分、缩放、Softmax、加权取 V,最后解锁多头机制。 1. 全景:注意力的四步流水线 先把主角公式摆上来: Attention (
文章信息
- 原文链接:https://jiayq.blog.csdn.net/article/details/163977039
- 发布时间:2026-09-20 16:54:43
从一条直线到大模型输出一个token(七):注意力权重与多头机制
建议先看:从一条直线到大模型输出一个token(六):QKV 三剑客
上一篇备齐了 Q(查询单)、K(名片)、V(内容),篇尾的热力图已经”偷看”了 Q·K 的配对分。这一篇把注意力的完整流程走通:打分、缩放、Softmax、加权取 V,最后解锁多头机制。
1. 全景:注意力的四步流水线
先把主角公式摆上来:
\[\text{Attention}(\mathbf{Q}, \mathbf{K}, \mathbf{V}) = \text{Softmax}\left(\frac{\mathbf{Q}\mathbf{K}^{\mathrm{T}}}{\sqrt{d_k}}\right)\mathbf{V}\]看着唬人,拆开就是四步,如图 7-1 所示。
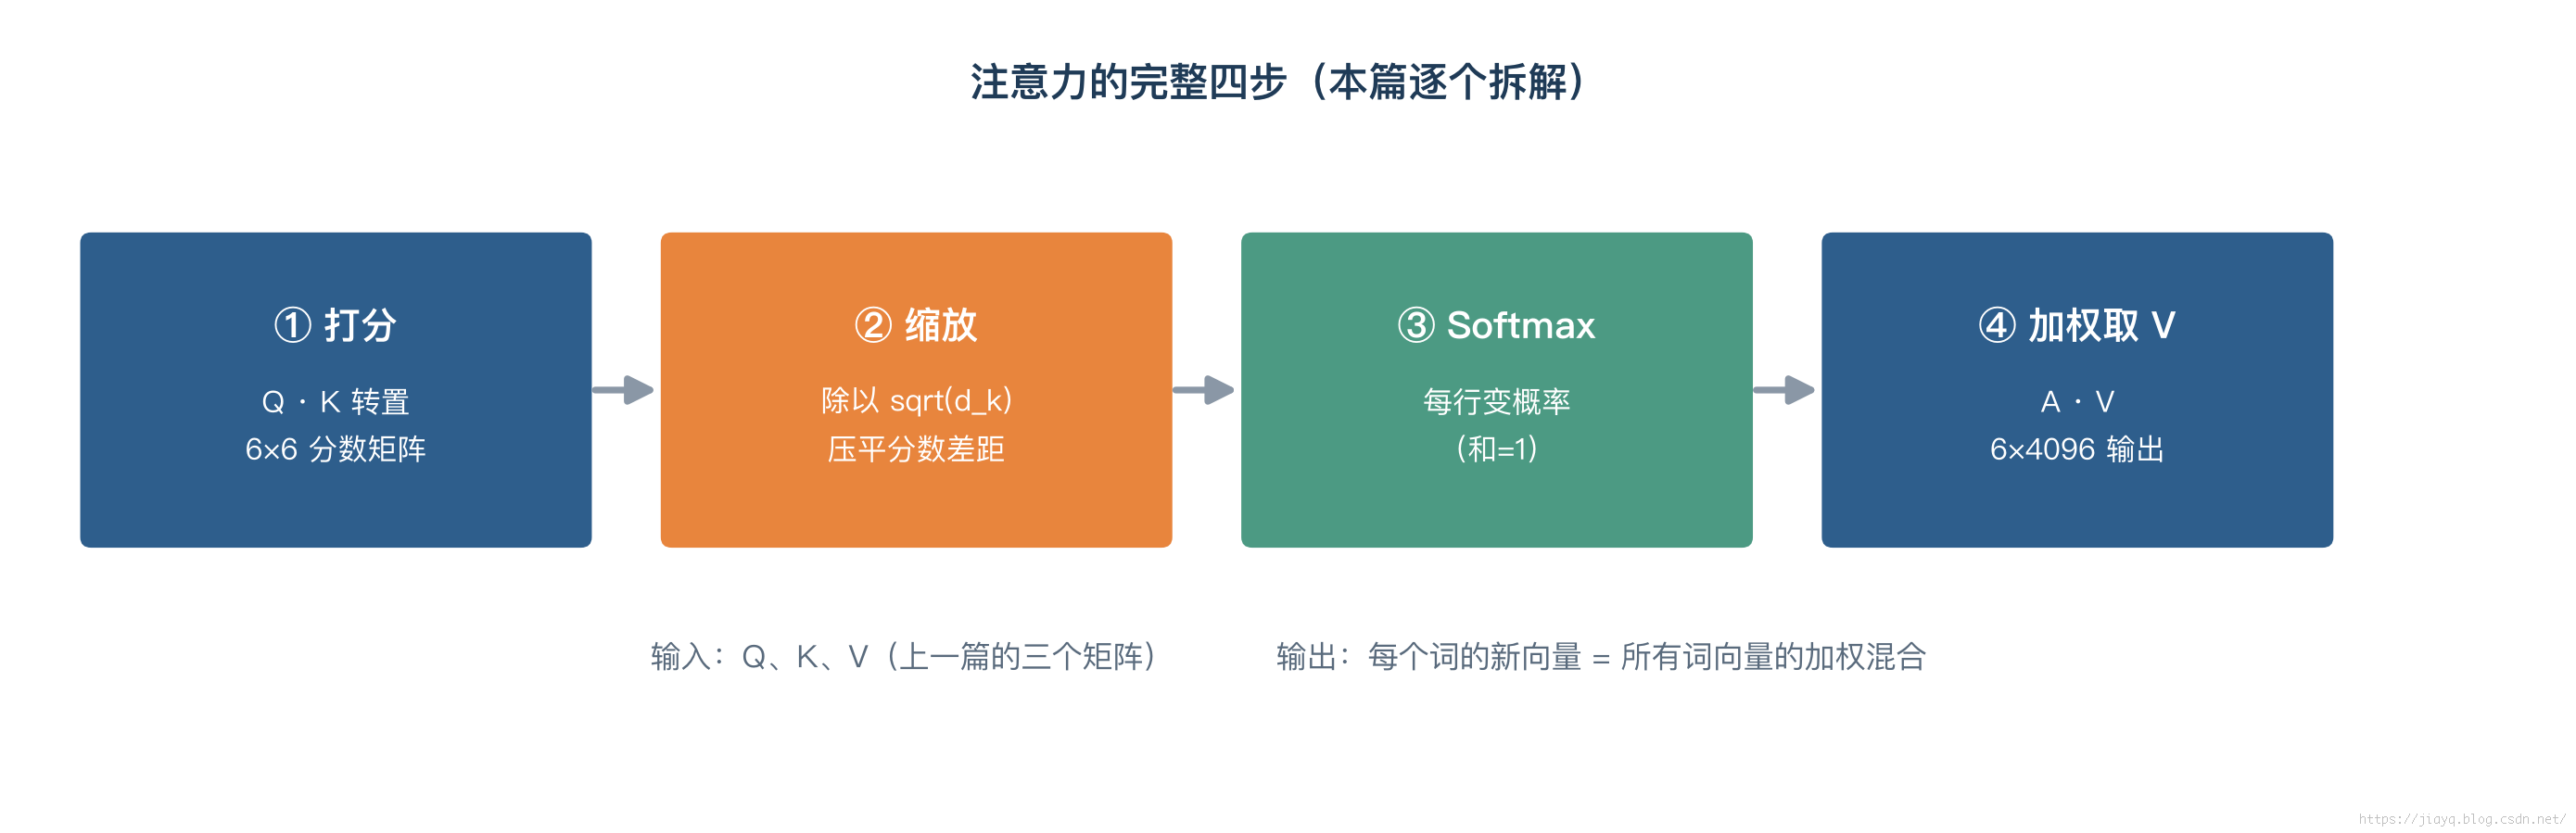
图7-1 注意力的完整四步(本篇逐个拆解)
- 打分:$\mathbf{Q}\mathbf{K}^{\mathrm{T}}$——每张查询单逐一比对每张名片,得到 6×6 分数矩阵
- 缩放:除以 $\sqrt{d_k}$——压平分数差距
- Softmax:每行变成概率(和为 1)——分数变”分配比例”
- 加权取 V:$\mathbf{A}\mathbf{V}$——按比例混合所有词的内容,得到新向量
下面逐步拆解。每一步都用贯穿案例实算,数字全部可以验证。
2. 第一步打分与第二步缩放
2.1 打分:一行对一行的点积
$\mathbf{Q}\mathbf{K}^{\mathrm{T}}$ 的规则和第一篇学的矩阵乘法一模一样:Q 的第 i 行(第 i 个词的查询单)点乘 K 的第 j 行(第 j 个词的名片),得到分数矩阵的第 i 行第 j 列——第 i 个词对第 j 个词的”兴趣度”原始分。结果就是篇6末尾那张热力图,这里再放一遍,如图 7-2 所示。
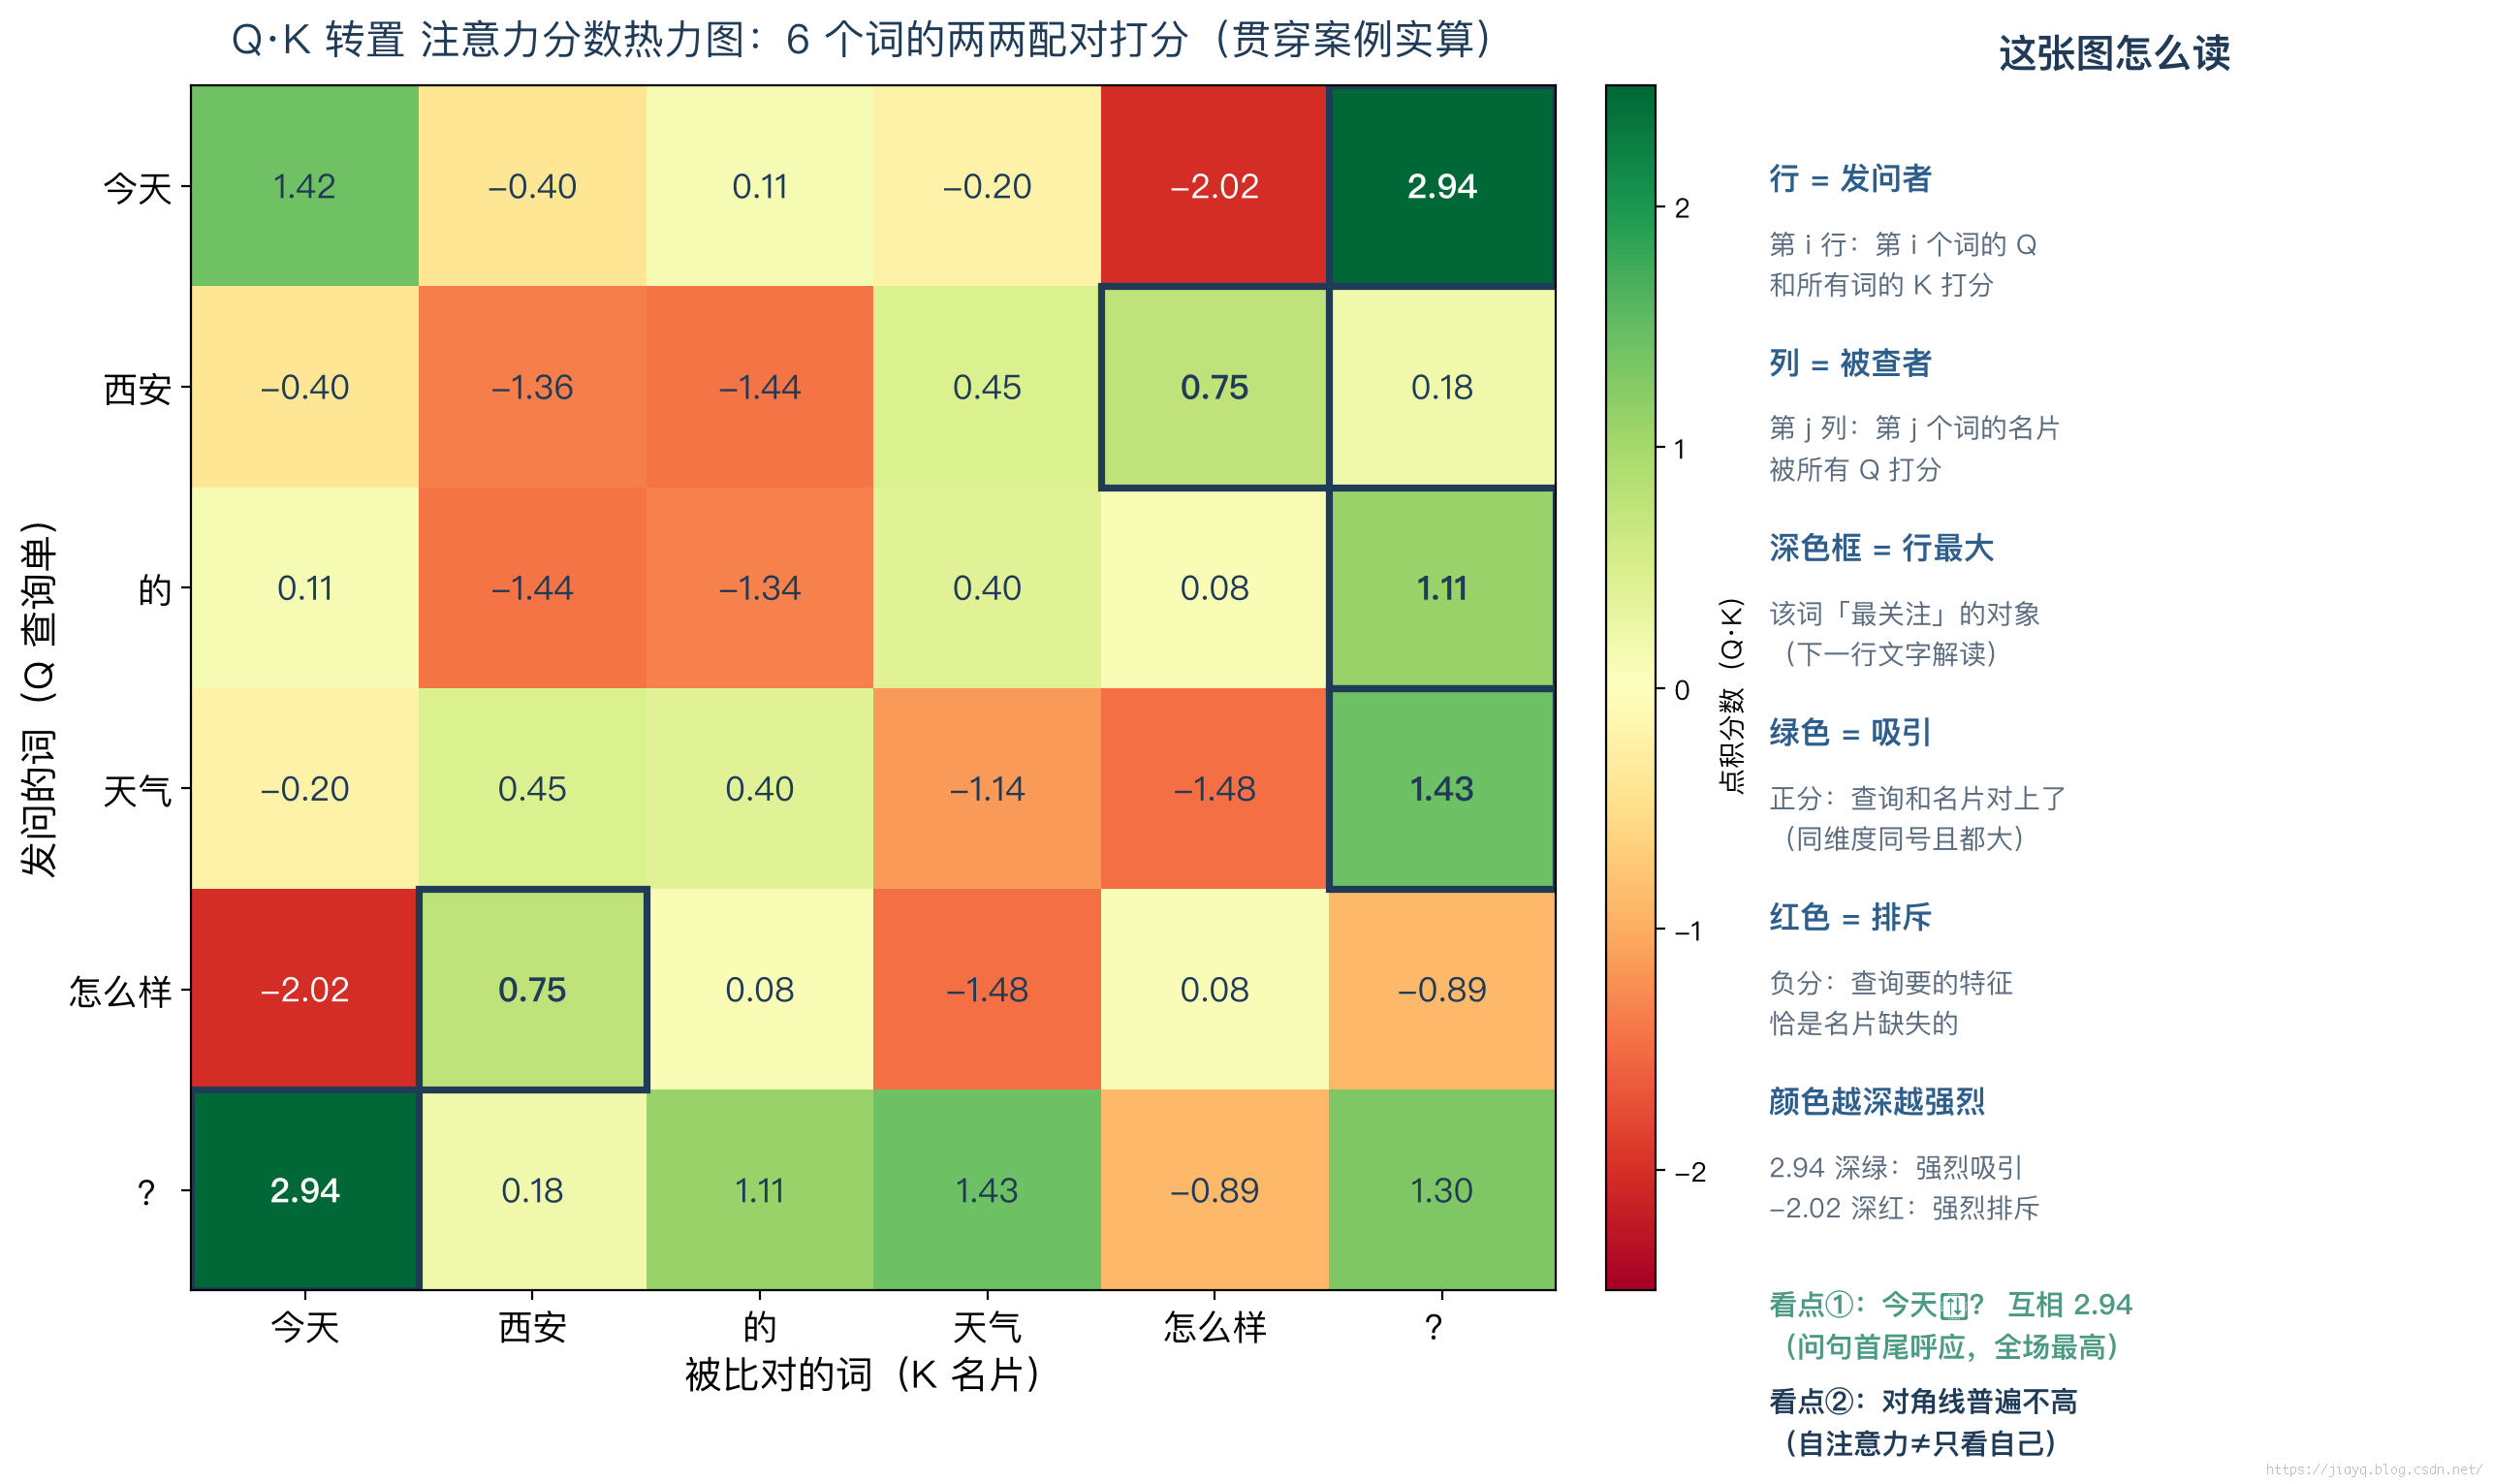
图7-2 Q·K 转置 注意力分数热力图(承接篇6)
西安行(第 2 行):$[-0.40, -1.36, -1.44, 0.45, 0.75, 0.18]$。
2.2 为什么必须除以 sqrt(d_k)
分数接下来要进 Softmax。但直接进有个问题:点积的方差随维度增长。两个随机向量的点积,每个维度贡献一份噪声,维度越高分数波动越大——$d_k=512$ 时分数标准差约 $\sqrt{512} \approx 22.6$,轻松出现 ±60 的极端分。
Softmax 对大分数的反应是”赢家通吃”:最大的分数拿走几乎全部权重,其他全是零头。看起来似乎没毛病?问题出在训练上,如图 7-3 所示。
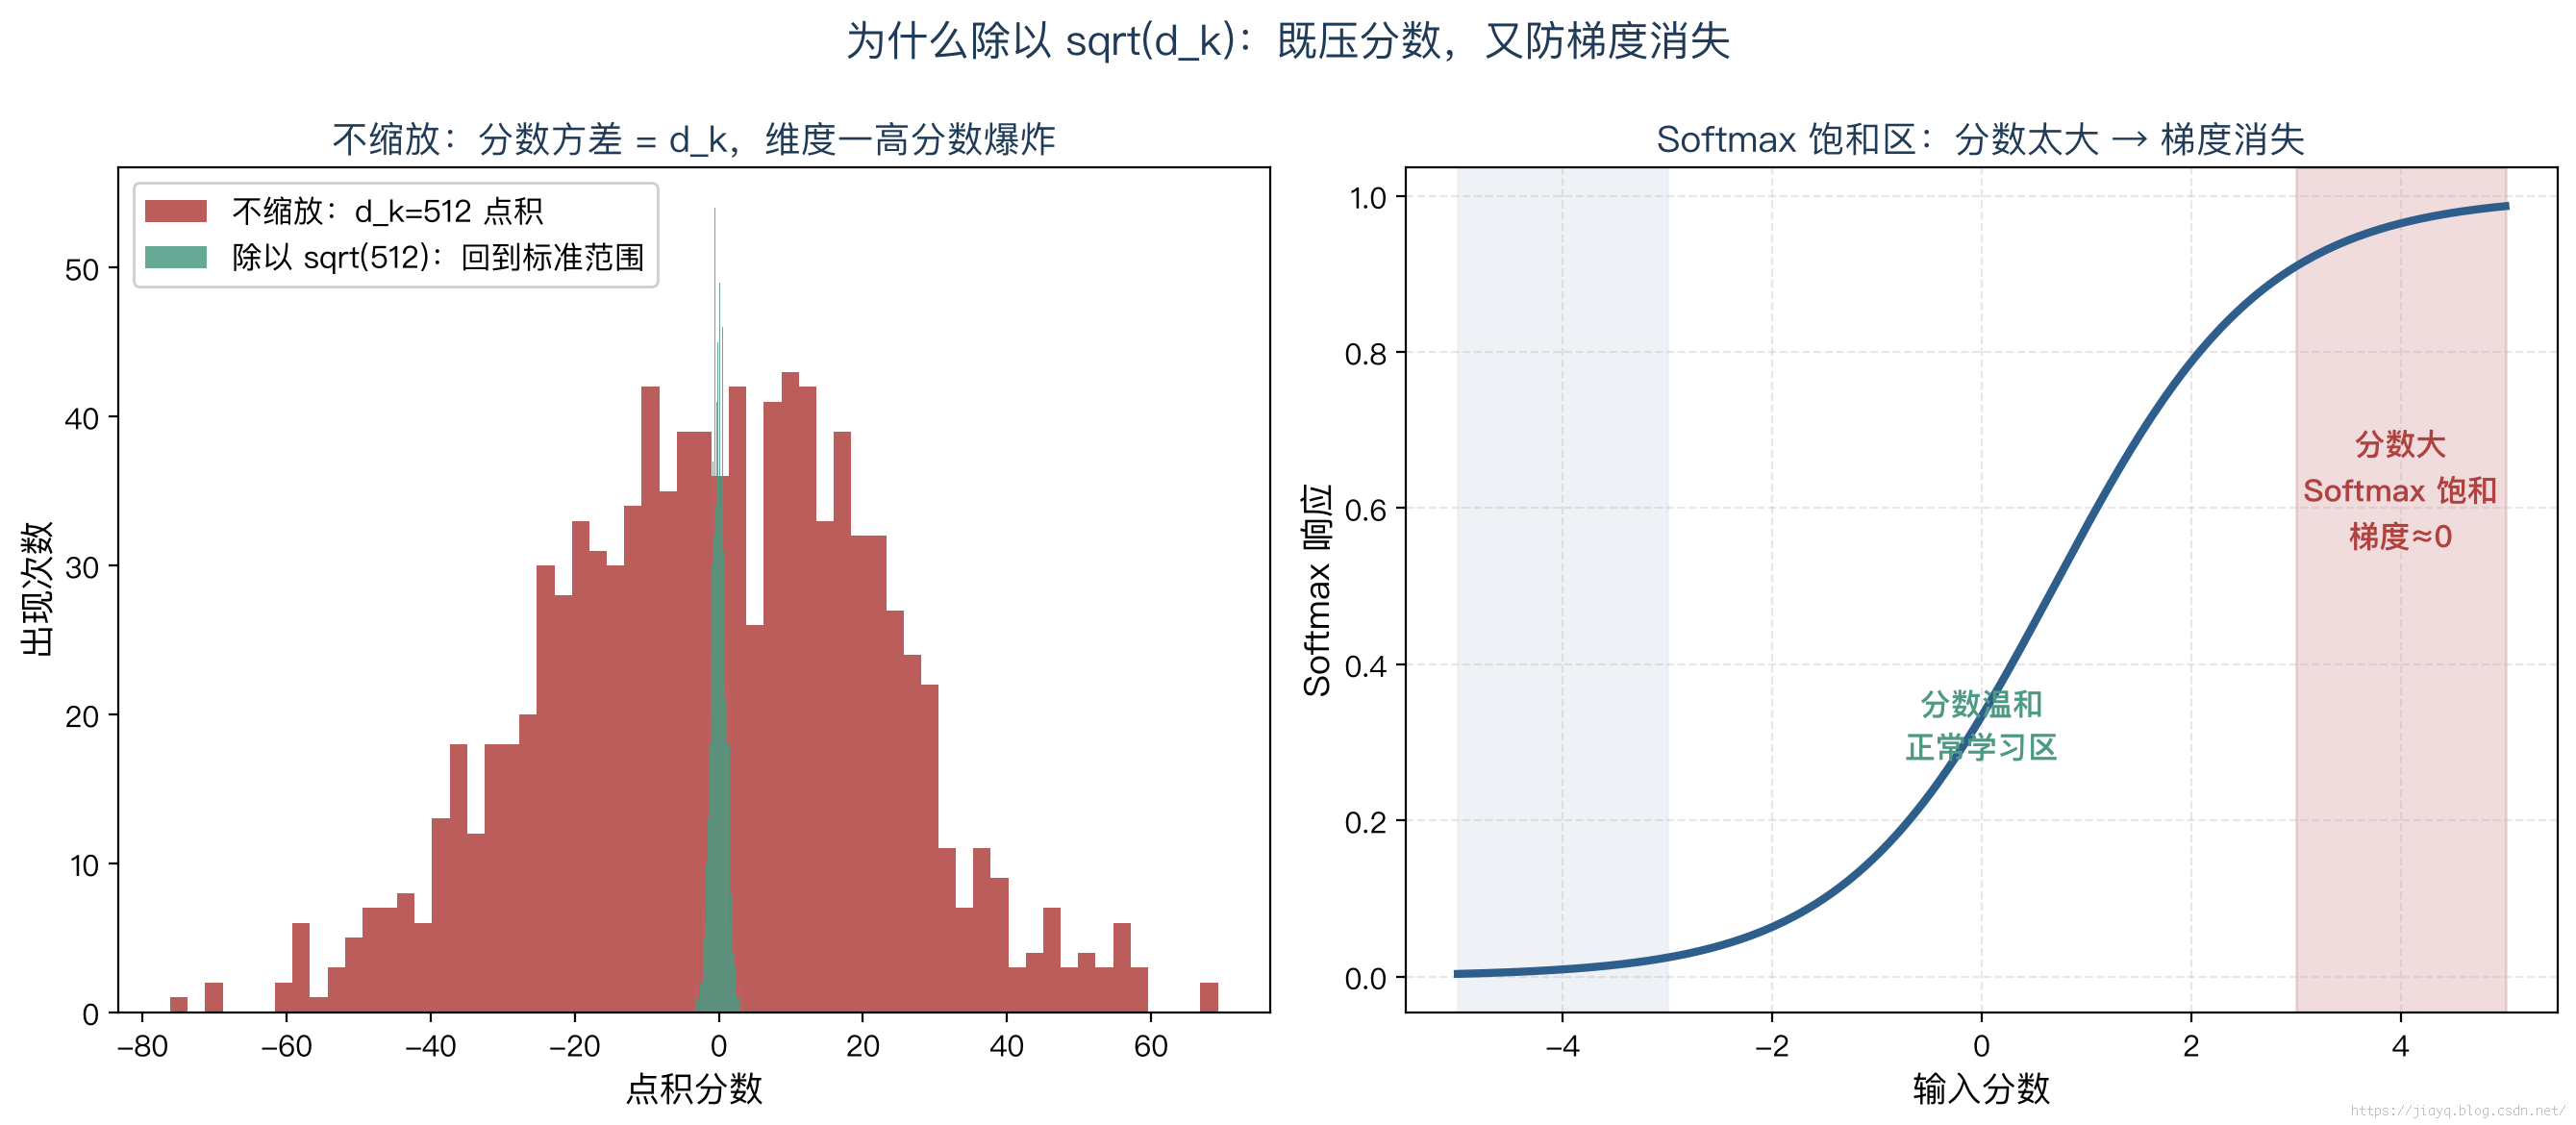
图7-3 为什么除以 sqrt(d_k):既压分数,又防梯度消失
这里必须补一个背景概念:梯度。训练时,误差信号要从输出往回传(反向传播),告诉每个参数”该往哪调、调多少”——这个”调整量”就是梯度。Softmax 输出接近 1 或 0 的区域(饱和区),梯度几乎为零——参数收不到调整指令,学不到东西,这就是梯度消失。分数一大,Softmax 必然饱和,整个注意力层在训练里就”躺平”了。
除以 $\sqrt{d_k}$ 恰好把点积方差拉回常数($d_k$ 的方差是 $d_k$,除以 $\sqrt{d_k}$ 后变回 1),分数回到温和区间,Softmax 工作在正常学习区。
用贯穿案例实算:$d_k=4$,$\sqrt{d_k}=2$,西安行分数减半,如图 7-4 第②行($0.45 \to 0.23$,$0.75 \to 0.38$……)。
3. 第三步 Softmax:分数变分配比例
3.1 Softmax 是什么
Softmax 把一行分数变成一组和为 1 的正数(概率分布),公式:
\[\text{Softmax}(x_i) = \frac{e^{x_i}}{\sum_j e^{x_j}}\]直觉:分数高的拿大头,低的拿小头,但每家都有份(除非分数差距悬殊)。
3.2 西安行手算四步
「西安」行的完整 Softmax 手算如图 7-4 所示。
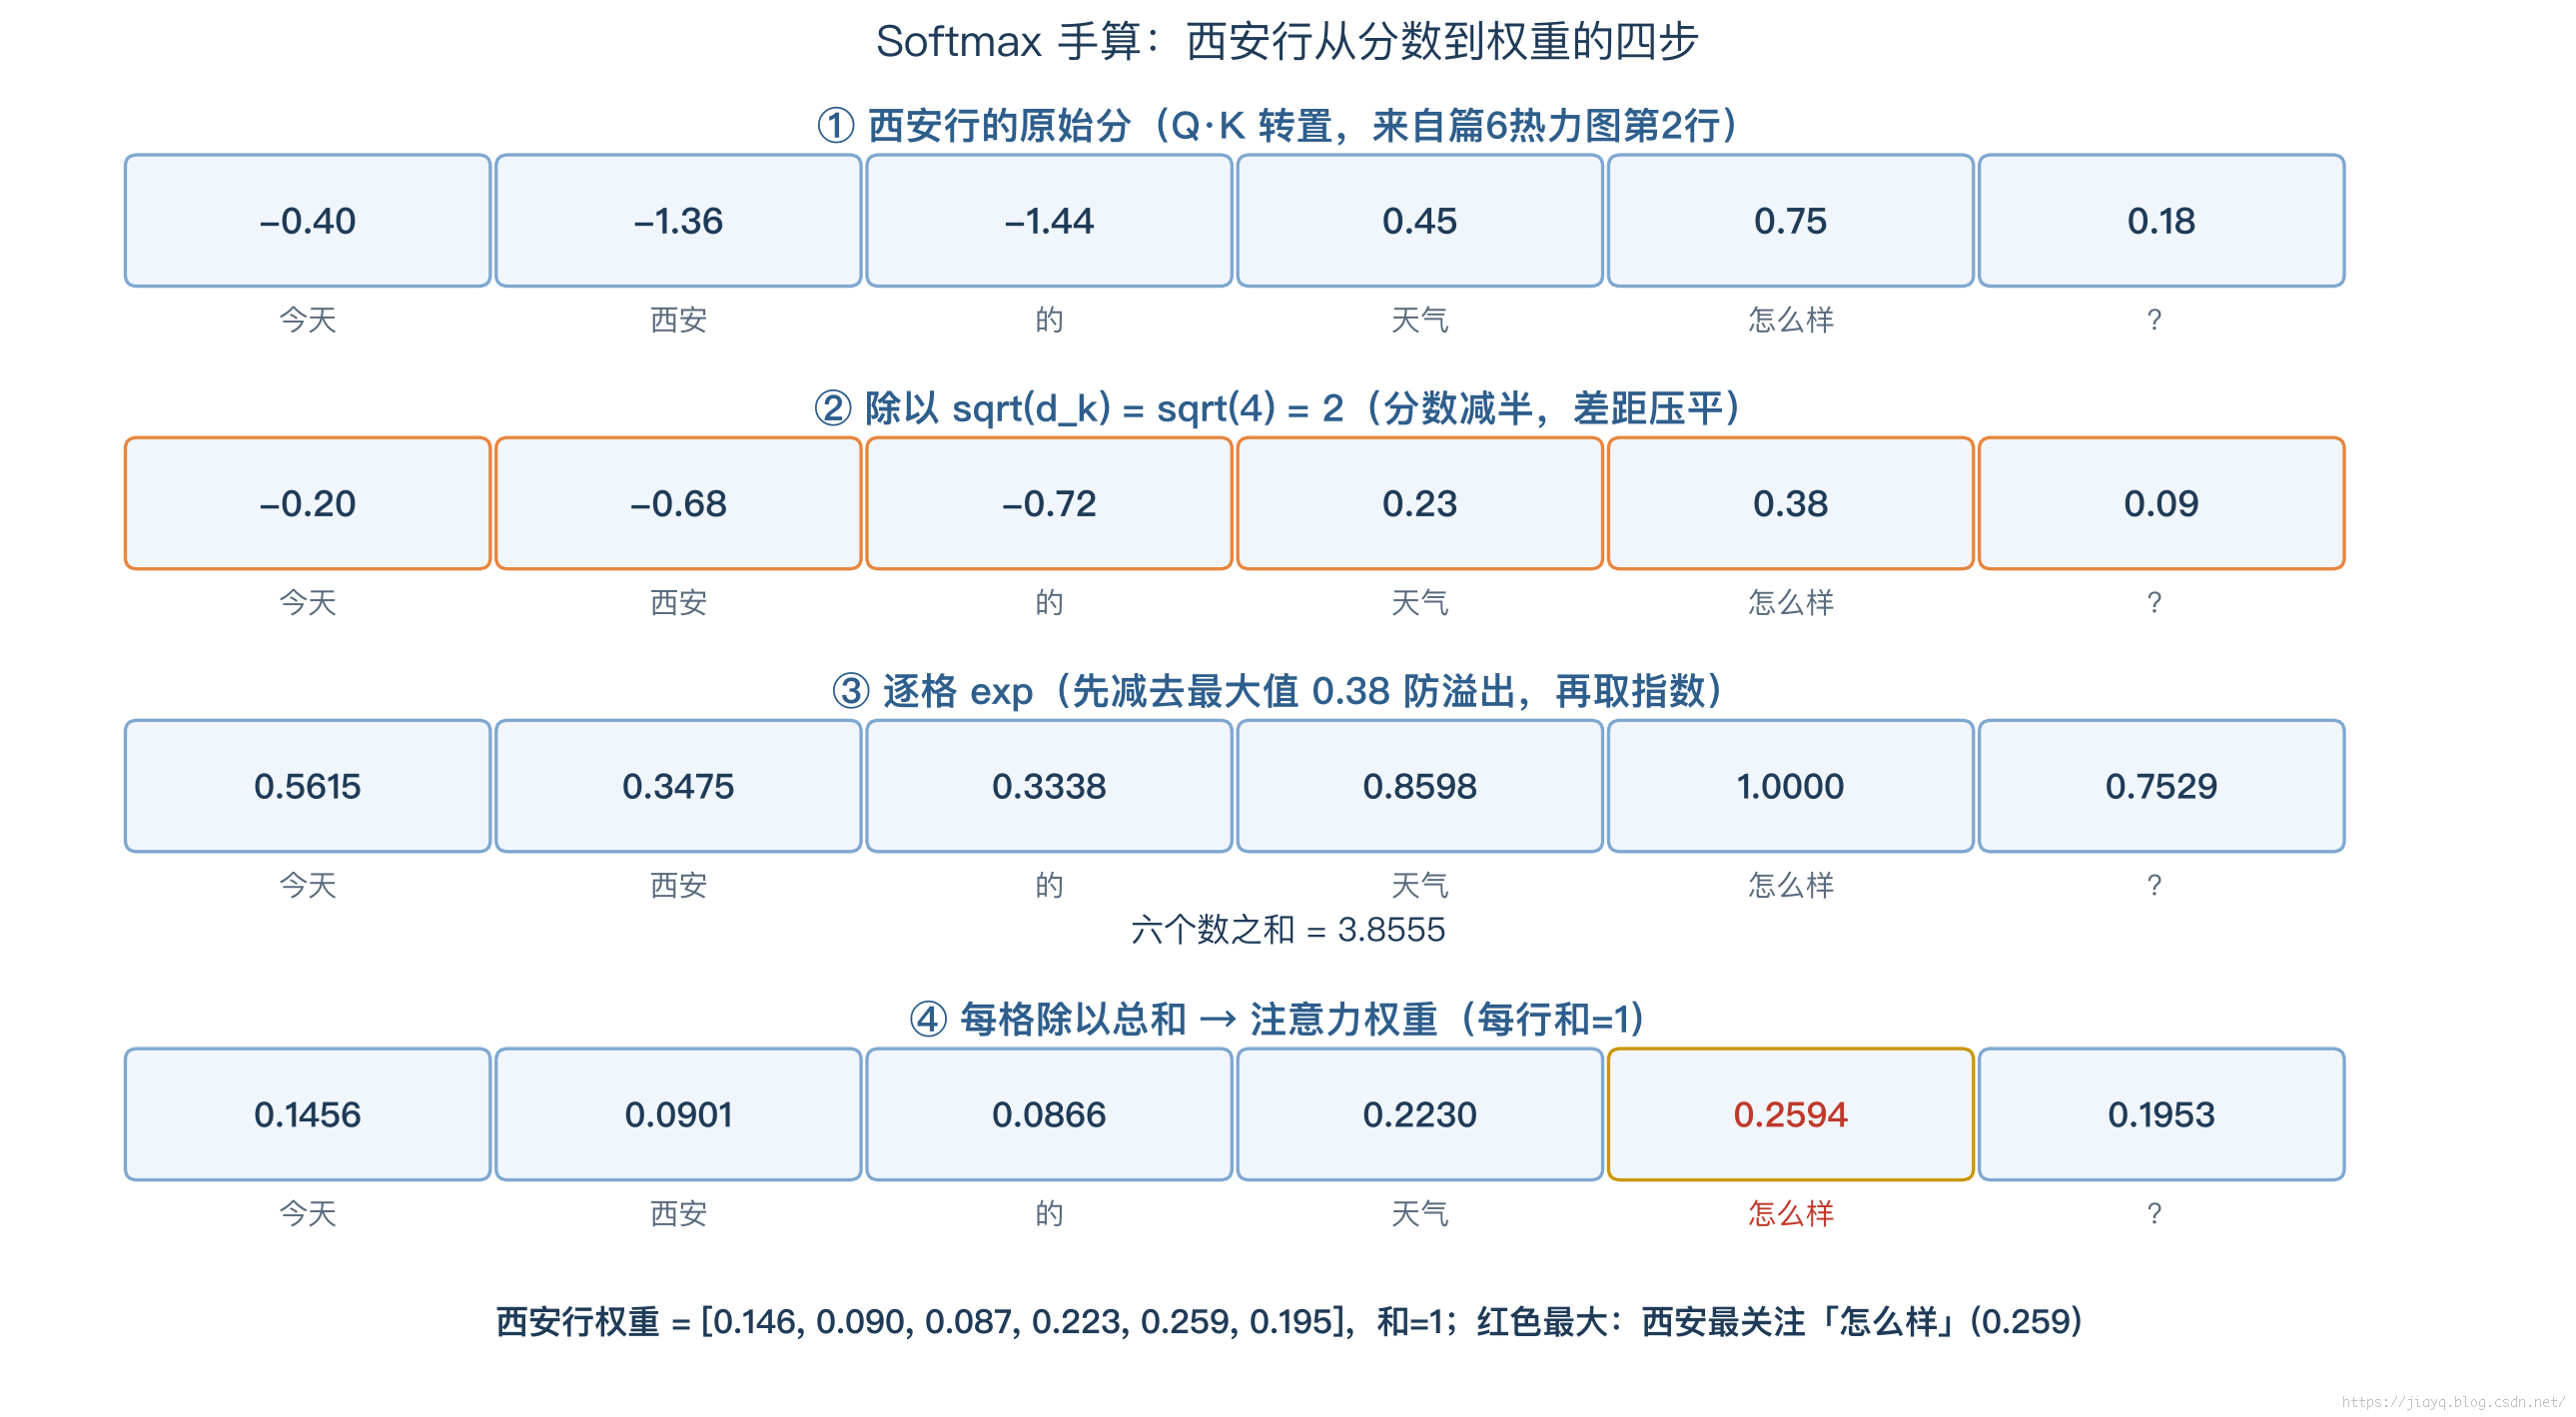
图7-4 Softmax 手算:西安行从分数到权重的四步
- 缩放后分数:$[-0.20, -0.68, -0.72, 0.23, 0.38, 0.09]$
- 每格先减去最大值 0.38(防止 $e^x$ 溢出的工程技巧,不影响结果比例),再取指数:$[0.5615, 0.3475, 0.3338, 0.8598, 1.0000, 0.7529]$
- 求和:$3.8555$
- 每格除以总和,得到注意力权重:
和恰好为 1。红色标注的最大值 0.259 是「怎么样」——「西安」把 25.9% 的注意力分给了「怎么样」(和篇6热力图的判断一致)。
全部 6 个 token 都做同样的四步,得到完整的注意力权重矩阵 $\mathbf{A}$(6×6,每行和 = 1,红色 = 每行最大值):
\[\mathbf{A} = \begin{bmatrix} 0.213 & 0.086 & 0.111 & 0.095 & 0.038 & \textcolor{red}{0.457} \\ 0.146 & 0.090 & 0.087 & 0.223 & \textcolor{red}{0.259} & 0.195 \\ 0.174 & 0.080 & 0.084 & 0.202 & 0.172 & \textcolor{red}{0.288} \\ 0.140 & 0.194 & 0.189 & 0.087 & 0.074 & \textcolor{red}{0.316} \\ 0.073 & \textcolor{red}{0.290} & 0.207 & 0.095 & 0.207 & 0.128 \\ \textcolor{red}{0.369} & 0.093 & 0.148 & 0.173 & 0.054 & 0.162 \end{bmatrix}\]读一遍这张表,句子的”注意力地图”就出来了:
- 「今天」最关注「?」(0.457)——问句首尾呼应
- 「西安」最关注「怎么样」(0.259)——地点与疑问联动
- 「怎么样」最关注「西安」(0.290)——疑问词找答案对象,和西安形成双向奔赴
- 「?」最关注「今天」(0.369)——问号回扣主语
- 「的」和「天气」都最关注「?」——弱实义词和核心名词都在向疑问焦点汇聚
3.3 缩放的实际效果对比
做个对照实验:「今天」行的权重,缩放前后对比如图 7-5 所示。
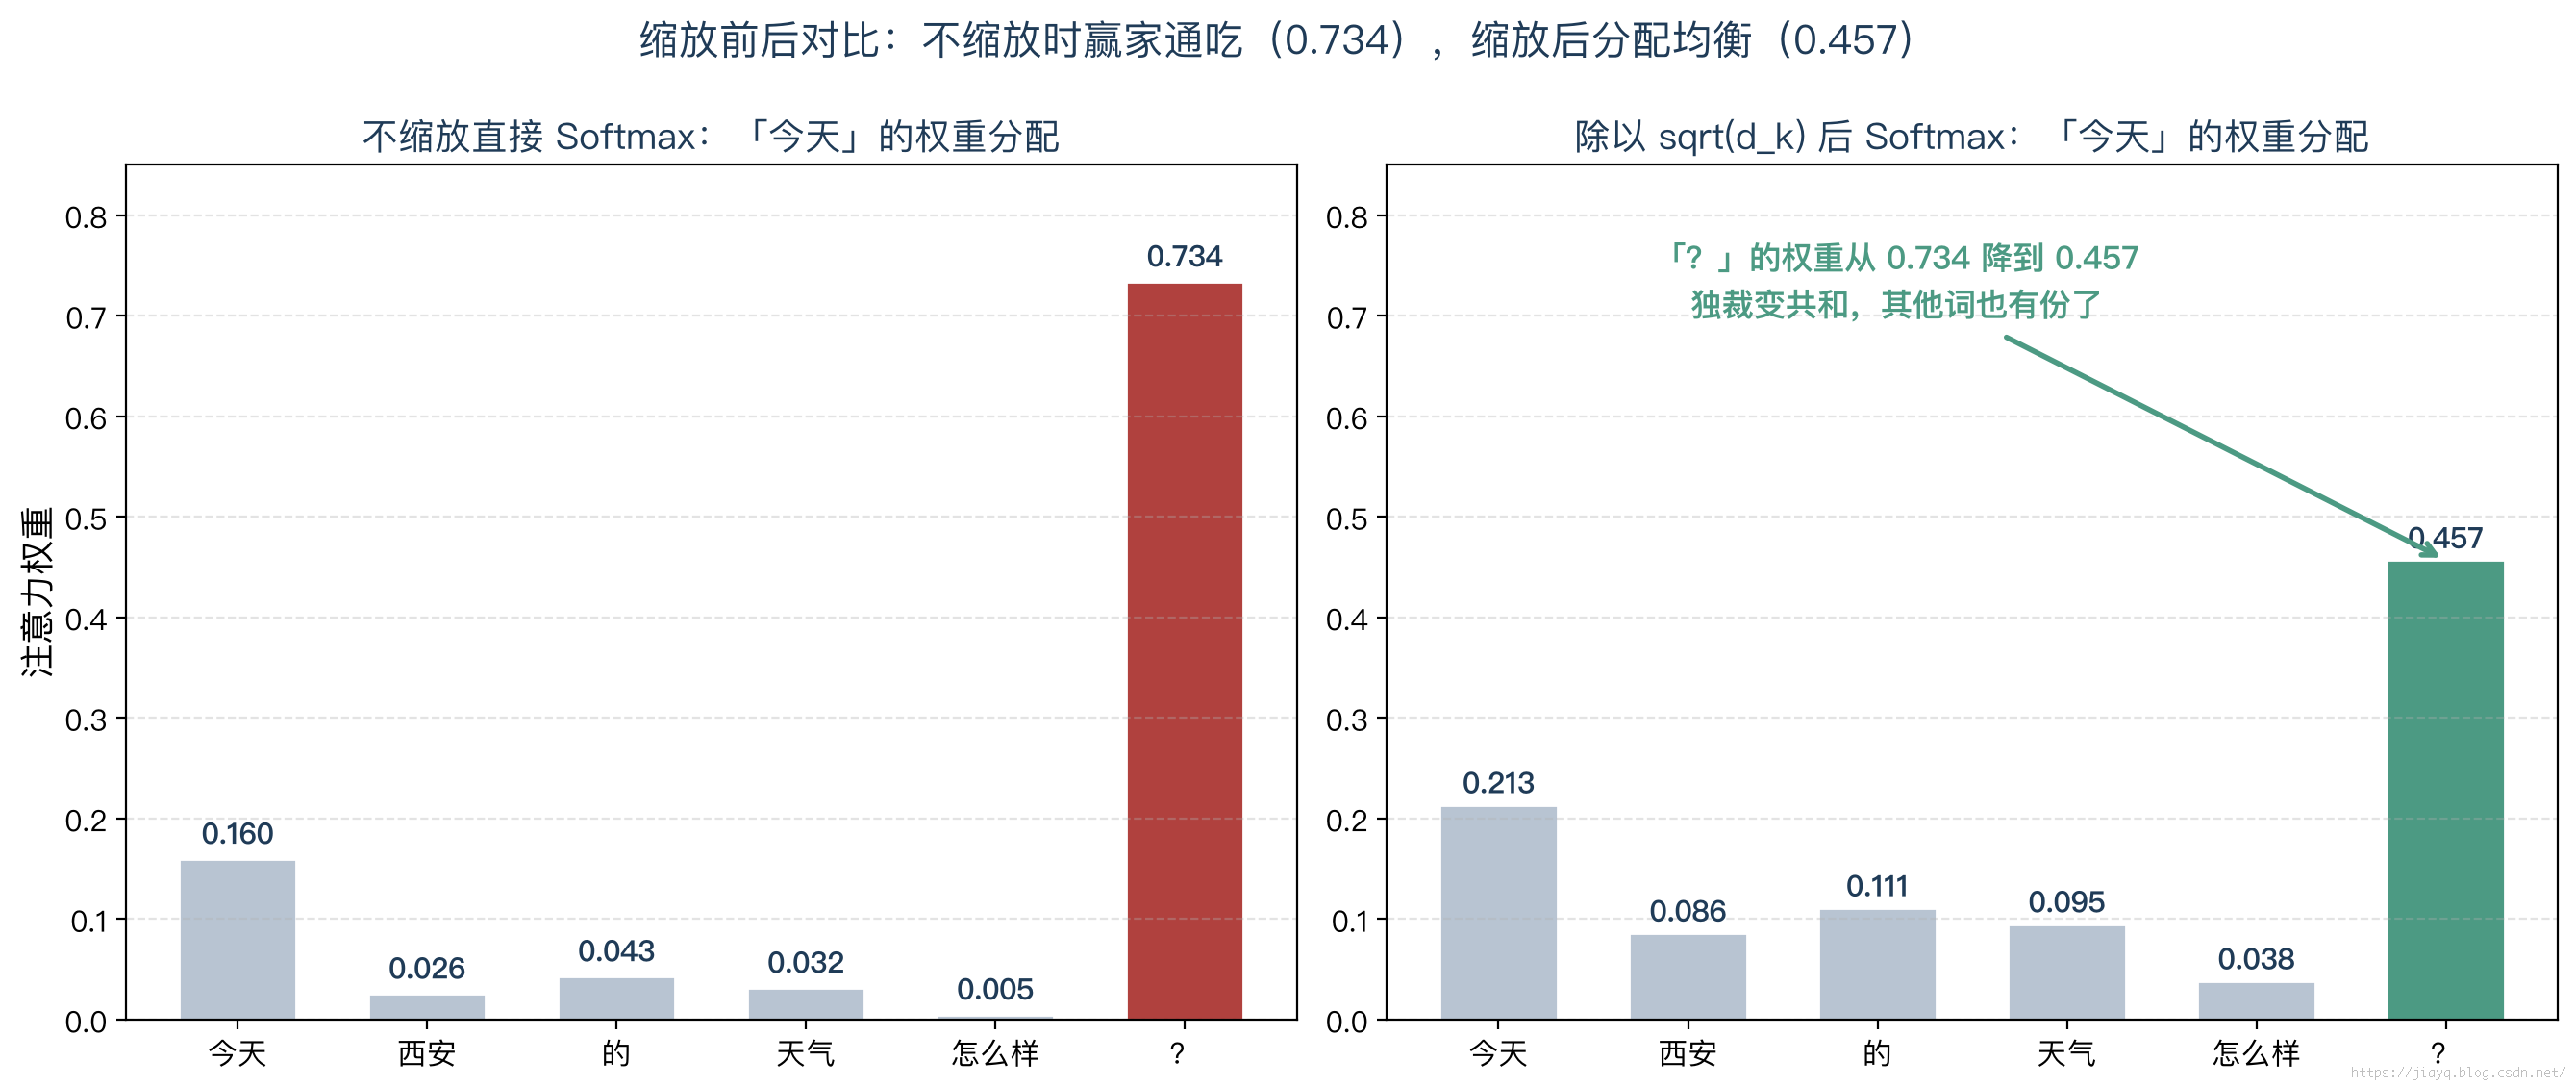
图7-5 缩放前后对比:不缩放时赢家通吃(0.734),缩放后分配均衡(0.457)
- 不缩放:「今天」给「?」的权重高达 0.734——赢家通吃,其他词几乎没收成
- 缩放后:降到 0.457——「?」仍是最大头,但「今天」自己(0.213)、「的」(0.111)也有像样的份额
注意这不是说”不缩放的理解更准”。$d_k=4$ 的演示里差距已经这么大;真实 $d_k=128$ 时分数方差是这里的 32 倍,不缩放的 Softmax 会彻底退化成 one-hot——只有一个词的信息能传过去,注意力的”广泛参考”就死了。而且如 2.2 节所说,饱和区的梯度消失会让训练先崩溃。
4. 第四步加权取 V:分配比例变新向量
4.1 A·V:一行权重的”配货”
拿到注意力权重 $\mathbf{A}$(6×6,每行和为 1,3.2 节已算出)后,最后一步 $\mathbf{A}\mathbf{V}$:每个词的新向量 = 全体词的 V 按权重加权混合。
把权重矩阵也画成热力图(和篇6 的 Q·K 分数热力图对照着看:分数经过缩放和 Softmax,变成了”和为 1 的柔和版”),如图 7-6 所示。
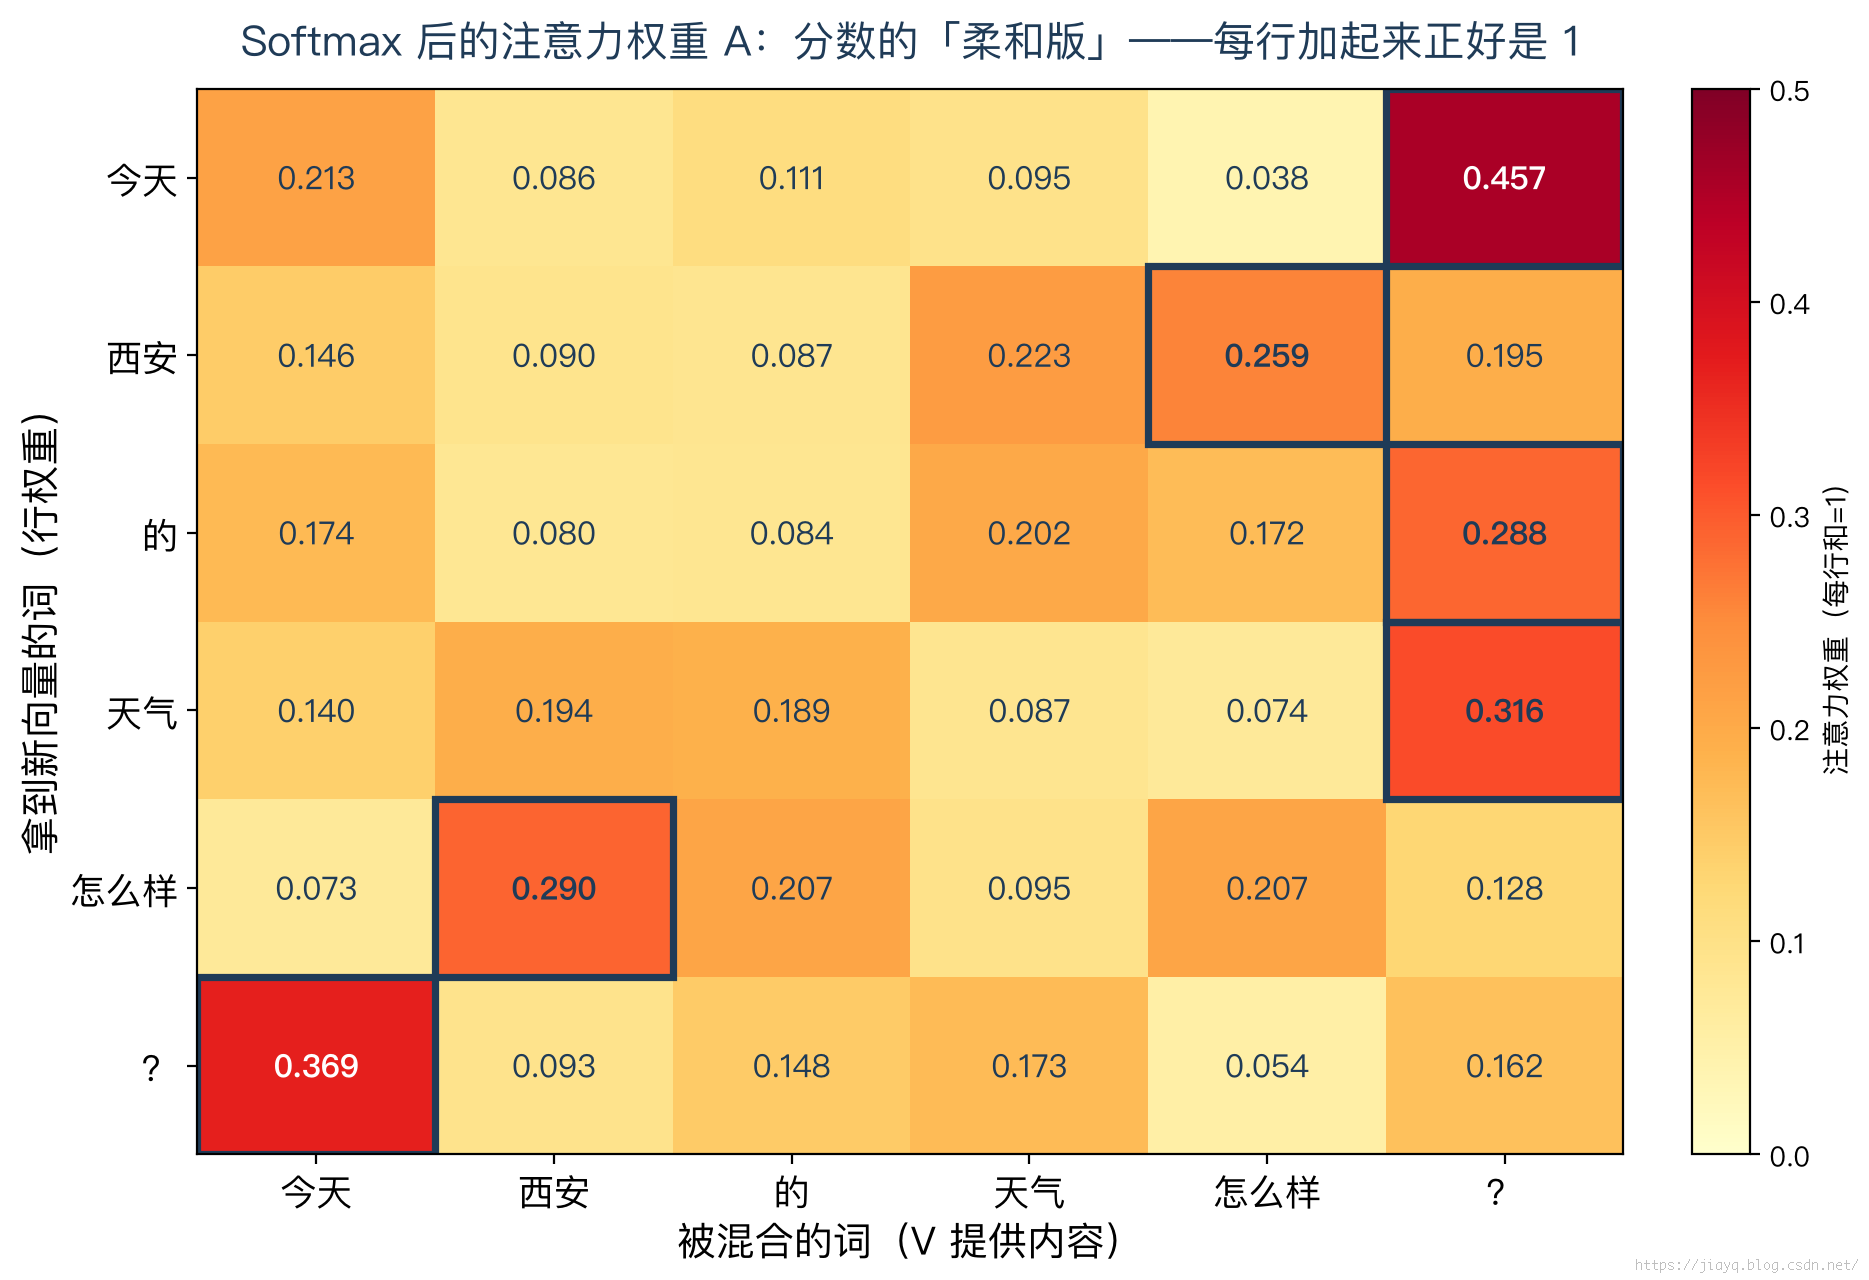
图7-6 注意力权重 A 的热力图(Softmax 后:每行和=1)
「西安」的新向量第 1 维,完整手算如图 7-7 所示。
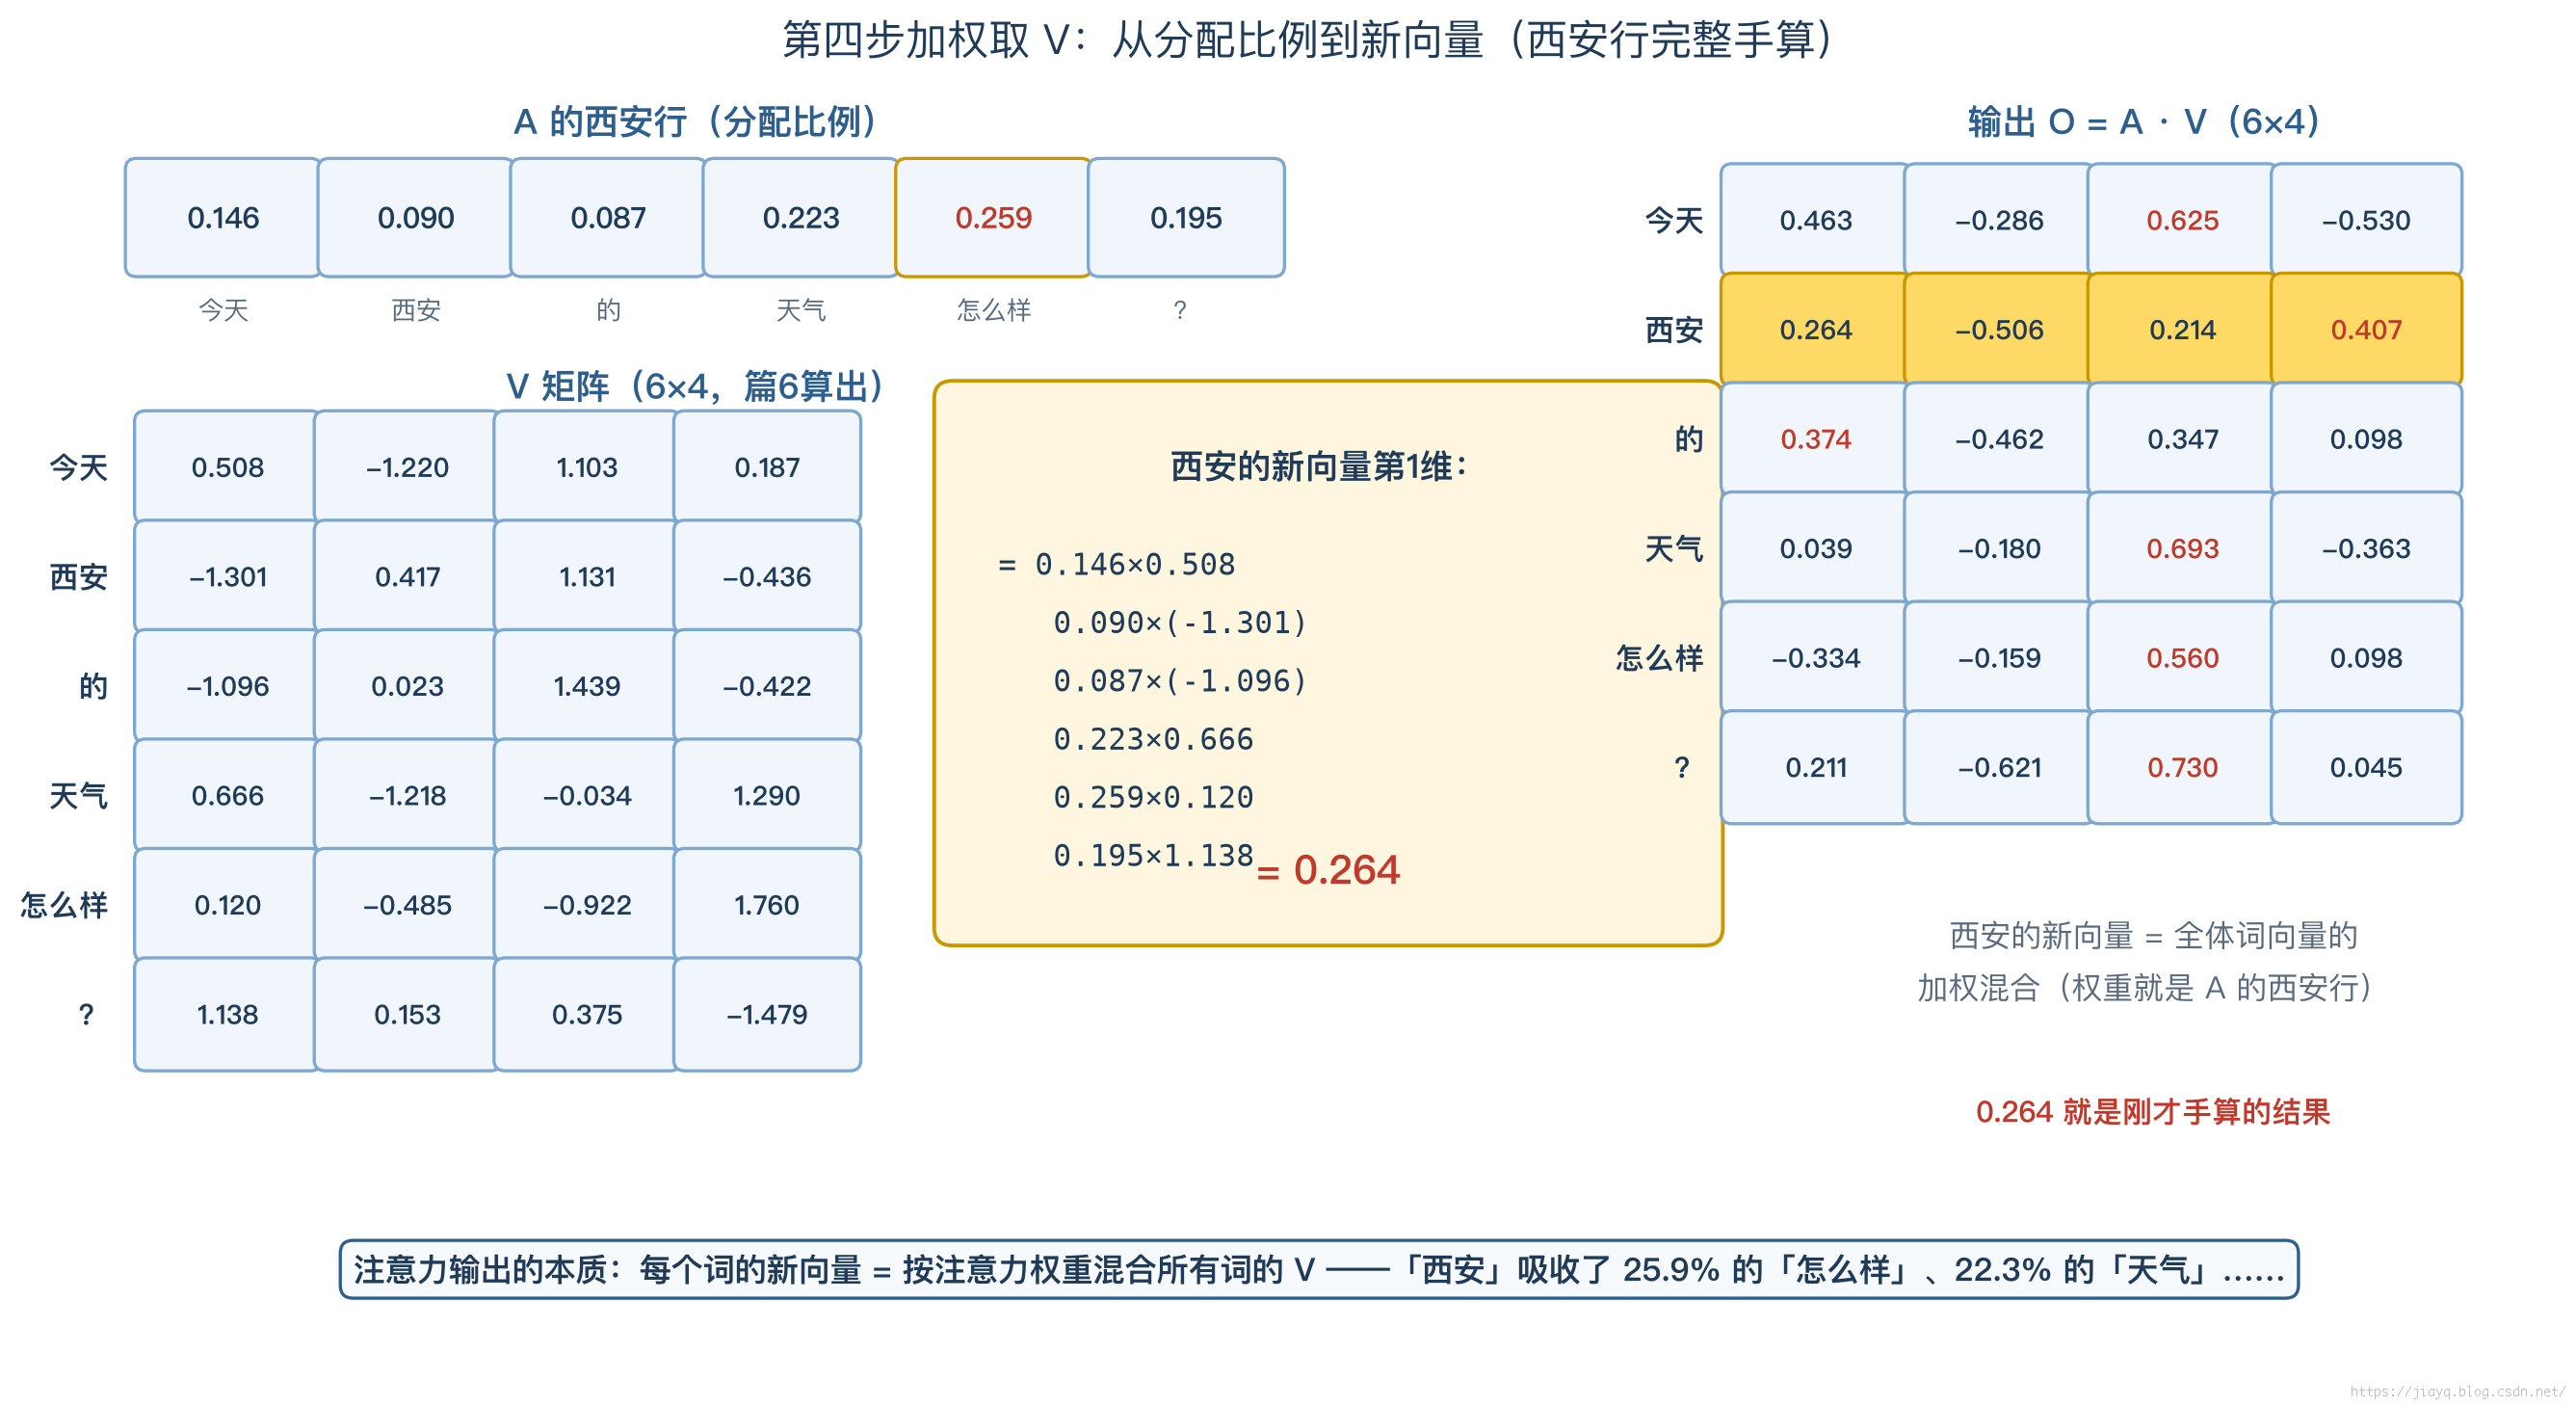
图7-7 第四步加权取 V:从分配比例到新向量(西安行完整手算)
\[0.146 \times 0.508 + 0.090 \times (-1.301) + 0.087 \times (-1.096) + 0.223 \times 0.666 + 0.259 \times 0.120 + 0.195 \times 1.138 = 0.264\]六个词的第 1 维各按「西安」的注意力权重贡献一份,加出「西安」新向量的第 1 维。其他三维同理,得到:
\[\mathbf{O}_{西安} = [0.264,\ -0.506,\ 0.214,\ 0.407]\]完整输出矩阵 $\mathbf{O}$(6×4,图中右侧,红色 = 每行最大值):
\[\mathbf{O} = \begin{bmatrix} \textcolor{red}{0.463} & -0.286 & 0.625 & -0.530 \\ 0.264 & -0.506 & 0.214 & \textcolor{red}{0.407} \\ 0.374 & \textcolor{red}{-0.462} & 0.347 & 0.098 \\ 0.039 & -0.180 & \textcolor{red}{0.693} & -0.363 \\ -0.334 & -0.159 & \textcolor{red}{0.560} & 0.098 \\ 0.211 & -0.621 & \textcolor{red}{0.730} & 0.045 \end{bmatrix}\]到这一步,「西安」的新向量已经不再是”自己的旧向量”,而是吸收了 25.9% 的「怎么样」、22.3% 的「天气」、19.5% 的「?」……的混合体。词与词的信息交换,就这样发生了。这就是篇3 埋下的”上下文”坑的填法:「苹果」的向量,从此会因为旁边是「吃」还是「发布」而不同——因为它的注意力权重不同,混合进来的 V 就不同。
5. 多头机制:一个注意力不够,就并排几个
5.1 为什么一头不够
回看刚才的注意力:一套 Q、K、V 只能产生一种关注模式。但语言关系是多面的——「西安」既要关注”地理位置上谁和我近”(地名关联),又要关注”语法上谁修饰我”(结构关联),还要关注”语义上谁和我构成事件”(天气怎么样 = 提问西安的天气)。一种模式照顾不过来。
5.2 拆分:4096 维切成 32 份
多头注意力的做法:把 4096 维切成 32 份,每份 128 维,每份独立跑一遍完整的四步注意力(打分、缩放、Softmax、加权取 V),最后把 32 个头的输出拼接回 4096 维,再乘一个输出投影矩阵 $\mathbf{W}_O$。流程如图 7-8 所示。
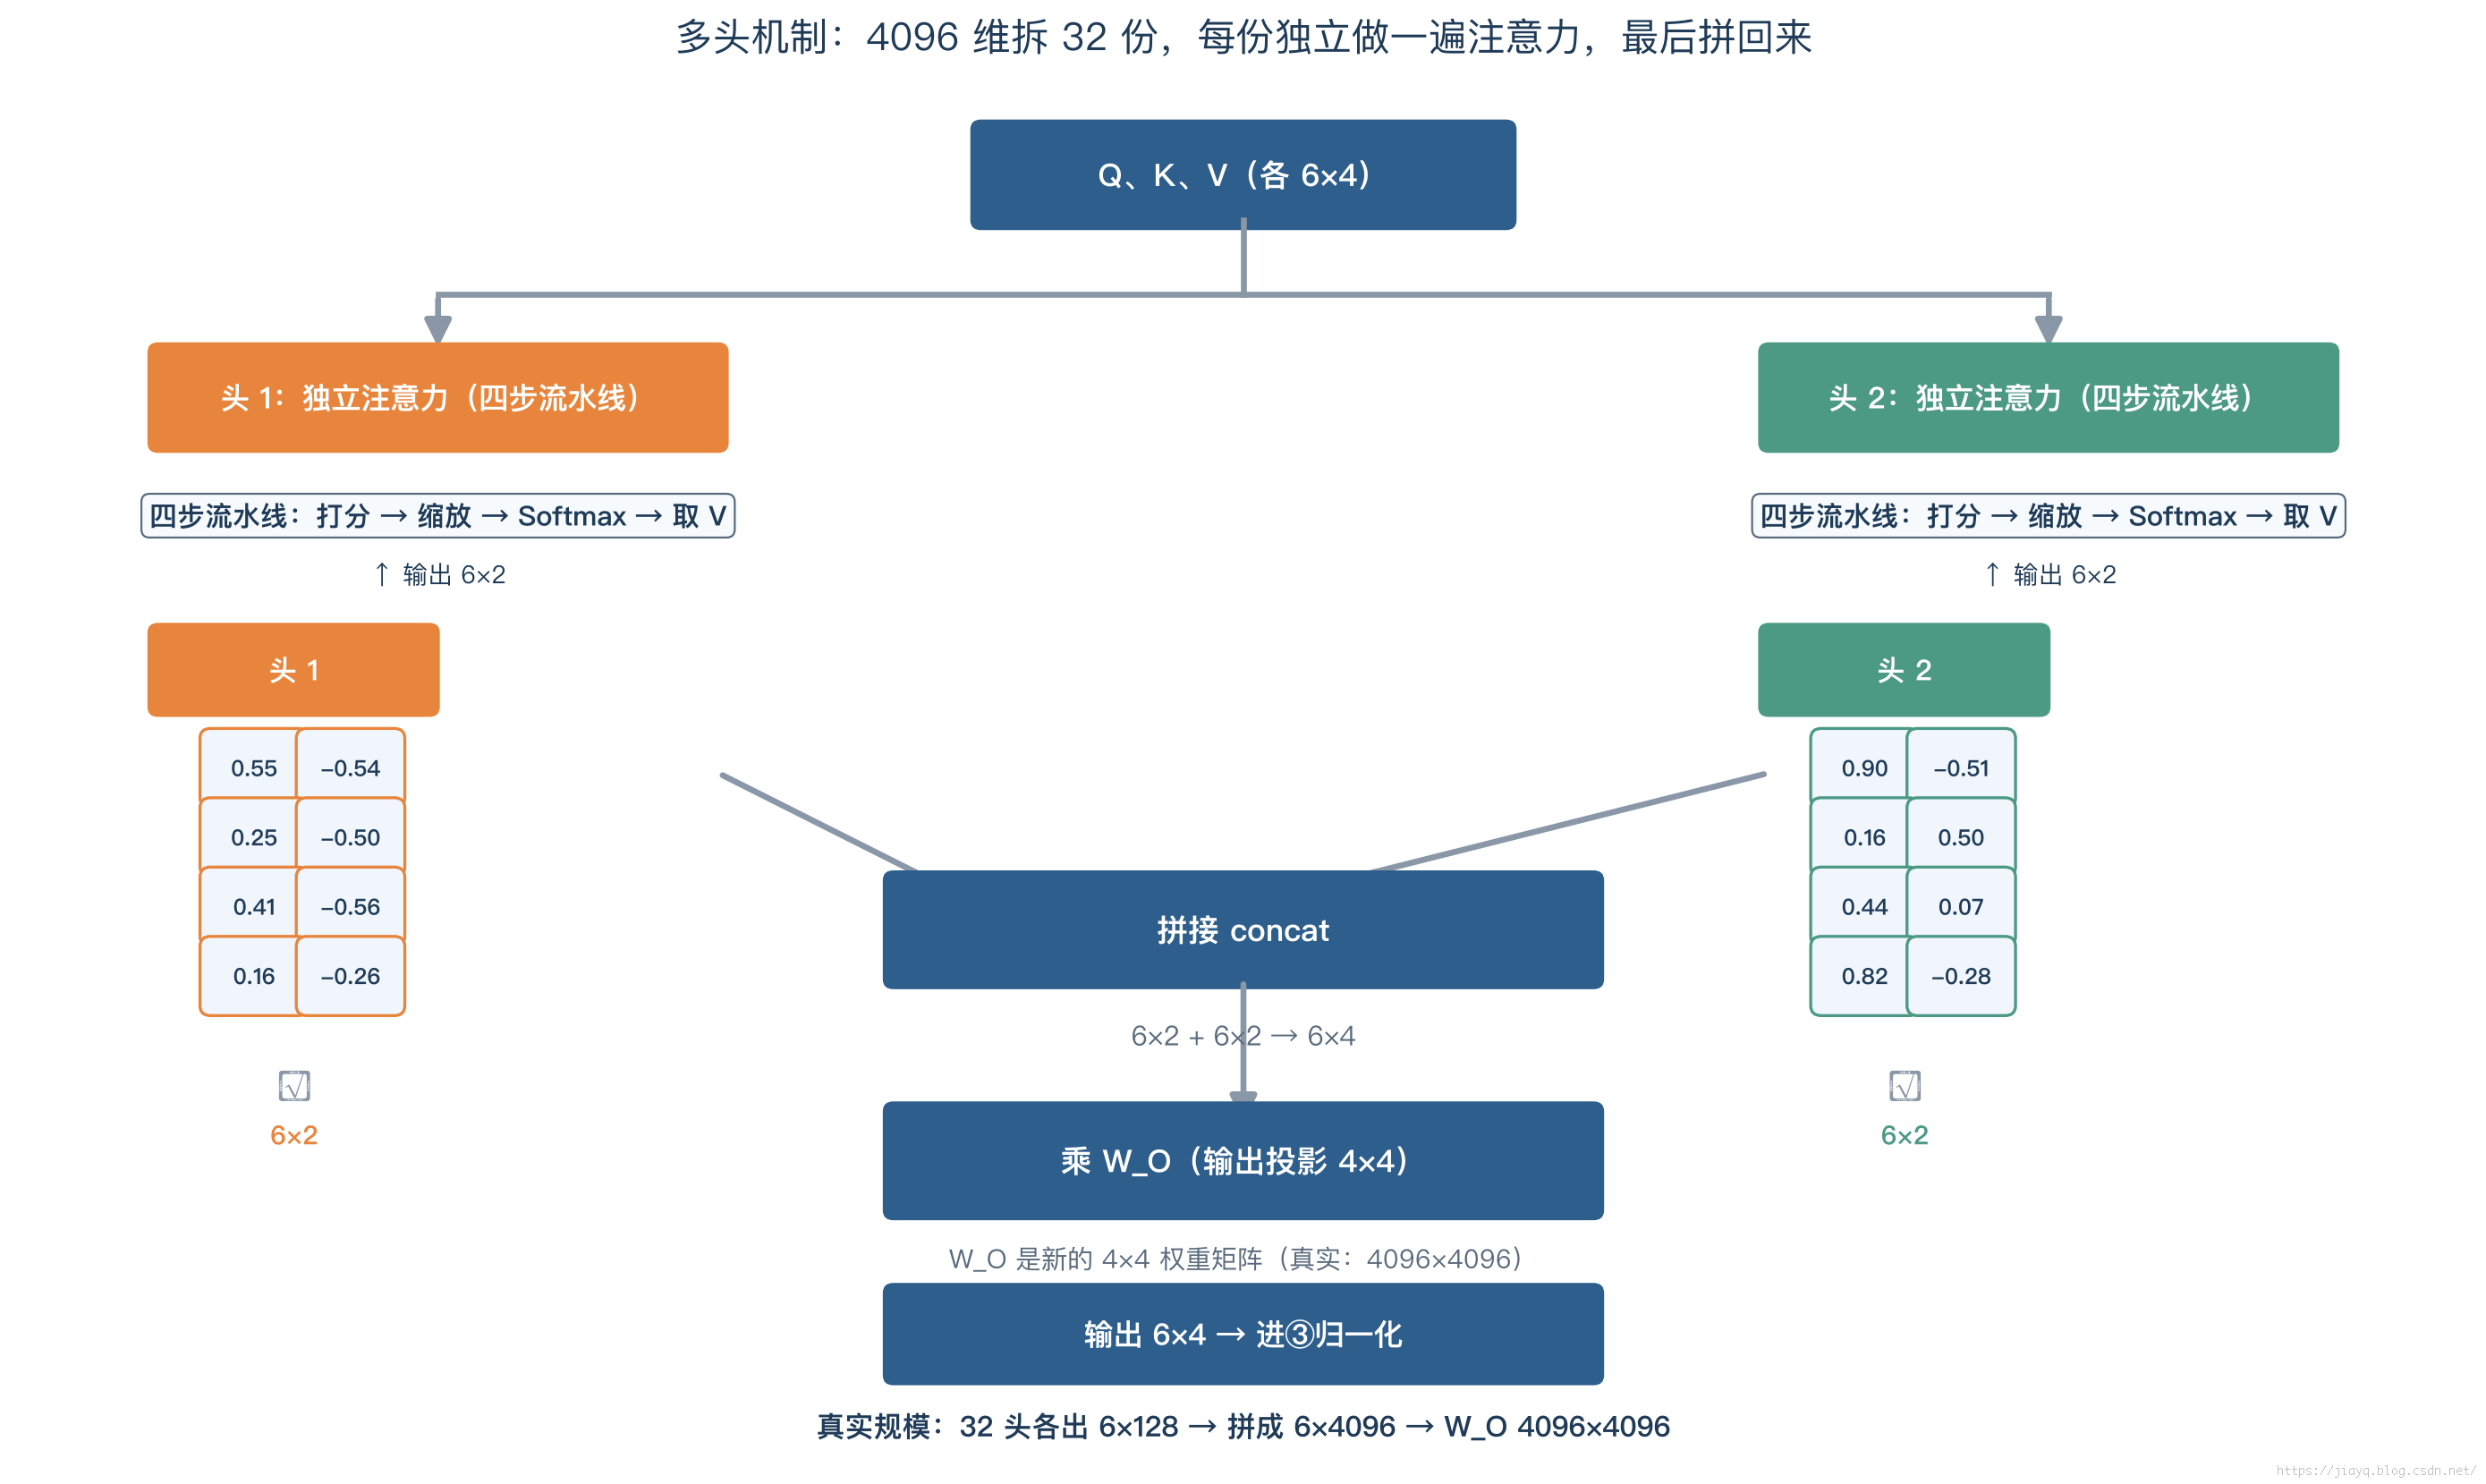
图7-8 多头机制:4096 维拆 32 份,每份独立做一遍注意力,最后拼回来
用演示规模体会:d=4 拆 2 头,头 1 用 d₁d₂ 维度、头 2 用 d₃d₄ 维度,各自独立算注意力。关键观察:两个头算出的关注点真的不一样,如图 7-9 所示。
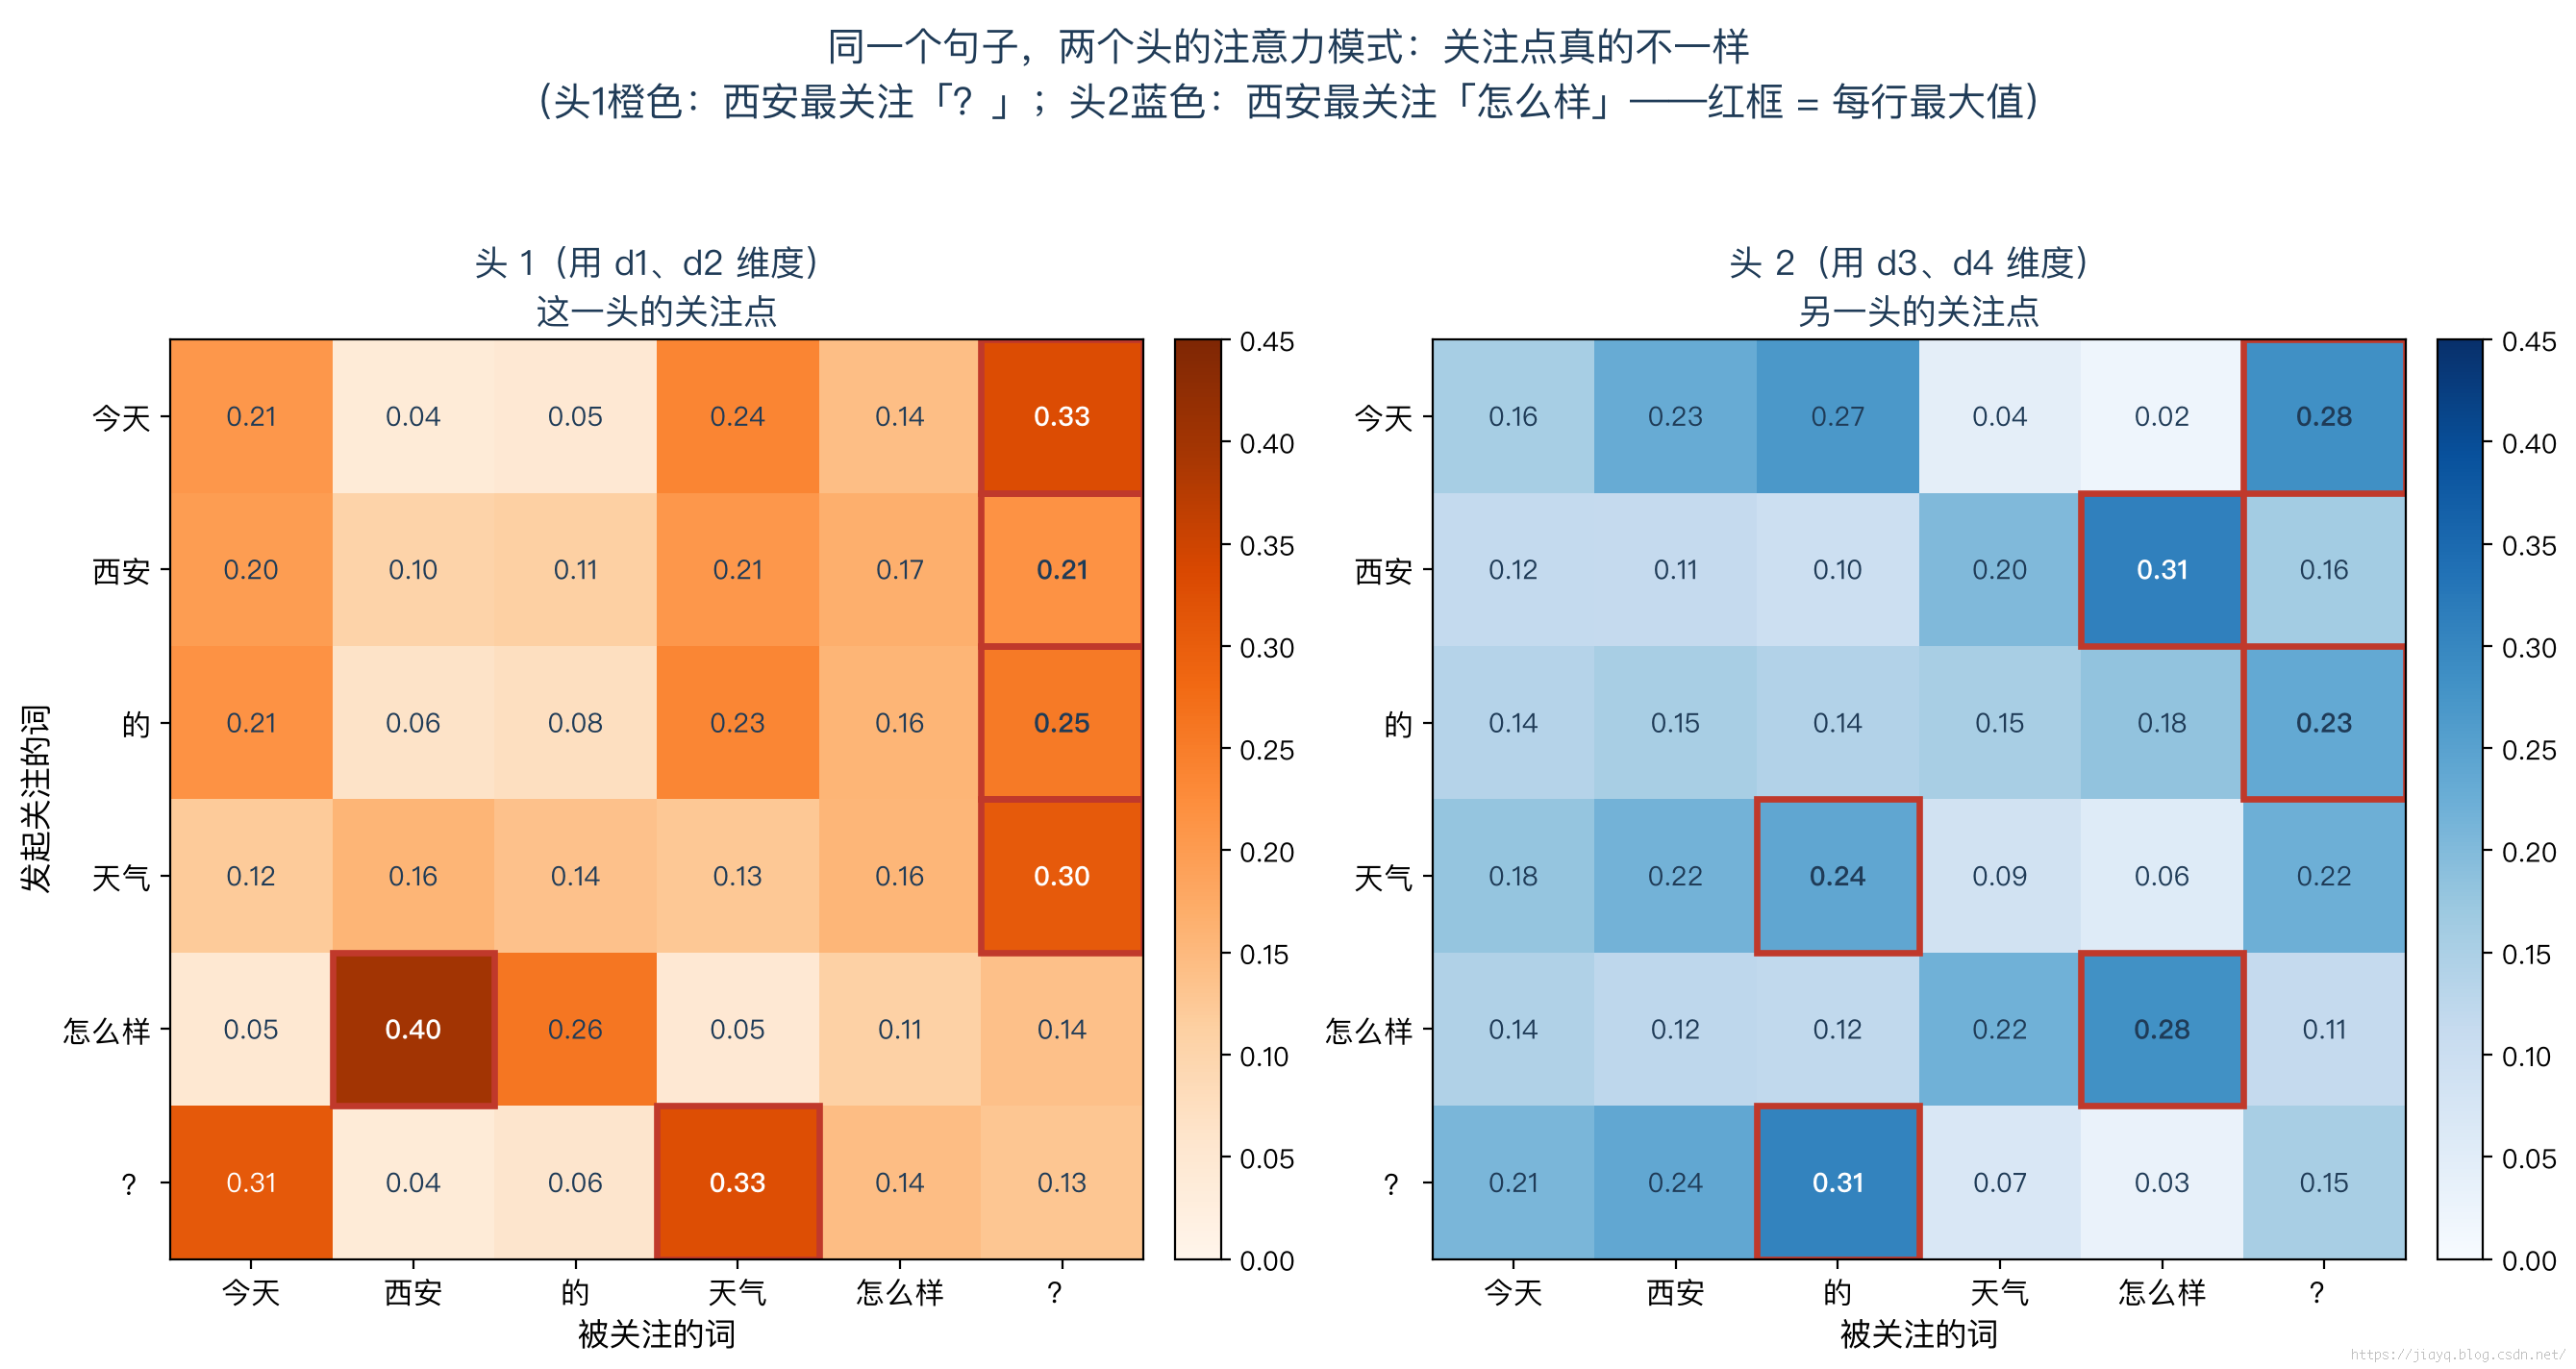
图7-9 同一个句子,两个头的注意力模式:关注点真的不一样
- 头 1 里,「西安」最关注「?」(0.215)
- 头 2 里,「西安」最关注「怎么样」(0.310)
同一句话、同一个「西安」,两个头各自捕捉不同的关联——这就是篇6 第 8 节讨论的”多视角”需求的工程答案:不新增 QKV 维度,而是把已有维度拆开并行。训练中,32 个头会自发分工:有实证研究(如 BERTology 系列)发现某些头专门盯句法依存、某些头盯指代消解、某些头盯相邻位置——分工不是设计的,是学出来的。
5.3 各家大模型用多少头
主流大模型的头数如图 7-10 所示。
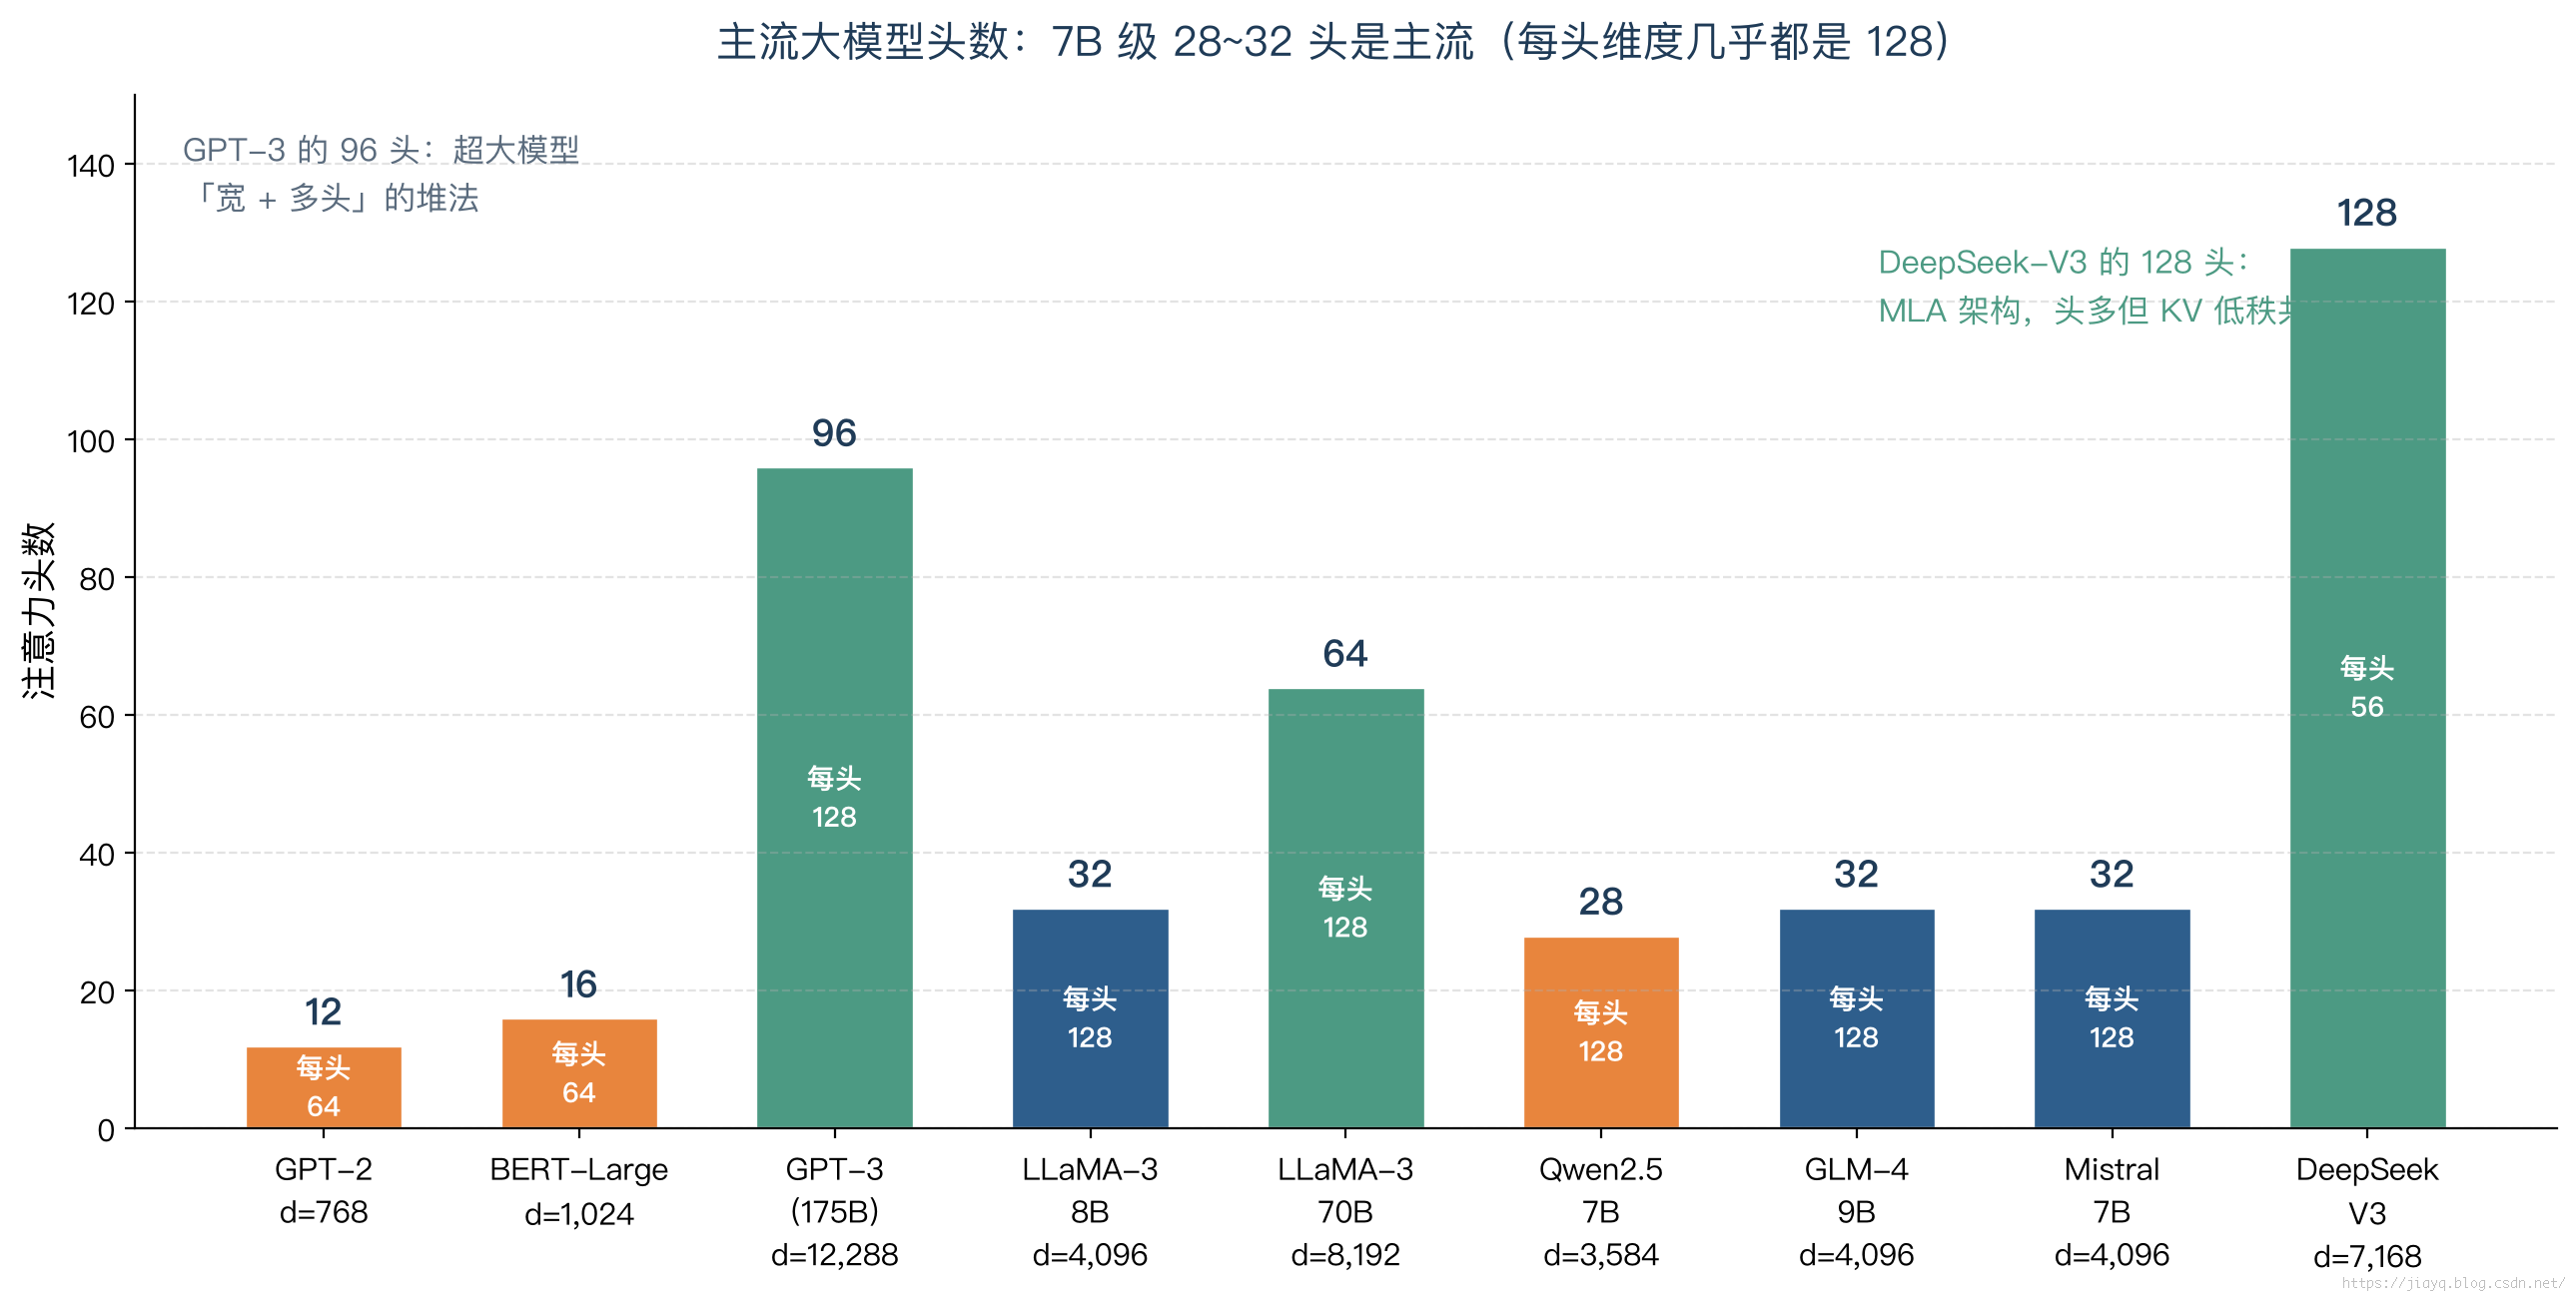
图7-10 主流大模型头数对比(7B 级 28~32 头是主流,每头几乎都是 128 维)
表7-1 主流大模型注意力头数统计
| 模型 | 头数 | d_model | 每头维度 |
|---|---|---|---|
| GPT-2 | 12 | 768 | 64 |
| BERT-Large | 16 | 1024 | 64 |
| GPT-3 (175B) | 96 | 12288 | 128 |
| LLaMA-3-8B | 32 | 4096 | 128 |
| LLaMA-3-70B | 64 | 8192 | 128 |
| Qwen2.5-7B | 28 | 3584 | 128 |
| GLM-4-9B | 32 | 4096 | 128 |
| Mistral-7B | 32 | 4096 | 128 |
| DeepSeek-V3 | 128 | 7168 | 56(MLA 特殊结构) |
规律很明显:7B~9B 级模型清一色 28~32 头,每头维度几乎都是 128。这就是本系列取 32 头作为”真实规模”标注的依据——它是多数派。128 的每头维度是实践反复验证的甜点:更小表达力不够,更大则头数(模式数量)就得减少,两头不讨好。DeepSeek-V3 的 128 头是 MLA 架构的特例(KV 低秩共享,头多但 KV 不膨胀),GPT-3 的 96 头是超大模型”宽 + 多头”的堆法。
5.4 怎么”分辨”是哪些头
一个自然的疑问:32 个头各管什么,能提前知道吗?不能指定,只能事后观察。每个头有独立的 $\mathbf{W}_Q^{(h)}$、$\mathbf{W}_K^{(h)}$、$\mathbf{W}_V^{(h)}$(各 128×4096),初始化随机、训练自由分工。训练完把各头的注意力权重画成热力图,才能发现”这个头原来在盯句法”。
复盘一下图 7-9 的观察方法:逐行找红框(行最大值)——头 1 里「西安」的红框落在「?」上(0.215),头 2 里落在「怎么样」上(0.310);「怎么样」在头 1 里最关注「西安」(0.398),头 2 里最关注「怎么样」(0.283,自引用反而变高)。同一对词在不同头里的关注关系不同,就是”分工”的直接证据。真实模型里做同样的事,只不过要从 32 张 6×6 小图里找规律。
而且有研究显示部分头是冗余的——剪掉一些头对效果影响不大,头的数量也存在边际递减。
小结
这一篇,注意力完整闭环:
- 四步流水线:打分 $\mathbf{Q}\mathbf{K}^{\mathrm{T}}$ → 缩放 $\div\sqrt{d_k}$ → Softmax → 加权 $\mathbf{A}\mathbf{V}$
- 缩放的原因:点积方差随维度增长,不缩放 Softmax 饱和 → 梯度消失 → 训练躺平
- Softmax 手算:西安行四步 $[-0.20, -0.68, -0.72, 0.23, 0.38, 0.09] \to [0.146, 0.090, 0.087, 0.223, 0.259, 0.195]$
- 缩放实证:「今天→?」权重 0.734(不缩放)vs 0.457(缩放)——赢家通吃变均衡分配
- 加权取 V:「西安」新向量 = 25.9% 怎么样 + 22.3% 天气 + … 的混合,第 1 维手算 = 0.264
- 多头:4096 维拆 32 份各跑一遍;两头实证关注点不同(西安在头1最关注?、头2最关注怎么样)
- 头数现状:7B 级 28~32 头、每头 128 维是主流(LLaMA-3/GLM-4/Mistral 32 头,Qwen2.5 28 头)
下一篇预告
注意力输出 $\mathbf{O}$ 拿到了,但 Block 的②还没走完:$\mathbf{O}$ 要加上残差(原始输入直通快车道),再进③归一化、④前馈网络 FFN。
下一篇讲残差连接和 FFN 这对搭档:为什么”原始输入原样加回”能训出几十层的深网络(高速公路的比喻);FFN 的”升维-激活-降维”三段式怎么让每个词独立深加工——它一个子层的参数量,比整个注意力层还多 2~3 倍。
系列目录:
- 从一条直线到高维空间
- 分词与 token 表
- 隐藏层与嵌入
- 位置编码 RoPE
- Transformer Block 全景与层归一化
- QKV 三剑客
- 注意力权重与多头机制(当前篇)
- 残差连接与前馈网络
- 输出矩阵与多层堆叠
- 首 token 诞生与 KV-Cache
版权声明:本文为博主原创文章,遵循 CC 4.0 BY-SA 版权协议,转载请附上原文出处链接和本声明。