hadoop集群的搭建以及hadoop的配置
hadoop集群的搭建以及hadoop的配置环境说明与目的配置说明准备hadoop-env.shcore-site.xmlhdfs-site.xmlyarn-site.xmlmapred-site.xmllog4j.propertiesssh 免密启动验证界面任务历史任务提交总结环境说明与目的准备:我自己准备了三台虚拟机在windows平台上使用Hyper-V搭建虚拟机集群环境_a18792721831的博客-CSDN博客环境如下主机nameNodedataNoderesourceMa_修改hadoop-env. sh说hadoop没有找到
文章信息
- 原文链接:https://jiayq.blog.csdn.net/article/details/122612167
- 发布时间:2022-01-20 23:20:04
- 阅读量:3
- 分类:大数据同时被 2 个专栏收录, 订阅专栏, hadoop
- 标签:#hadoop, #hdfs, #big data
摘要
文章浏览阅读3.2k次,点赞2次,收藏9次。hadoop集群的搭建以及hadoop的配置环境说明与目的配置说明准备hadoop-env.shcore-site.xmlhdfs-site.xmlyarn-site.xmlmapred-site.xmllog4j.propertiesssh 免密启动验证界面任务历史任务提交总结环境说明与目的准备:我自己准备了三台虚拟机在windows平台上使用Hyper-V搭建虚拟机集群环境_a18792721831的博客-CSDN博客环境如下主机nameNodedataNoderesourceMa_修改hadoop-env. sh说hadoop没有找到
hadoop集群的搭建以及hadoop的配置
- 环境说明与目的
- 配置说明
- 准备
- hadoop-env.sh
- core-site.xml
- hdfs-site.xml
- yarn-site.xml
- mapred-site.xml
- log4j.properties
- 准备
- ssh 免密
- 启动
- 验证
- 界面
- 任务历史
- 任务提交
- 界面
- 总结
环境说明与目的
准备:我自己准备了三台虚拟机在windows平台上使用Hyper-V搭建虚拟机集群环境_a18792721831的博客-CSDN博客
环境如下
| 主机 | nameNode | dataNode | resourceManager | nodeManager | 对外开放 |
|---|---|---|---|---|---|
| hadoop01 | 启动 | 不启动 | 启动 | 不启动 | 开放 |
| hadoop02 | 不启动 | 启动 | 不启动 | 启动 | 不开放 |
| hadoop03 | 不启动 | 启动 | 不启动 | 启动 | 不开放 |
这是一个典型的主-从结构的集群环境,主节点是hadoop01,从节点是hadoop02,hadoop03。
从节点的数据不对外暴露,所有的界面查询和作业提交全部要通过主节点。因为在主节点上可能还会启动mysql,hive等,所以主节点不保存数据,不参与计算,只做调度,管理。
这三台节点的配置都相同,2核,最大2G内存,最大15G硬盘
目的
目的很简单,就是让hadoop集群实现主从的集群。谈不上高可用,hadoop01挂了,整个集群就完了,所以,这种应该是伪分布式集群。
配置说明
hadoop的主目录为/hadoop,每个节点的目录相同。
准备
准备目录:
- hdfs 数据目录
/hadoop/dfs/name:nameNode 的数据保存目录
/hadoop/dfs/data:dataNode 的数据保存目录
- yarn 数据目录
/hadoop/yarn/data:nodeManager的中间数据的保存目录
/hadoop/yarn/logs:nodeManager的日志保存目录
- hadoop日志目录
/hadoop/logs:hadoop的日志保存目录
- hadoop临时目录
/hadoop/tmp:hadoop的临时数据目录
基本上上去的目录在全部的节点上都进行创建。
确保/etc/hosts中配置了域名和ip的映射关系,而且保证地址和域名没有重复。
hadoop-env.sh
1
2
3
4
5
6
7
8
9
10
11
12
13
14
# 配置java环境
export JAVA_HOME=/java
# 配置hadoop的配置目录
export HADOOP_CONF_DIR=${HADOOP_CONF_DIR:-"/etc/hadoop"}
# 配置hadoop的jvm的参数,一般用于hadoop的性能调休之类的
export HADOOP_OPTS="$HADOOP_OPTS -Djava.net.preferIPv4Stack=true"
# 配置 hdfs 的 nameNode 的jvm的参数,用于hdfs 的 nameNode 的调优
export HADOOP_NAMENODE_OPTS="-Dhadoop.security.logger=${HADOOP_SECURITY_LOGGER:-INFO,RFAS} -Dhdfs.audit.logger=${HDFS_AUDIT_LOGGER:-INFO,NullAppender} $HADOOP_NAMENODE_OPTS"
# 配置 hdfs 的 dataNode 的jvm 的参数,用于hdfs的 dataNode 的调优
export HADOOP_DATANODE_OPTS="-Dhadoop.security.logger=ERROR,RFAS $HADOOP_DATANODE_OPTS"
# 配置 yarn 的 辅助 nameNode 的 jvm 的参数
export HADOOP_SECONDARYNAMENODE_OPTS="-Dhadoop.security.logger=${HADOOP_SECURITY_LOGGER:-INFO,RFAS} -Dhdfs.audit.logger=${HDFS_AUDIT_LOGGER:-INFO,NullAppender} $HADOOP_SECON
# 配置hadoop的进程id
export HADOOP_PID_DIR=${HADOOP_PID_DIR}
上面除了Java的配置,其他的都可以不做任何修改,实际上,你如果在环境变量中配置了JAVA_HOME,那么这一步完全是可以省去的。
core-site.xml
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
<configuration>
  <!-- 配置 hdfs 的地址,统一通信地址 -->
  <property>
    <name>fs.defaultFS</name>
    <value>hdfs://hadoop01:8020</value>
  </property>
  <!-- 配置 hadoop 的临时目录 -->
  <property>
    <name>hadoop.tmp.dir</name>
    <value>/hadoop/tmp</value>
  </property>
  <!-- 配置读写缓存大小 -->
  <property>
    <name>io.file.buffer.size</name>
    <value>131072</value>
  </property>
</configuration>
hdfs的地址是必须的,其他都可以使用默认。默认使用的临时目录是系统的临时目录/tmp
默认的读写缓存大小就是131072
hdfs://hadoop01:8020
表示hadoop01的节点负责hdfs的元数据交互。
hdfs-site.xml
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
<configuration>
  <!-- 节点的名字 -->
  <property>
    <name>name</name>
    <value>hadoop01</value>
  </property>
  <!-- 配置 hdfs 的 web 的访问端口 -->
  <property>
    <name>dfs.namenode.http-address</name>
    <value>hadoop01:9870</value>
  </property>
  <!-- 配置 hdfs 的 nameNode 的数据存储目录 -->
  <property>
    <name>dfs.namenode.name.dir</name>
    <value>file:/hadoop/dfs/name</value>
  </property>
  <!-- 配置 hdfs 的dataNode 的数据存储目录 -->
  <property>
    <name>dfs.datanode.data.dir</name>
    <value>file:/hadoop/dfs/data</value>
  </property>
  <!-- 配置 hdfs 中数据的副本数量 -->
  <property>
    <name>dfs.replication</name>
    <value>1</value>
  </property>
  <!-- 配置 hdfs 中数据块的大小 -->
  <property>
    <name>dfs.blocksize</name>
    <value>2097152</value>
  </property>
  <!-- 配置哪些节点是 hdfs 的 dataNode -->
  <!-- 允许启动 dataNode 的主机 -->
  <property>
    <name>dfs.hosts</name>
    <value>/hadoop/etc/hadoop/slaves</value>
  </property>
  <!-- 配置哪些节点不是 hdfs 的 dataNode -->
  <!-- 不允许启动 dataNode -->
  <property>
    <name>dfs.hosts.exclude</name>
    <value>/hadoop/etc/hadoop/masters</value>
  </property>
</configuration>
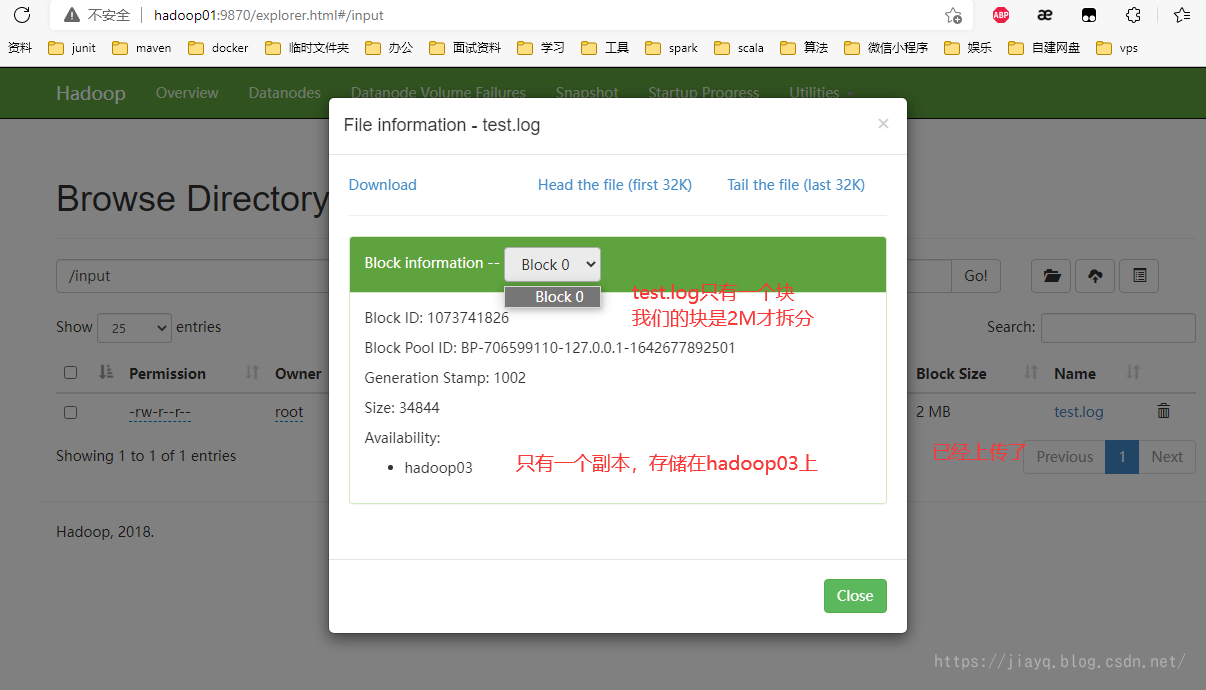
默认的 hdfs 的数据块的大小是 256M ,我这里修改为了 2M,也就是当文件的大小超过2M就会进行拆分。
yarn-site.xml
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
<configuration>

<!-- Site specific YARN configuration properties -->
  <!-- mapreduce 的 shuffle 的服务 -->
  <property>
    <name>yarn.nodemanager.aux-services</name>
    <value>mapreduce_shuffle</value>
  </property>
  <!-- 客户端提交作业的地址,端口可以自己指定,但是需要全部节点配置相同 -->
  <property>
    <name>yarn.resourcemanager.address</name>
    <value>hadoop01:8032</value>
  </property>
  <!-- ApplicationMaster 和 scheduler 查询资源信息的地址,端口可以自己指定,全部节点配置相同 -->
  <property>
    <name>yarn.resourcemanager.scheduler.address</name>
    <value>hadoop01:8030</value>
  </property>
  <!-- 资源上报信息,端口可以自己指定,全部节点配置相同 -->
  <property>
    <name>yarn.resourcemanager.resource-tracker.address</name>
    <value>hadoop01:8031</value>
  </property>
  <!-- resource manager web ui 的地址,端口可以自己自定,全部节点配置相同 -->
  <property>
    <name>yarn.resourcemanager.webapp.address</name>
    <value>hadoop01:8088</value>
  </property>
  <!-- 一般只配置这个就行了,这个配置的优先级低于上述配置 -->
  <property>
    <name>yarn.resourcemanager.hostname</name>
    <value>hadoop01</value>
  </property>
  <!-- 允许启动 resourcemanager 的节点,配置这个的允许启动nodeManager和resourceManager -->
  <!-- 这两个配置可以用于区分yarn和hdfs的节点,比如哪些节点启动yarn,哪些节点启动hdfs -->
  <!--
  <property>
    <name>yarn.resourcemanager.nodes.include-path</name>
    <value>/hadoop/etc/hadoop/masters</value>
  </property>
  -->
  <!-- 不允许启动 resourcemanager 的节点,配置这个的nodeManager也不会启动 -->
  <!--
  <property>
    <name>yarn.resourcemanager.nodes.exclude-path</name>
    <value>/hadoop/etc/hadoop/slaves</value>
  </property>
  -->
  <!-- nodemanager 中管理的内存资源总量 -->
  <!-- 我们公有两个节点参与计算,每个节点最大内存是2G,所以总共是4G -->
  <property>
    <name>yarn.nodemanager.resource.memory-mb</name>
    <value>4096</value>
  </property>
  <!-- nodemanager 中中间数据的目录 -->
  <property>
    <name>yarn.nodemanager.local-dirs</name>
    <value>file:///hadoop/yarn/data</value>
  </property>
  <!-- nodemanager 日志数据的目录 -->
  <property>
    <name>yarn.nodemanager.log-dirs</name>
    <value>file:///hadoop/yarn/logs</value>
  </property>
</configuration>
这里需要我们创建一个文件masters,slaves是原本就有的,默认是localhost。
masters中是可以成为主节点的主机列表,如果你这里配置一个,那么就是单机版的主节点,如果这里配置多个,那么就是主节点集群。
我个人认为,hadoop中实际上的主从划分的标准,就是节点上是否启动了管理服务,比如hdfs的nameManager,yarn的resourceManager。
所以如果有多个节点启动了这些管理服务,而且你在配置中允许这些节点进行数据查询,或者数据分发,那么就可以认为是主节点集群。
个人观点。。
slaves中是从节点的主机列表,主要是用于数据的存储和计算。
在上面的yarn-site.xml中,我将yarn和hdfs绑定在一起了。因为在hdfs-site.xml中使用的masters,slaves文件与yarn-site.xml中使用的masters.slaves文件是相同的文件。
如果需要更加细致的划分,更灵活的划分,那么可以进行分割,hdfs使用一套配置,yarn使用一套配置。
这样的话,哪个节点上启动什么服务,能提供什么样的功能都是可以灵活的指定的。
mapred-site.xml
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
<configuration>
  <!-- 执行框架 yarn -->
  <property>
    <name>mapreduce.framework.name</name>
    <value>yarn</value>
  </property>
  <!-- 历史任务查询地址 -->
  <property>
    <name>mapreduce.jobhistory.address</name>
    <value>hadoop01:9191</value>
  </property>
  <!-- 历史任务web ui 地址 -->
  <property>
    <name>mapreduce.jobhistory.webapp.address</name>
    <value>hadoop01:9192</value>
  </property>
</configuration>
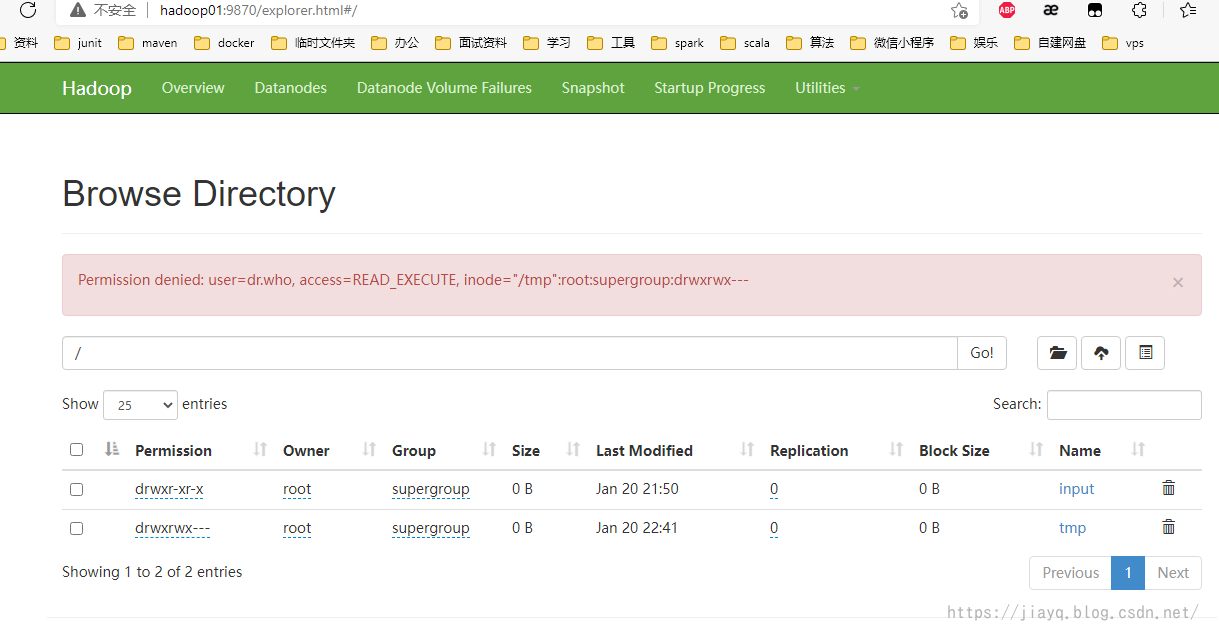
注意,历史任务服务需要单独启动,并且会占用一定的hdfs的存储空间.
存储在/tmp目录下,而且hdfs的界面不允许访问
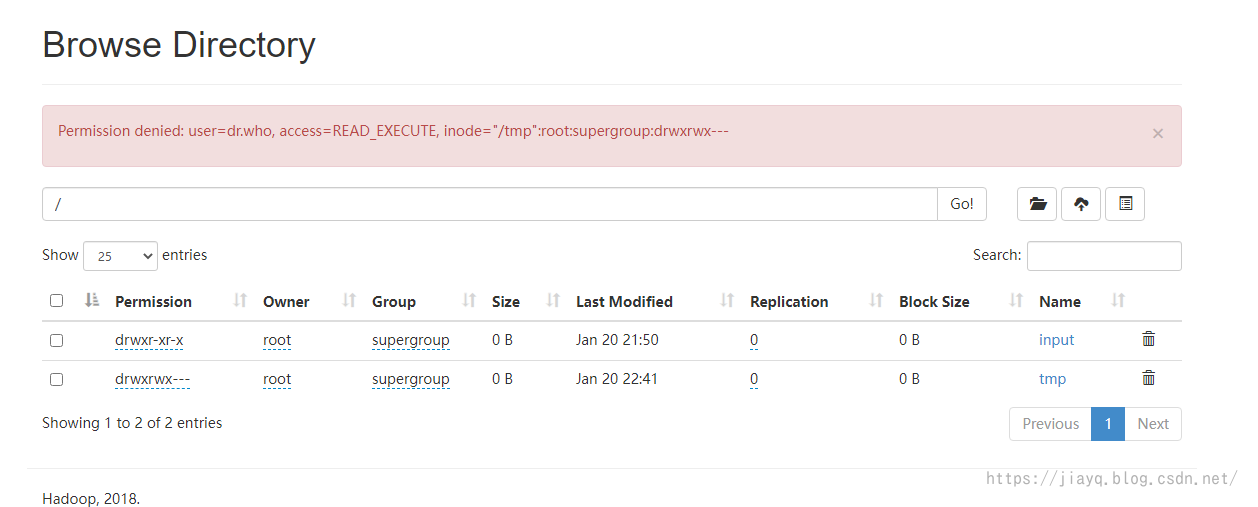
可以使用命令行查看
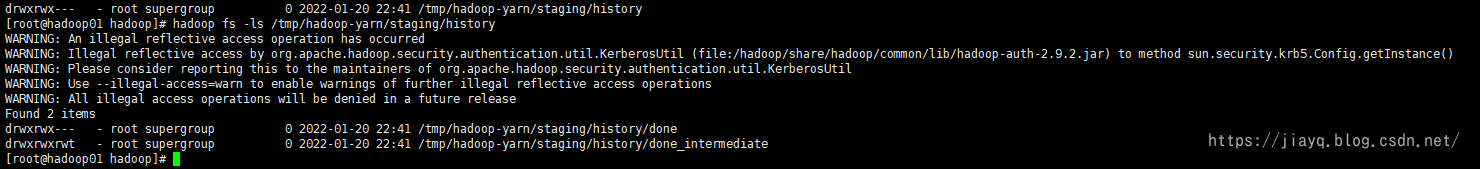
log4j.properties
1
2
3
hadoop.root.logger=INFO,console
hadoop.log.dir=/hadoop/logs
hadoop.log.file=hadoop.log
在这里面主要是指定hadoop的日志目录,以及日志级别等
至此,基本上就配置完成了
ssh 免密
要使三天节点相互之间进行通信,最好是设置免密,免密非常简单
首先在每一个节点中执行ssh-keygen -t rsa,然后一路回车即可,此命令会在~/.ssh目录下生成两个文件id_rsa,id_rsa.pub,分别是私钥和公钥。
三个节点都执行后,就会产生三份公钥。
将三份公钥分别写入~/.ssh/authorized_key 文件内。
这样就实现了ssh免密。
注意:配置完成后,最好手动执行一次,因为第一次链接,需要手动信任证书。
执行ssh hadoop01,会提示是否信任证书,输入yes即可登录hadoop01,接着使用exists退出ssh,接着是ssh hadoop02,ssh hadoop03。
需要每个节点上都这样操作一次。
启动
首先是启动hadoop01上的hadoop,看看我们的配置是否有错误,是否生效。
第一次启动之前,需要使用hadoop namenode -format hadoop进行初始化。如果你把hadoop的目录放到了Path中,那么在任何地方执行都可以。第二个hadoop是指我们将自己的集群的名字设置为hadoop.
初始化没有异常,则会初始化成功。
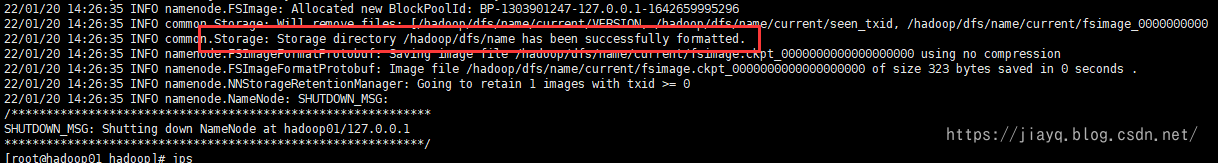
注意日志中是否有打印成功的日志。
接着启动hadoop,切换到hadoop的sbin目录下,执行./start-all.sh脚本。
在启动的时候,hadoop的启动脚本会使用免密的方式,到hadoop02和hadoop03上启动服务,但是因为此时hadoop02和hadoop03我们还没有分发,没有创建相关的文件,所以在启动的时候,会提示目录找不到,脚本找不到等异常
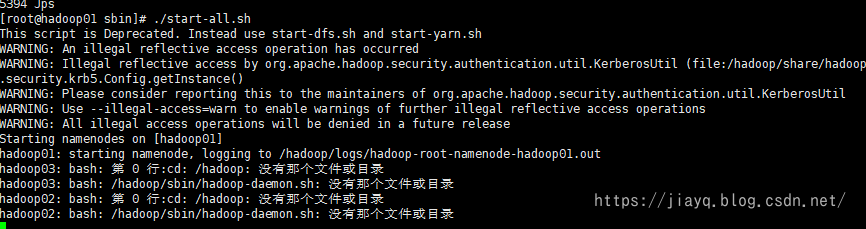
此时使用jps查看启动的服务
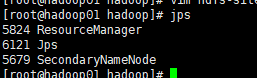
符合我们的预期,只启动了ResourceManager
当出现这个,基本上可以确认我们master的配置是ok的,接下来需要分发hadoop文件到其他节点。
首先到/hadoop/sbin目录下执行./stop-all.sh停止hadoop的服务
接着使用scp -r /hadoop hadoop02:/hadoop将hadoop01上的hadoop目录拷贝到hadoop02的hadoop目录下
传输完成就可以在hadoop02上查看了
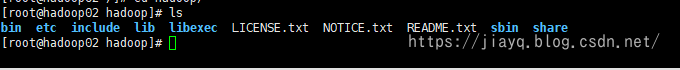
解压后的hadoop文件比较多,需要一定的时间传输。
传输完成后,需要清空准备 中的目录hadoop/tmp,/hadoop/dfs/name,/hadoop/dfs/data,/hadoop/logs,/hadoop/yarn/data,/hadoop/yarn.logs
同样的操作,在hadoop03上也执行一次
非常关键的一步,给/hadoop目录权限,使用chmod -R 777 /hadopp赋予权限,如果你是用hadoop的用户操作,那么这一步省略,如果你是用root用户直接启动,那么这一步必须的。
文件拷贝完成后,需要在hadoop01上重新格式化命名空间hadoop namenode -format hadoop
接着在hadoop01的hadoop/sbin目录下启动./start-all.sh
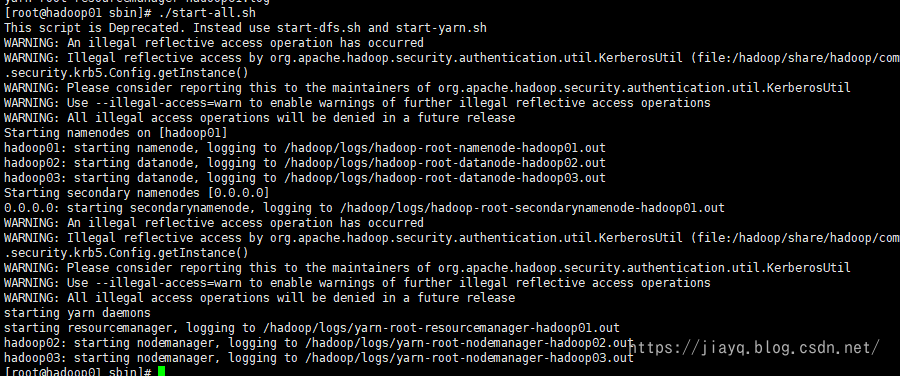
查看和日志输出一致
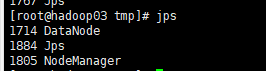
主节点
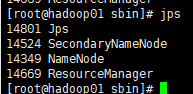
执行./satrt-all.sh后一段时间,nameNode服务终止
查看日志是没有初始化,即使之前我们初始化了一次,但是那是单节点的初始化,不是集群的初始化。
验证
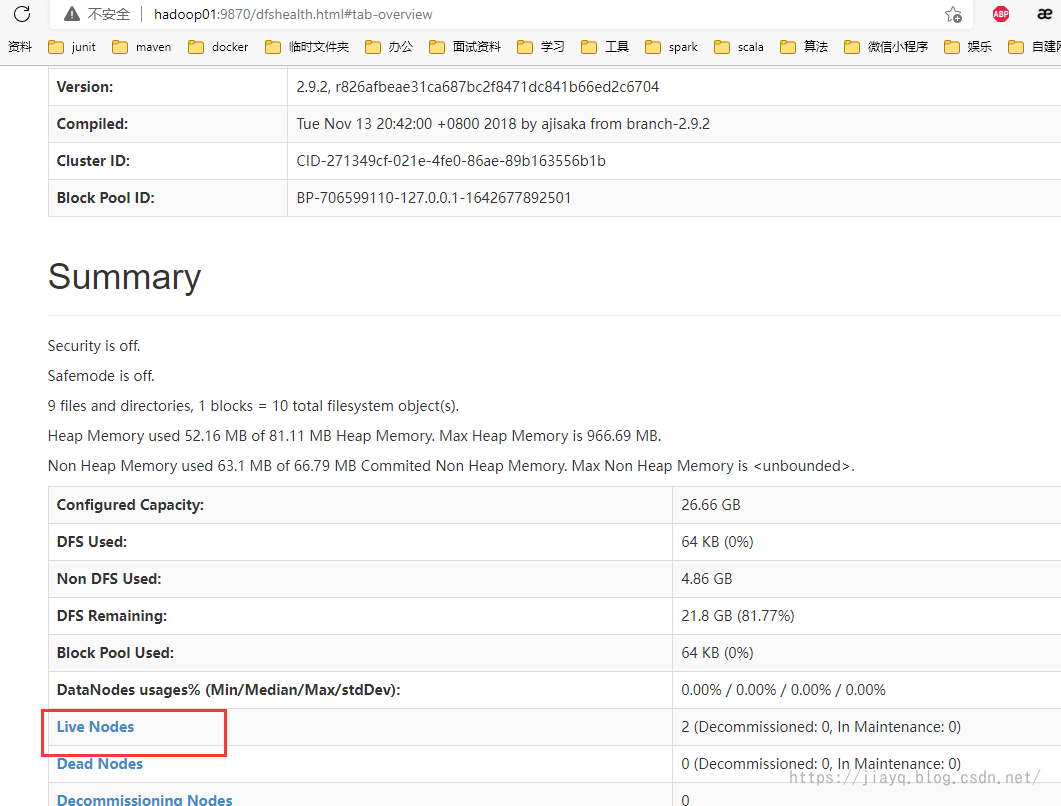
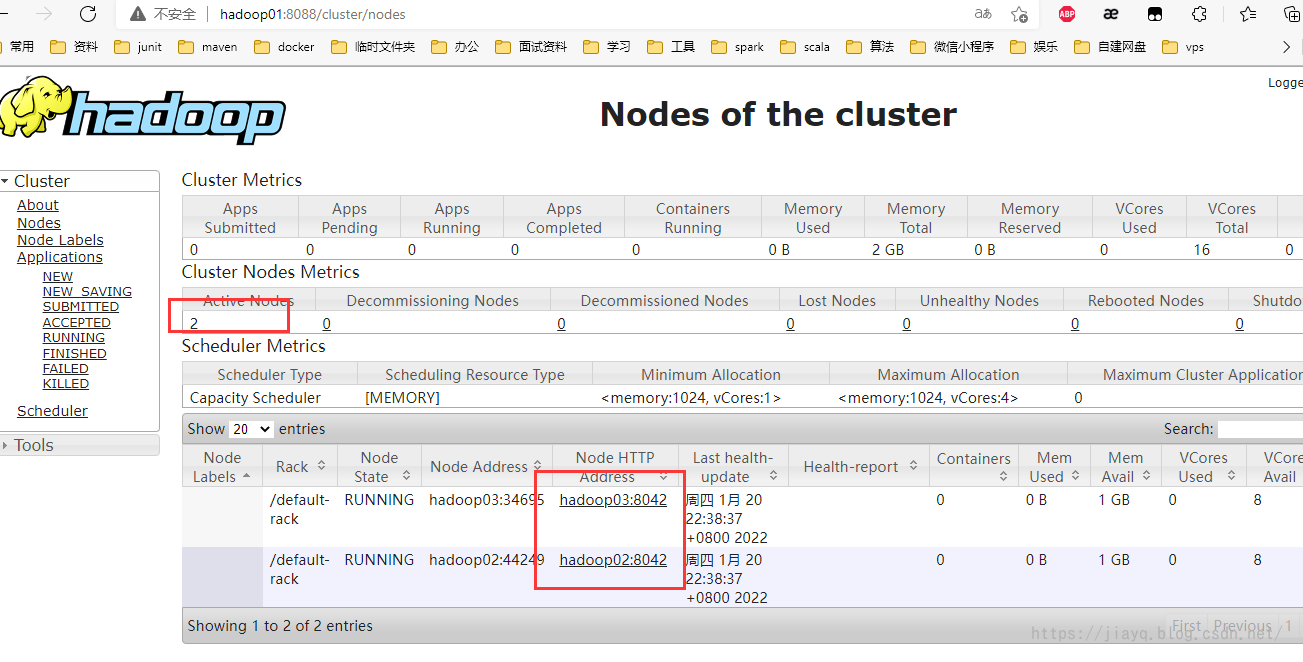
虽然启动成功了hadoop集群,但是是否可用,我们还不知道,需要进行验证
界面
hdfs
yarn
任务历史
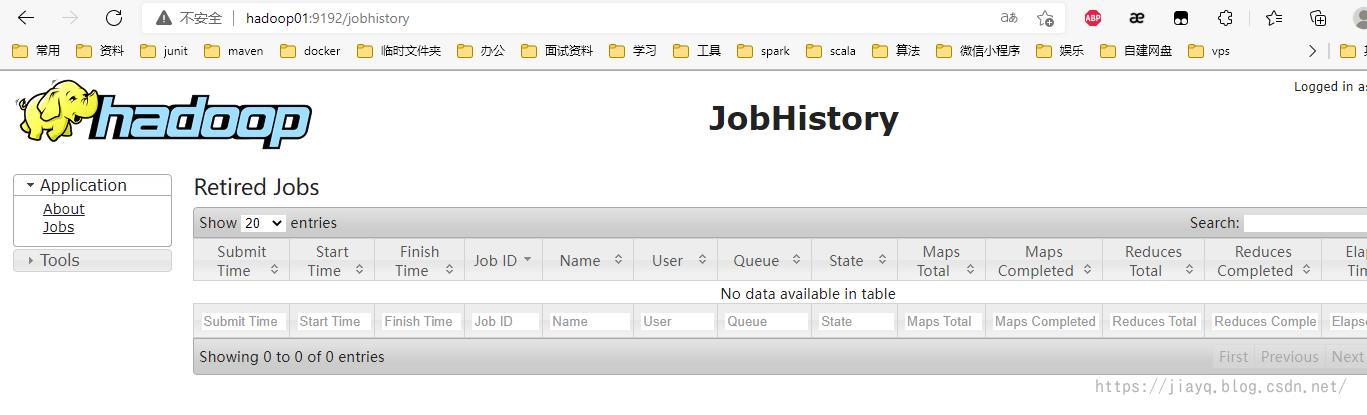
在/hadoop/sbin目录下,执行./mr-jobhistory-daemon.sh start historyserver启动任务历史

接着在mapred-site.xml中配置的地址中就可以访问任务执行历史了
同时也会生成hdfs:/tmp目录
任务提交
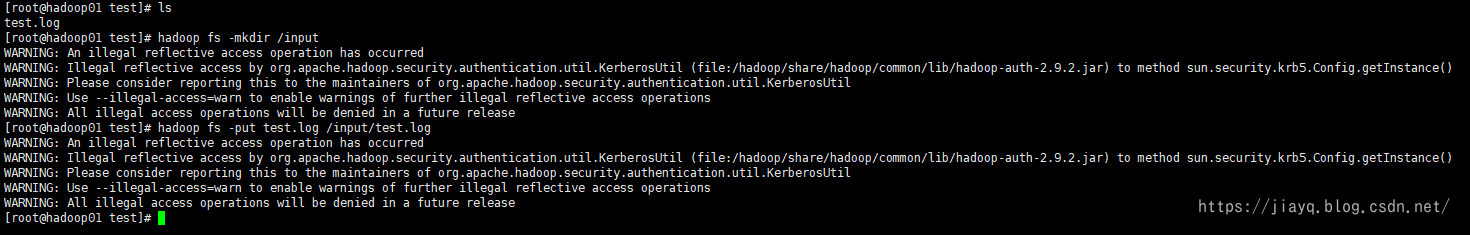
我们拷贝一份nameNode的启动日志到hadoop01的/test目录下,重命名为test.log
然后使用hadoop fs -mkdir /input创建hdfs:/input目录
然后使用hadoop fs -put /test/test.log /input/test.log将test.log上传到hdfs中
查看
还记得wordcount吗
我们使用wordcount统计
执行hadoop jar /hadoop/share/hadoop/mapreduce/hadoop-mapreduce-examples-2.9.2.jar wordcount /input/test.log /output提交作业
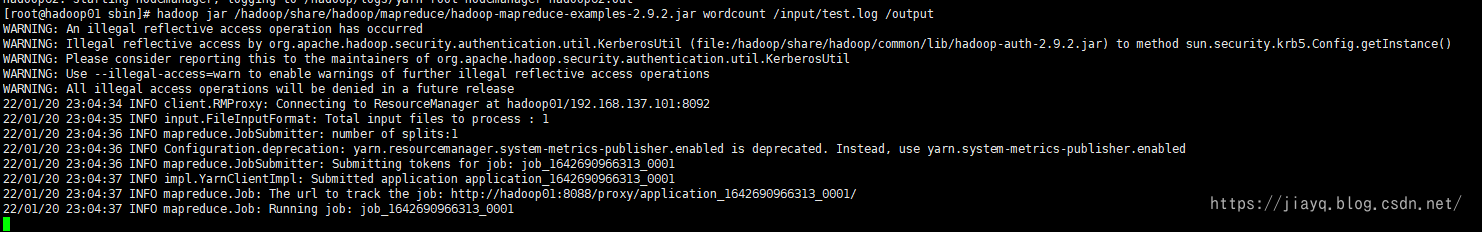
在执行历史中也能看到了
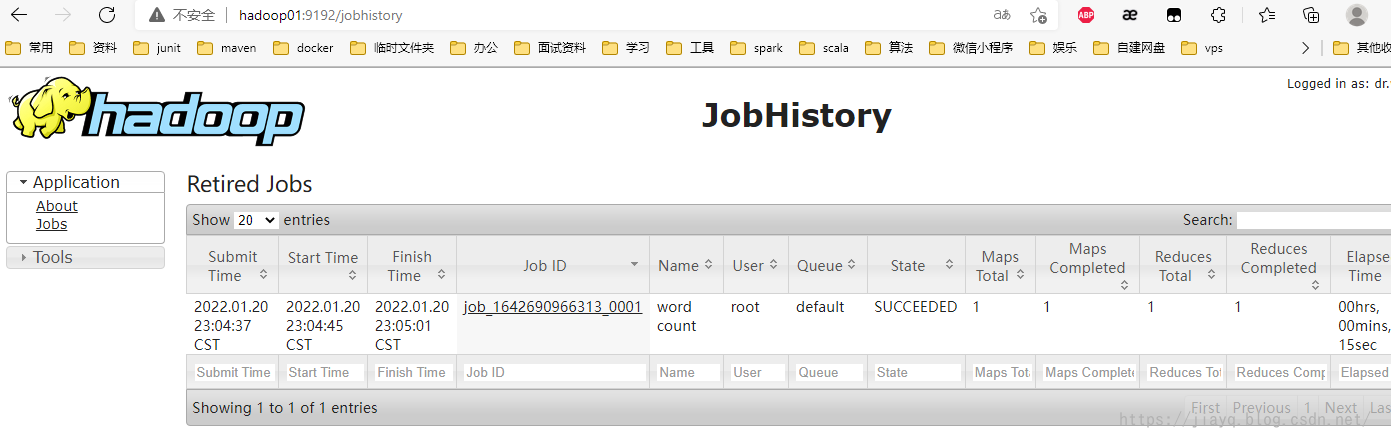
在资源信息界面也能看到了
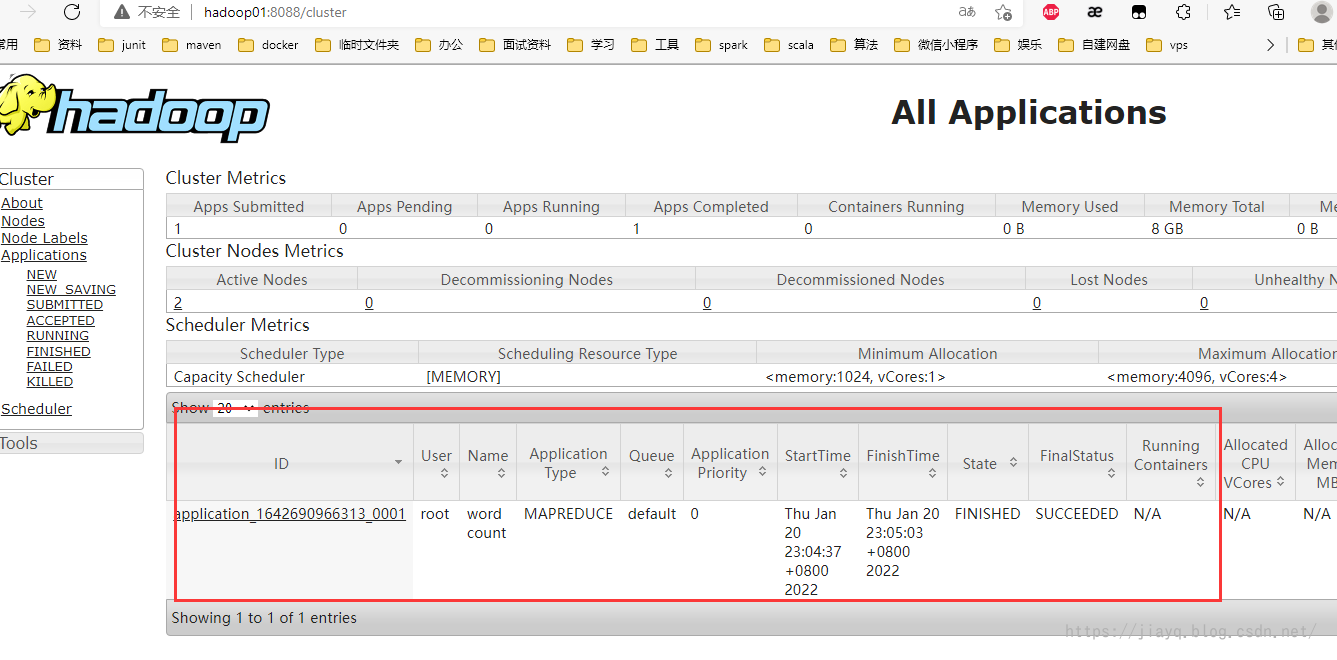
我们的任务也执行完成了
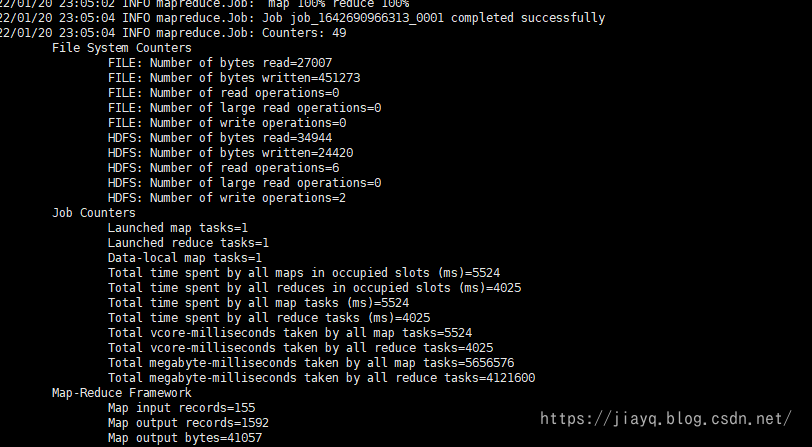
同时在hdfs的界面上也可以查看结果了
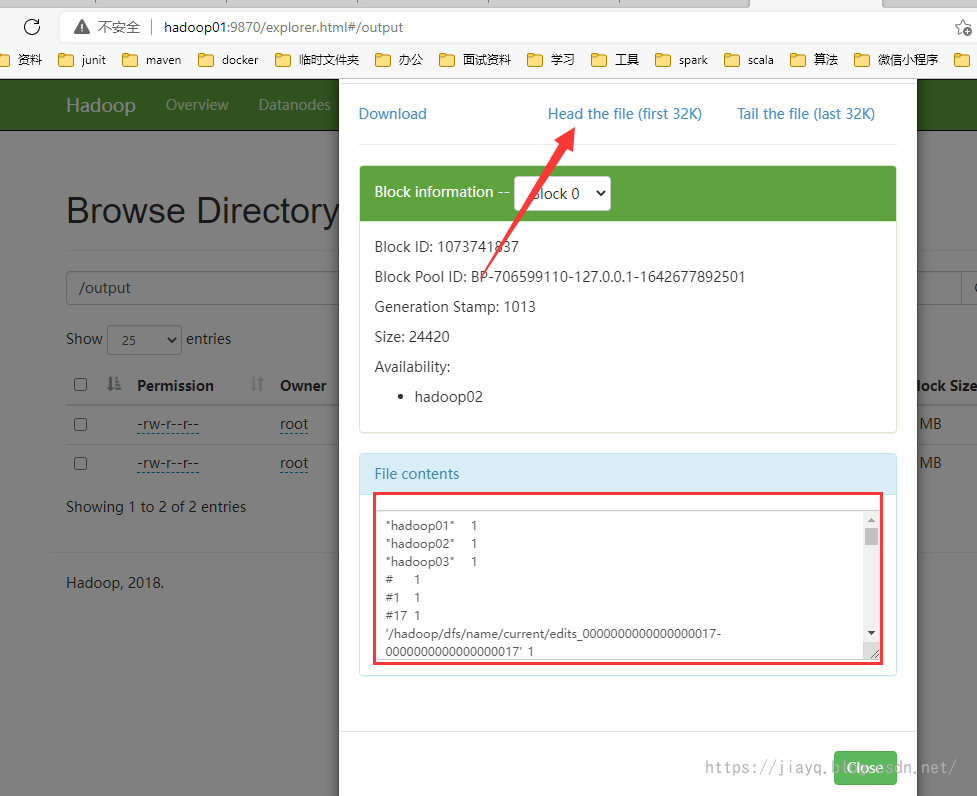
还记得吗,我们的test.log是在hadoop03节点上的
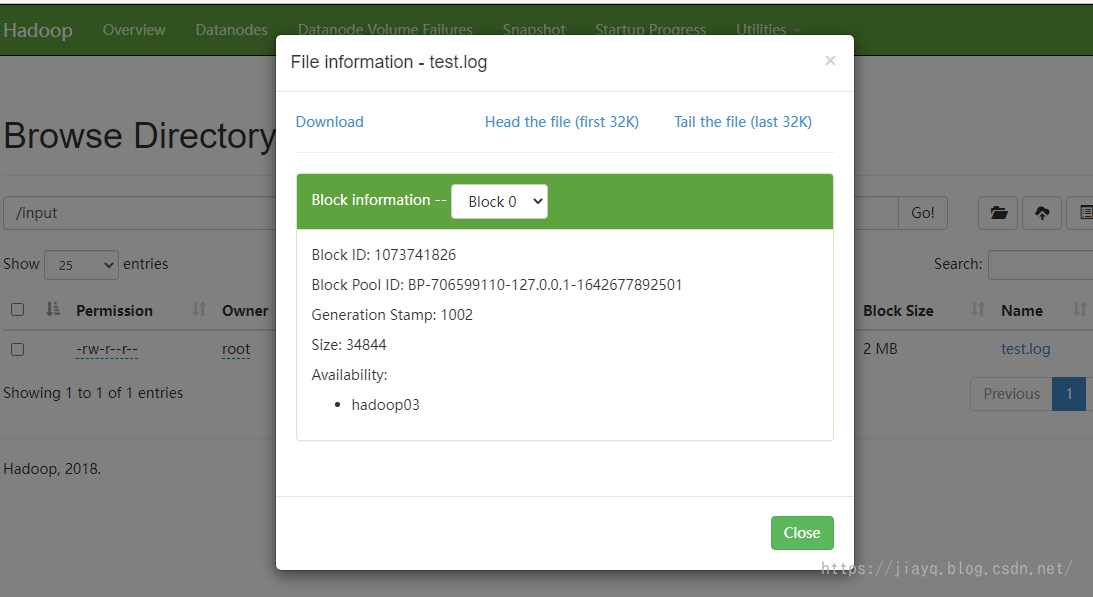
总结
到了这里,hadoop的集群搭建就完成了。
说实话,整个配置过程并不顺利,遇到了很多问题。
第一个是配置后,namenode或者resouceManager没有启动,导致无法在web上查看界面,这个需要首先在虚拟机上进行访问web,界面,使用crul验证是否可以访问,其次则是在访问的机器上使用ping命令测试连通性,最重要的是出现了问题一定先查看日志,不要随便猜想。
第二个是配置后,nameNode直接死掉了,导致hadoop01上没有nameNode,或者是没有resourceManager,这个和配置有关,查看日志发现,我们配置的不允许启动nameNode中有hadoop01,这个是查看日志发现的。
第三个是启动成功后,dataNode无法注册到nameNode上,这个和集群节点之间的映射有关,必须保证一个域名一个地址,不能重复,否则时好时坏的,还有就是必须在配置文件中准确的指定nameNode 的地址和端口。
第四个是启动成功后,在界面上查看信息,发现hdfs的lived节点一直是0个或者一个,这个时候需要查看日志,查看日志后发现,nameNode启动需要一定的时间,等待nameNode完全启动后,才会接受dataNode的注册请求。在此期间,dataNode会一直重试注册请求,日志也会一直刷无法注册的信息,需要稍微等待一点时间,才能注册成功。
第五个是一定要保证全部节点的配置信息一致,如果不一致,可能某些节点配置的nameNode或者resourceManager已经不可用,导致节点无法加入集群。
虽然问题很多,但是另一方面,加深了我对hdfs,yarn的理解。查看日志可以清晰的看到启动过程,以及配置的使用。
问题虽多,但是只要不放弃,一定能成功。