Python好坑爹的一个点--print()
一位初学者在使用Python的requests库抓取网页时遇到问题,发现获取的HTML内容缺失了重要标签,寻求解决办法。
Python好坑爹的一个点--print()
文章信息
- 原文链接:https://jiayq.blog.csdn.net/article/details/89643830
- 发布时间:2019-04-28 18:54:12
- 阅读量:488
- 分类:Python专栏收录该内容, 订阅专栏
- 标签:#Pytnon好坑
摘要
文章浏览阅读488次。一位初学者在使用Python的requests库抓取网页时遇到问题,发现获取的HTML内容缺失了重要标签,寻求解决办法。
首先说明一下情况:
我使用requests库的request方法获取一个网页,然后把获取到的html打印输出。
代码如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
import requests

def getHtml(url):
    header = {
        'Accept': "*/*",
        'accept-encoding': "gzip, deflate",
        'Connection': "keep-alive",
        'Accept-Language' : 'zh-CN,zh;q=0.9',
        'User-Agent' : 'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.103 Safari/537.36'
    }
    response = requests.request('GET', url = url, headers = header)
    response.encoding = 'utf-8'
    return response.text

print(getHtml('http://www.xbiquge.la/13/13959/5939025.html'))
输出如下:
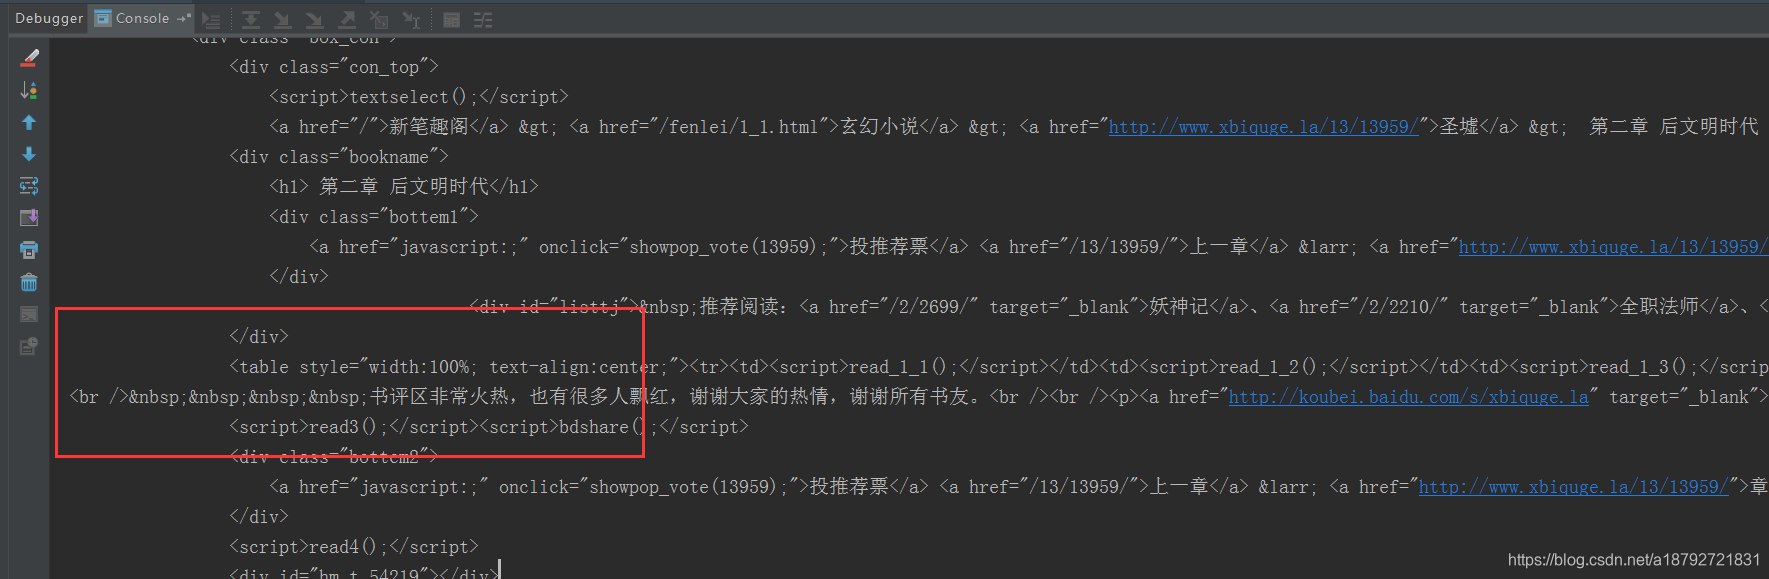
调试如下:
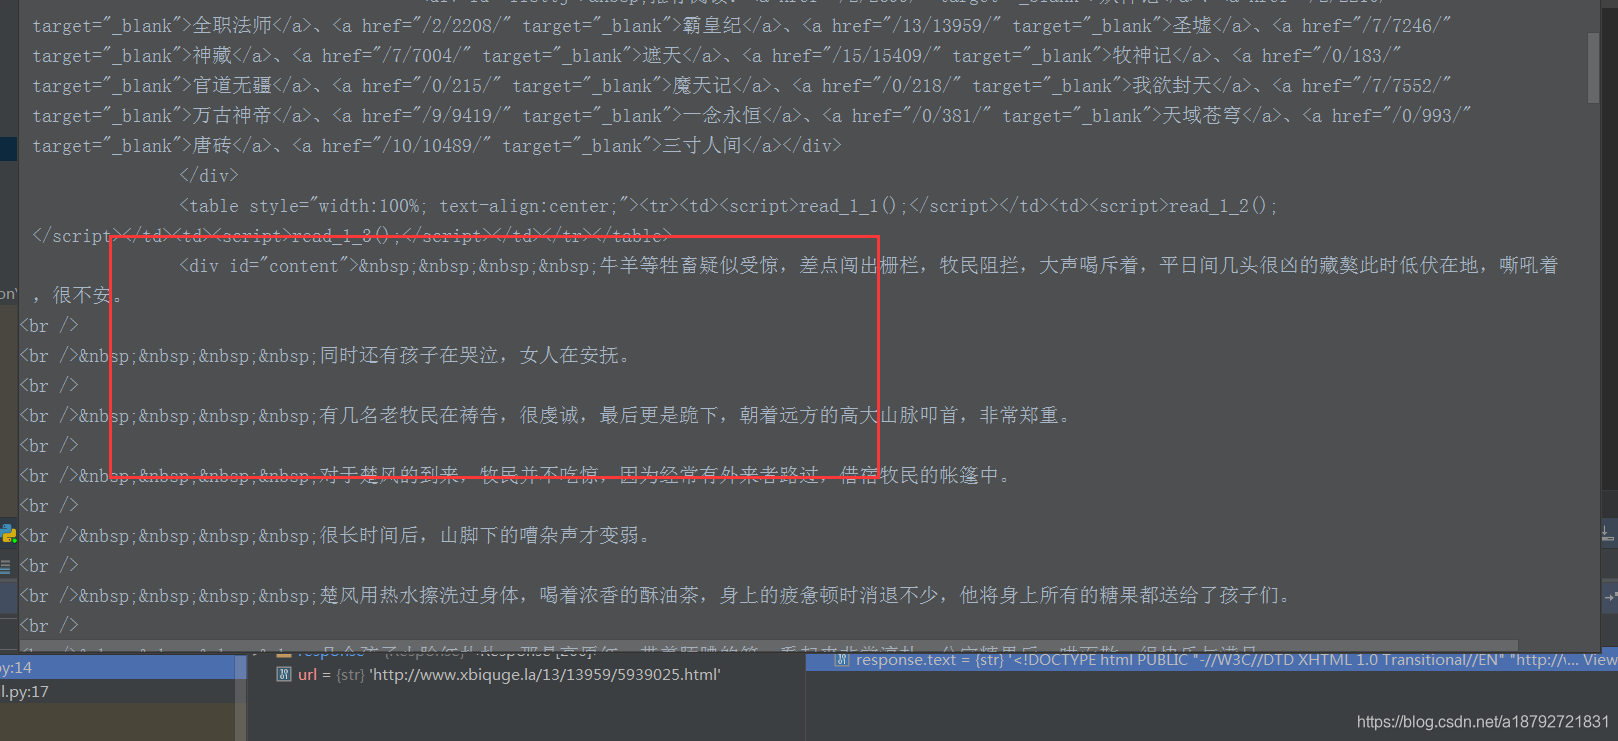
这个print方法把我一个网页中最重要的标签给丢了。
我不知道是什么原因。
python库
不清楚为什么,初学Python,求大神路过解惑。
坑死了,坑死了,坑死了。。。。。。。。。
本文由作者按照 CC BY 4.0 进行授权