MySQL 索引类型
本文介绍了MySQL中的几种主要索引类型及其特点。聚集索引以B+树形式存储全部数据,通过主键聚集数据;辅助索引(二级索引)只存储索引字段和主键,查询时可能需要回表;唯一索引确保字段值唯一性;联合索引由多个字段组成,可优化多条件查询。文章通过具体SQL示例演示了各类索引的创建、使用和执行计划分析,重点说明了联合索引的最左前缀原则以及索引覆盖对查询性能的影响。合理使用这些索引可以有效提升数据库查询效率。
文章信息
- 原文链接:https://jiayq.blog.csdn.net/article/details/150275404
- 发布时间:2025-08-12 16:46:44
- 阅读量:721
- 分类:mysql专栏收录该内容, 订阅专栏
- 标签:#mysql, #数据库, #索引, #索引类型, #B+树
摘要
文章浏览阅读721次,点赞27次,收藏12次。本文介绍了MySQL中的几种主要索引类型及其特点。聚集索引以B+树形式存储全部数据,通过主键聚集数据;辅助索引(二级索引)只存储索引字段和主键,查询时可能需要回表;唯一索引确保字段值唯一性;联合索引由多个字段组成,可优化多条件查询。文章通过具体SQL示例演示了各类索引的创建、使用和执行计划分析,重点说明了联合索引的最左前缀原则以及索引覆盖对查询性能的影响。合理使用这些索引可以有效提升数据库查询效率。
MySQL 索引类型
- 聚集索引
- 辅助索引
- 唯一索引
- 联合索引
聚集索引
在Inno DB 中,表中的数据是以B+树的形式存储的,这种存储了所有数据的B+树一般称为聚集索引。Inno DB 通过主键聚集数据,如果没有定义主键,那么 Inno DB 会选择第一个非空的唯一索引代替,如果没有非空的唯一索引,那么Inno DB 会隐式定义一个 ROW ID 代替。
聚集索引占用的空间最大,因为保存了全部的数据。
创建一张表
1
2
3
4
5
create table `t1` (
`id` int not null auto_increment primary key,
`idx` int not null,
`name` varchar(20)
) engine = innodb default charset=utf8mb4;
插入一些数据:
1
insert into `t1`(`idx`,`name`) values (1,'a'),(2,'b'),(3,'c'),(5,'e'),(6,'f'),(7,'g'),(9,'i');
查询
1
select * from `t1`;
| id | idx | name |
|---|---|---|
| 1 | 1 | a |
| 2 | 2 | b |
| 3 | 3 | c |
| 4 | 5 | e |
| 5 | 6 | f |
| 6 | 7 | g |
| 7 | 9 | i |
聚集索引:
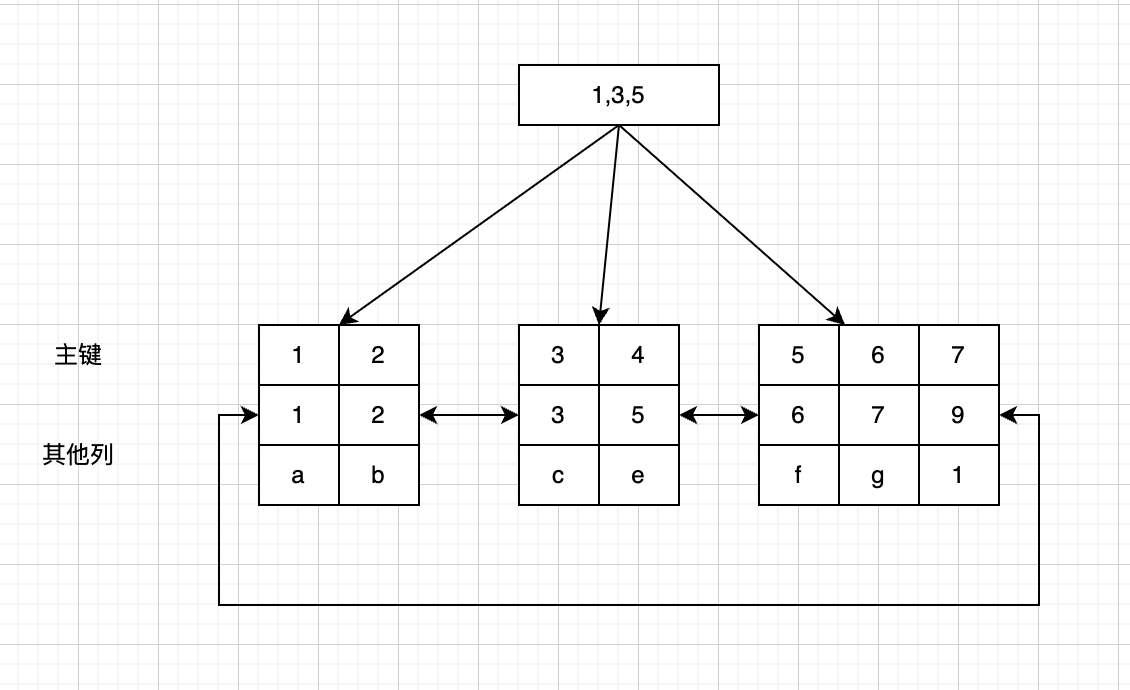
叶子节点上存储的是整行数据,并且叶子节点之间用双向链表关联。
辅助索引
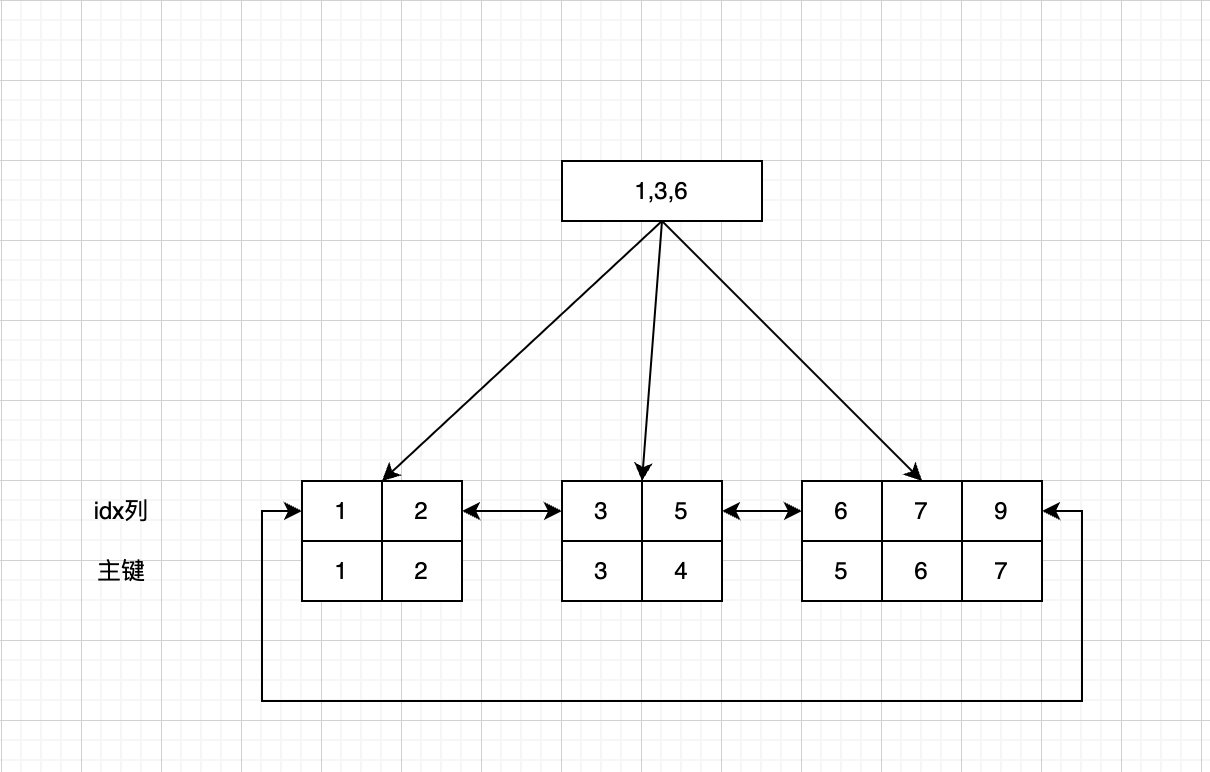
辅助索引,也称为二级索引,单张表可以有多个。聚集索引的叶子节点存储的是整行数据。但是 Inno DB辅助索引的叶子节点只存放对应索引字段的键值和主键ID。
有时需要统计表的总行数,此时优化器可能会选择辅助索引作为统计目标索引,因为占用空间最小,加载也快。
在使用二级索引的时候,因为只存储了索引字段的值和主键,所以如果需要查询其他列的数据,就需要先通过二级索引中的值找到对应的主键,在通过主键找到聚簇索引中其他列的数据。–这个过程称为回表。
为了减少回表次数,可以将语句中经常使用到的所有列以合适的顺序建立一个二级联合索引。这样所有需要的列都被这个二级索引覆盖,就不需要回表。
当通过辅助索引来检索数据时,Inno DB 先遍历辅助索引树查找对应记录的主键,然后通过主键索引找到对应的行数据。
通常采用以下几种方式创建索引
1
2
3
4
5
6
create table `t1` (
`id` int not null auto_increment primary key,
`idx` int not null,
`name` varchar(20),
key `idx_idx` (`idx`)
) engine = innodb default charset=utf8mb4;
在创建表的时候就创建
1
create index `idx_b` on `t1`(`idx`);
通过create index创建
查看索引
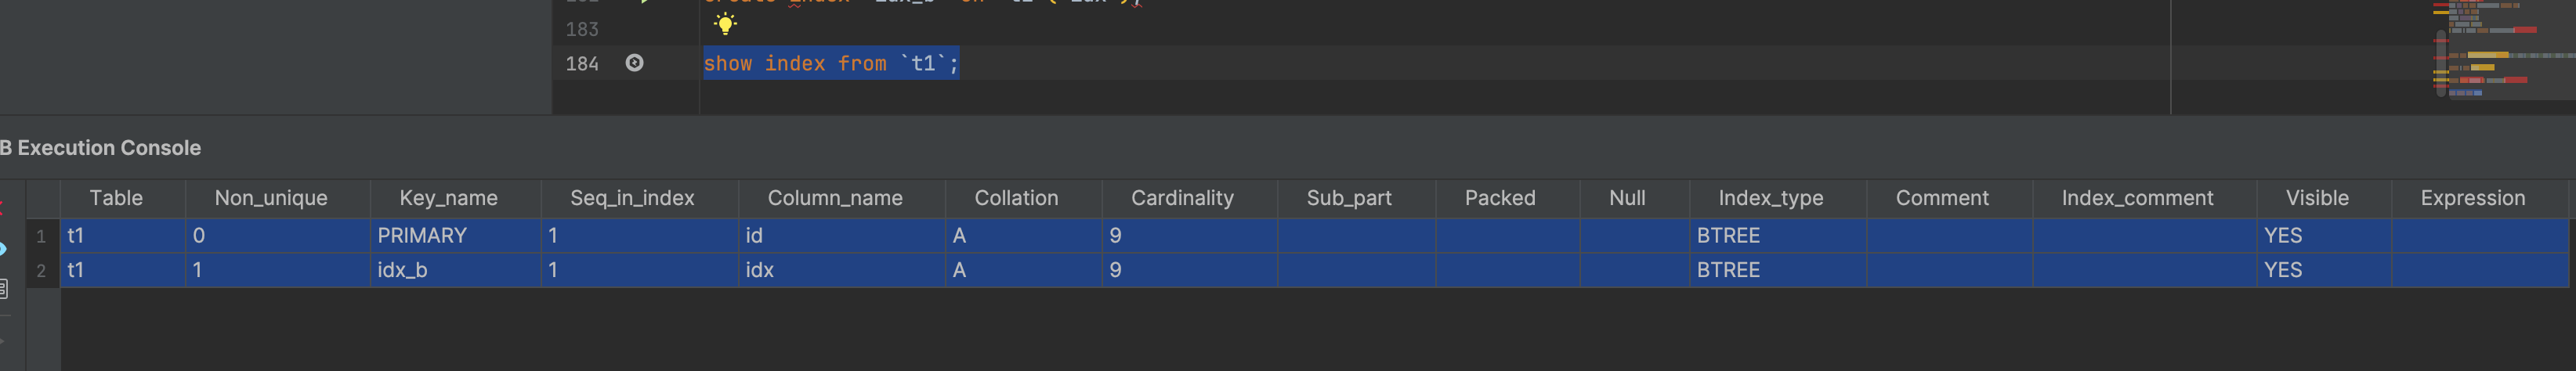
1
show index from `t1`;
删除索引
1
drop index `idx_b` on `t1`;
使用 alter table 创建索引
1
alter table `t1` add index `idx_name`(`name`);
删除
1
alter table `t1` drop index `idx_name`;
唯一索引
唯一索引是一个不包含重复值的二级索引(可以理解为:唯一索引由唯一约束和二级索引两部分组成)。为某个字段添加唯一索引之后,那么写入该字段的值必须是不同的,否则会提示错误。
使用
1
alter table `t1` add unique `t1_uniq_name`(`name`(2));
给name字段的前两个字符增加唯一性索引
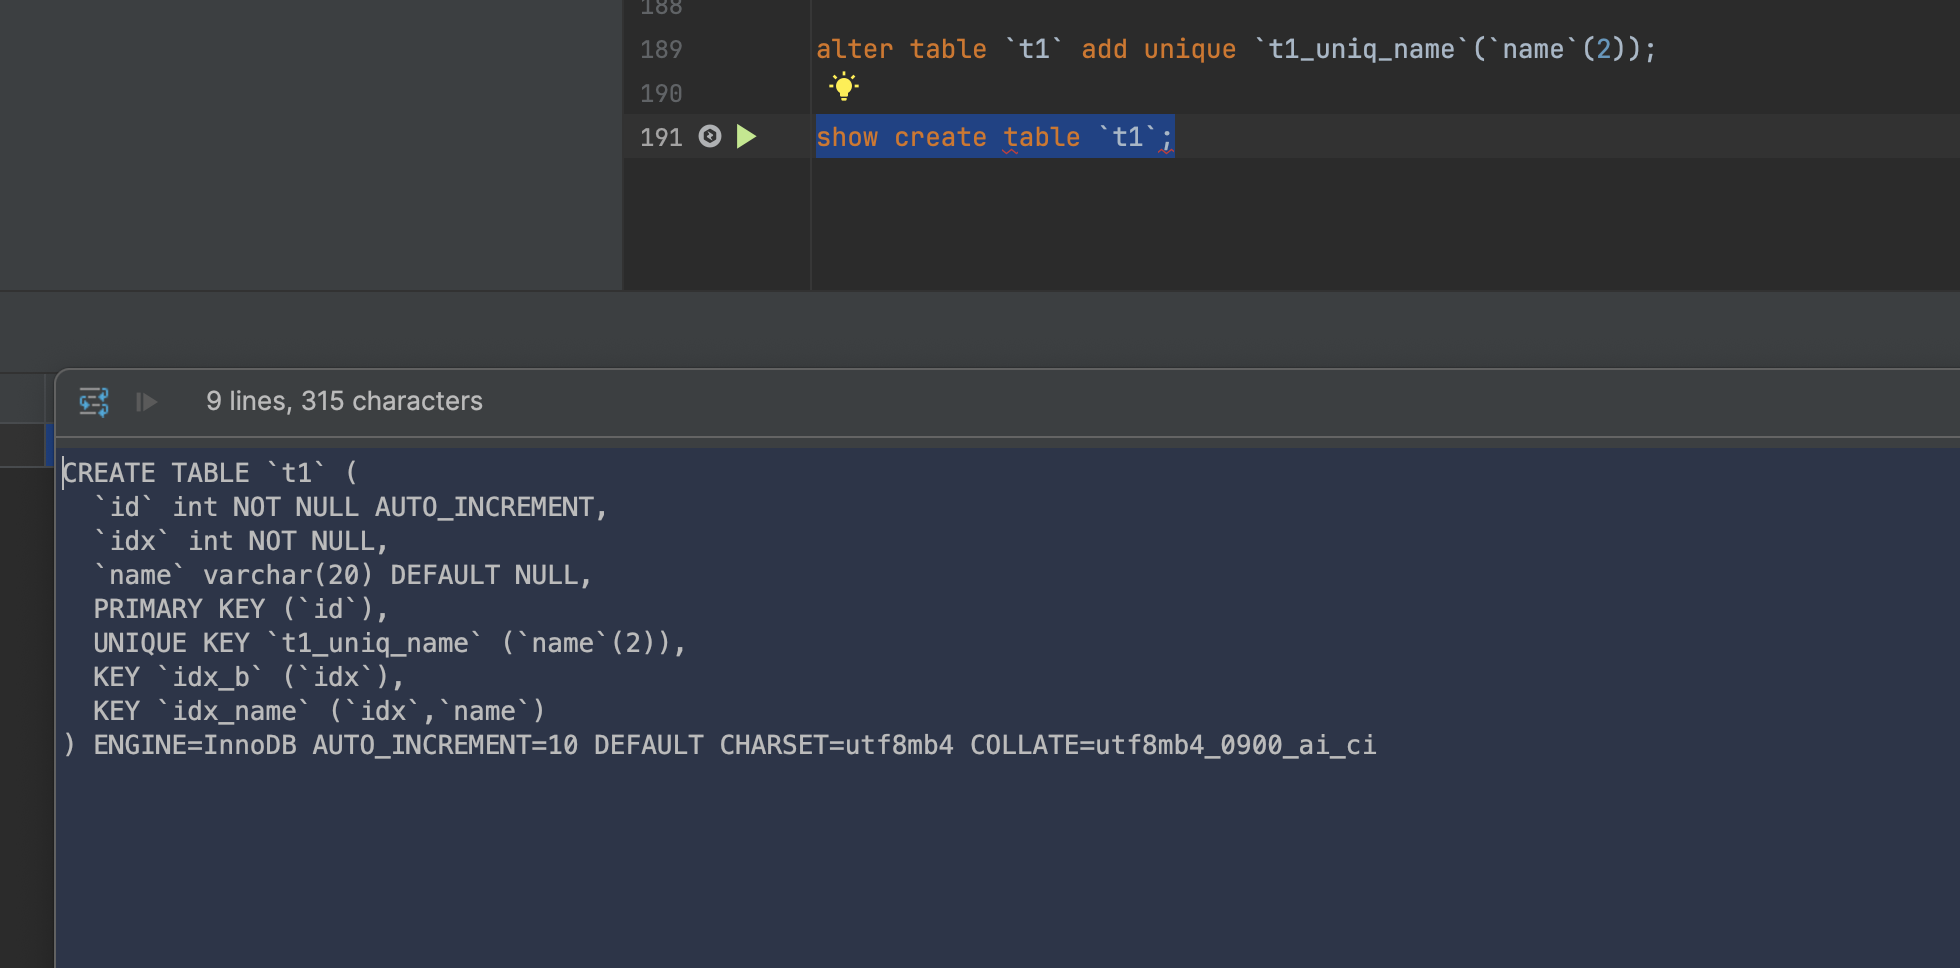
使用
1
show create table `t1`;
查看索引
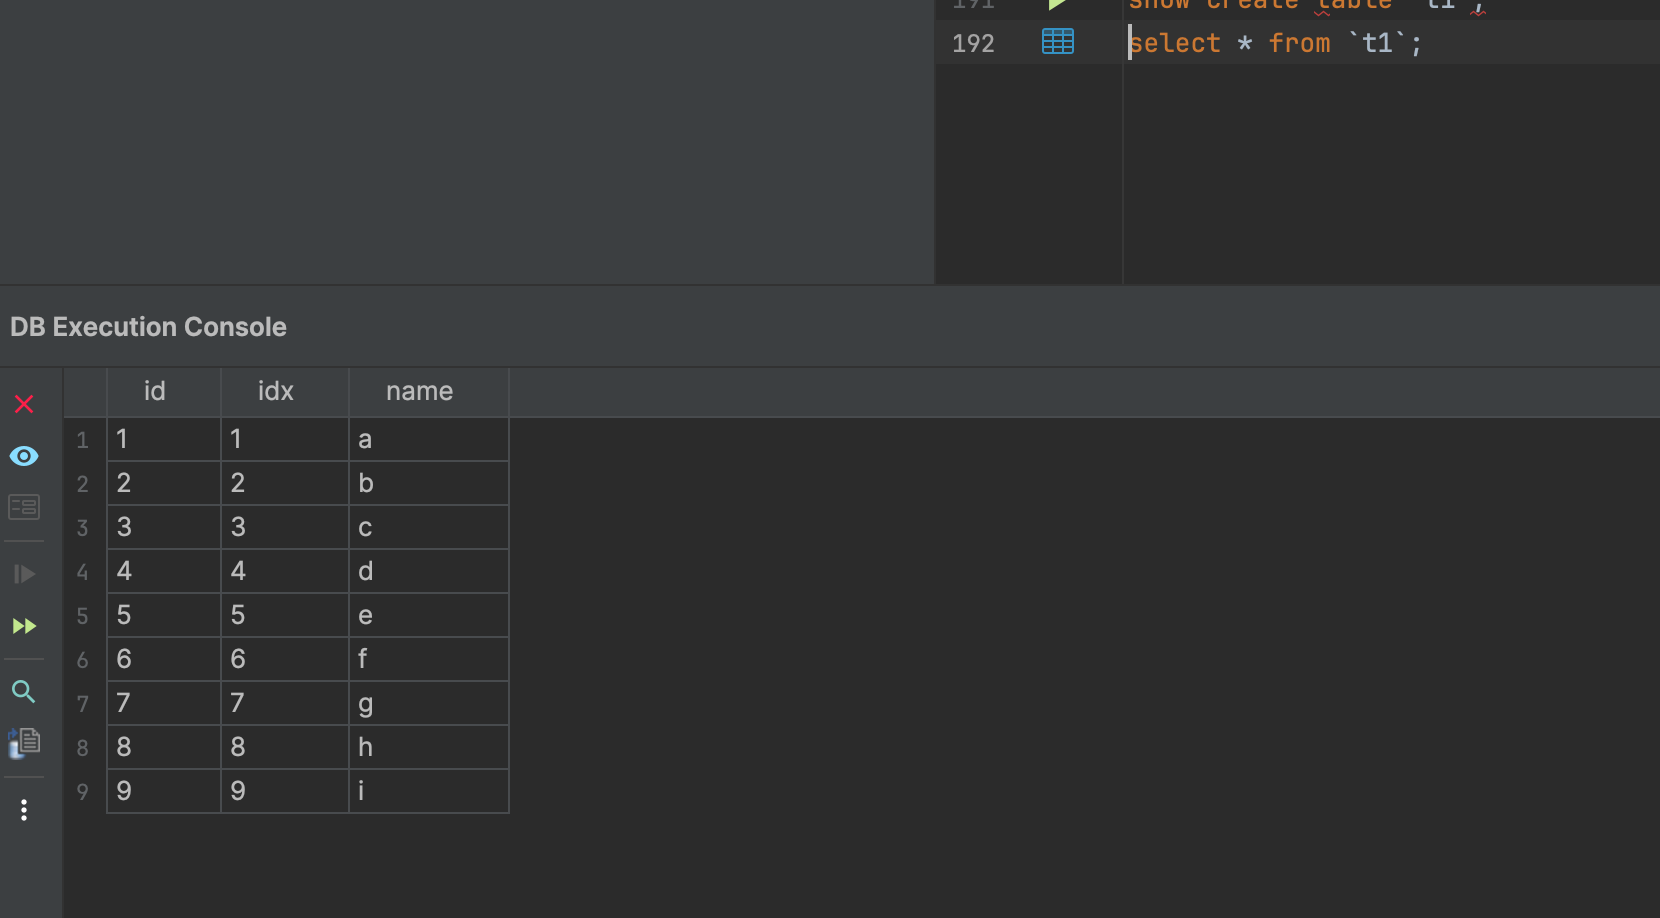
查看数据
增加数据
1
2
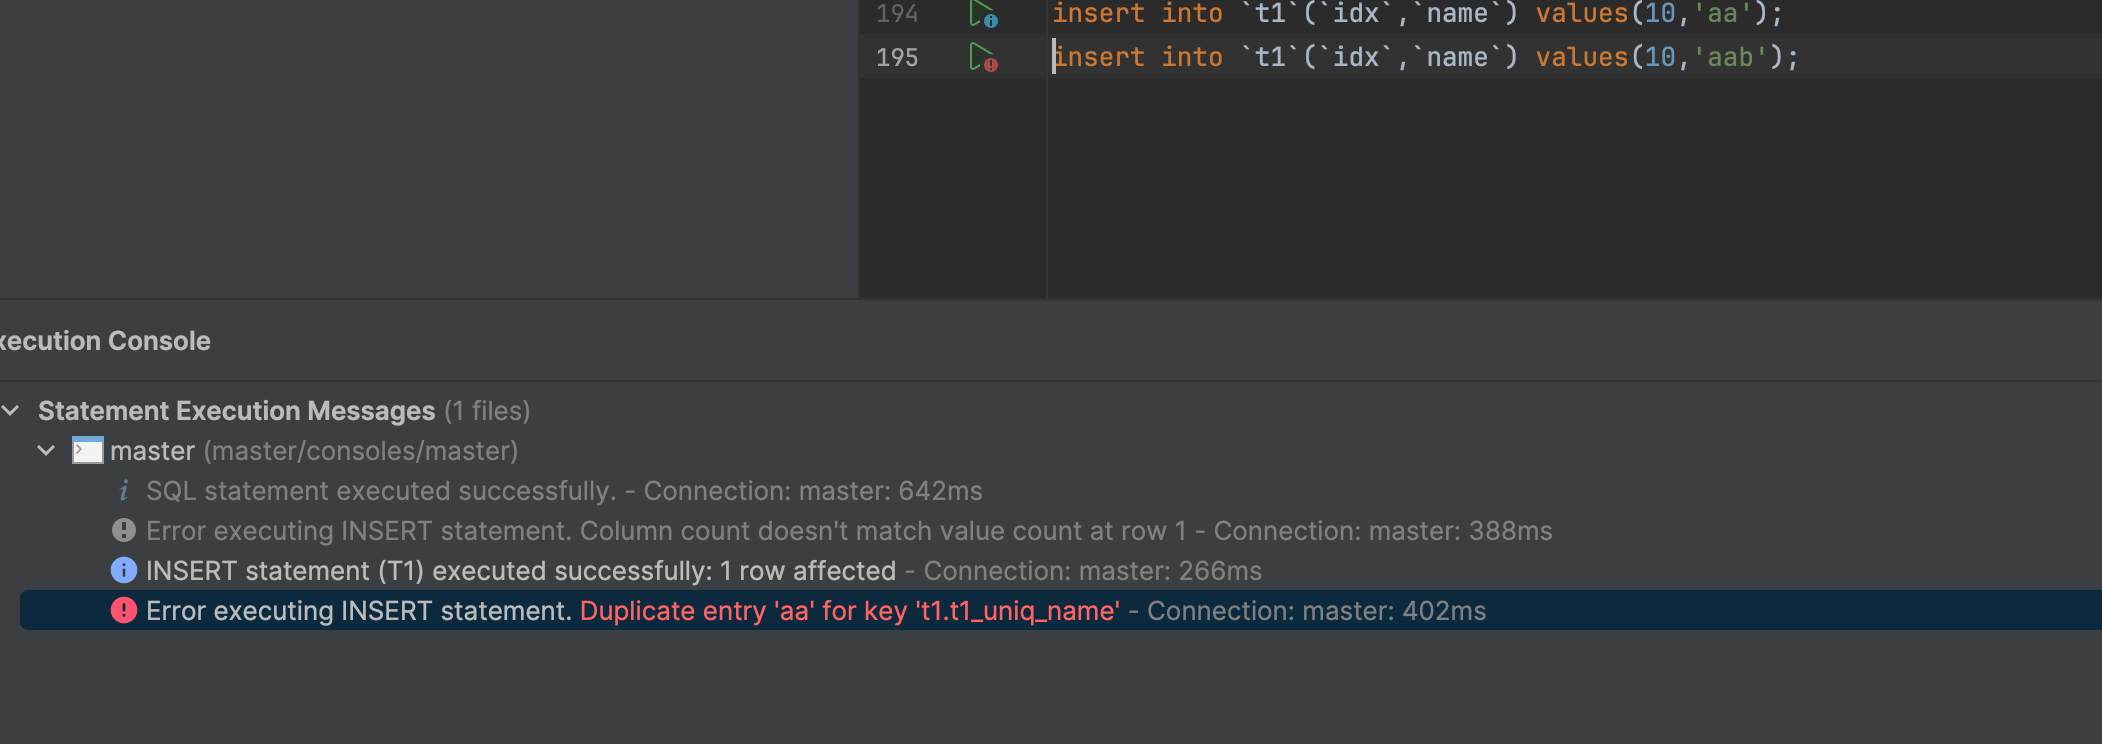
insert into `t1`(`idx`,`name`) values(10,'aa');
insert into `t1`(`idx`,`name`) values(10,'aab');
因为已经有了aa,在增加 aab的时候报错
1
Error executing INSERT statement. Duplicate entry 'aa' for key 't1.t1_uniq_name' - Connection: master: 402ms
联合索引
有时普通索引已经无法满足需求,如单个字段唯一性很低,需要联合多个字段才能达到最优效果,这种由多个字段组成的二级索引称为联合索引。
联合索引适用于where 条件中的多列组合,并且在某些场景中可以避免回表。
使用
1
create index `idx_name` on `t1`(`idx`,`name`);
创建 idx和name的联合索引。
idx和name的联合索引
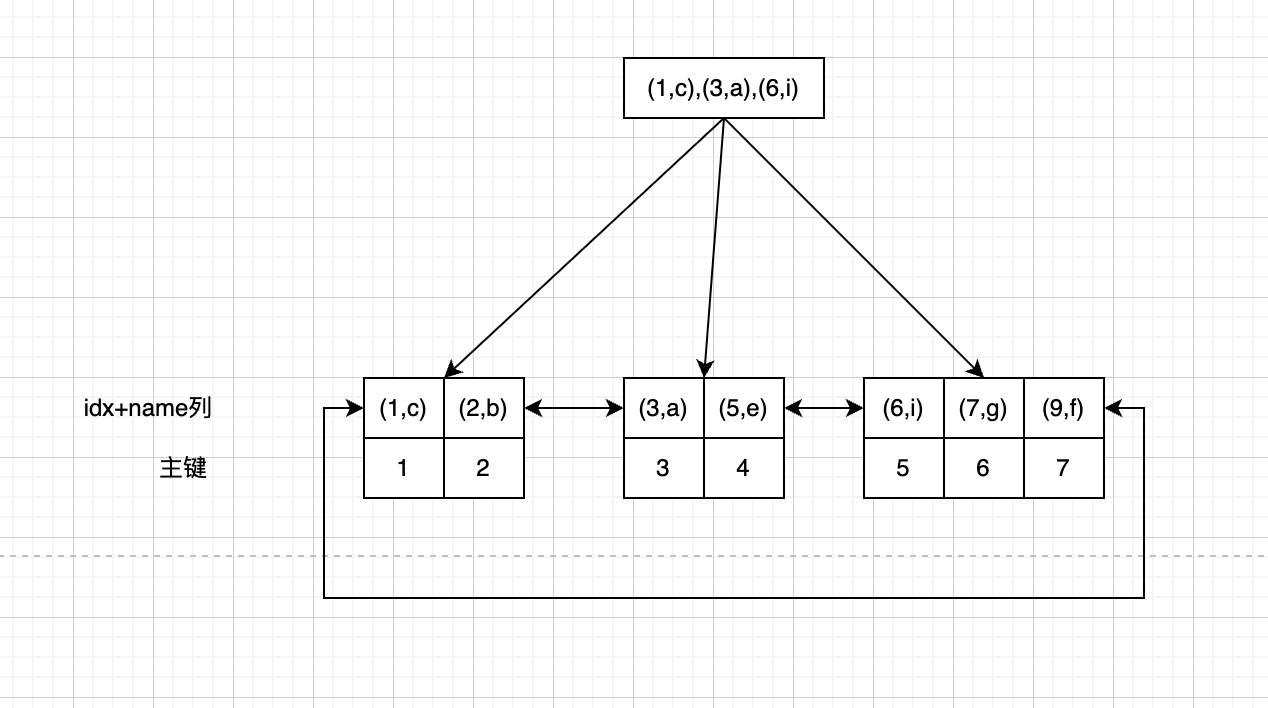
联合索引与单个键值的B+树差不多,联合索引也是按照键值排序的。
需要注意的是,当idx和name都作为条件时,查询是可以使用索引的;单独对idx字段进行查询也是可以使用索引的。但是单独对name字段进行查询就无法使用索引。
因为name字段对应的值c,b,a,e,i,g,f是无序的,所以无法使用索引。
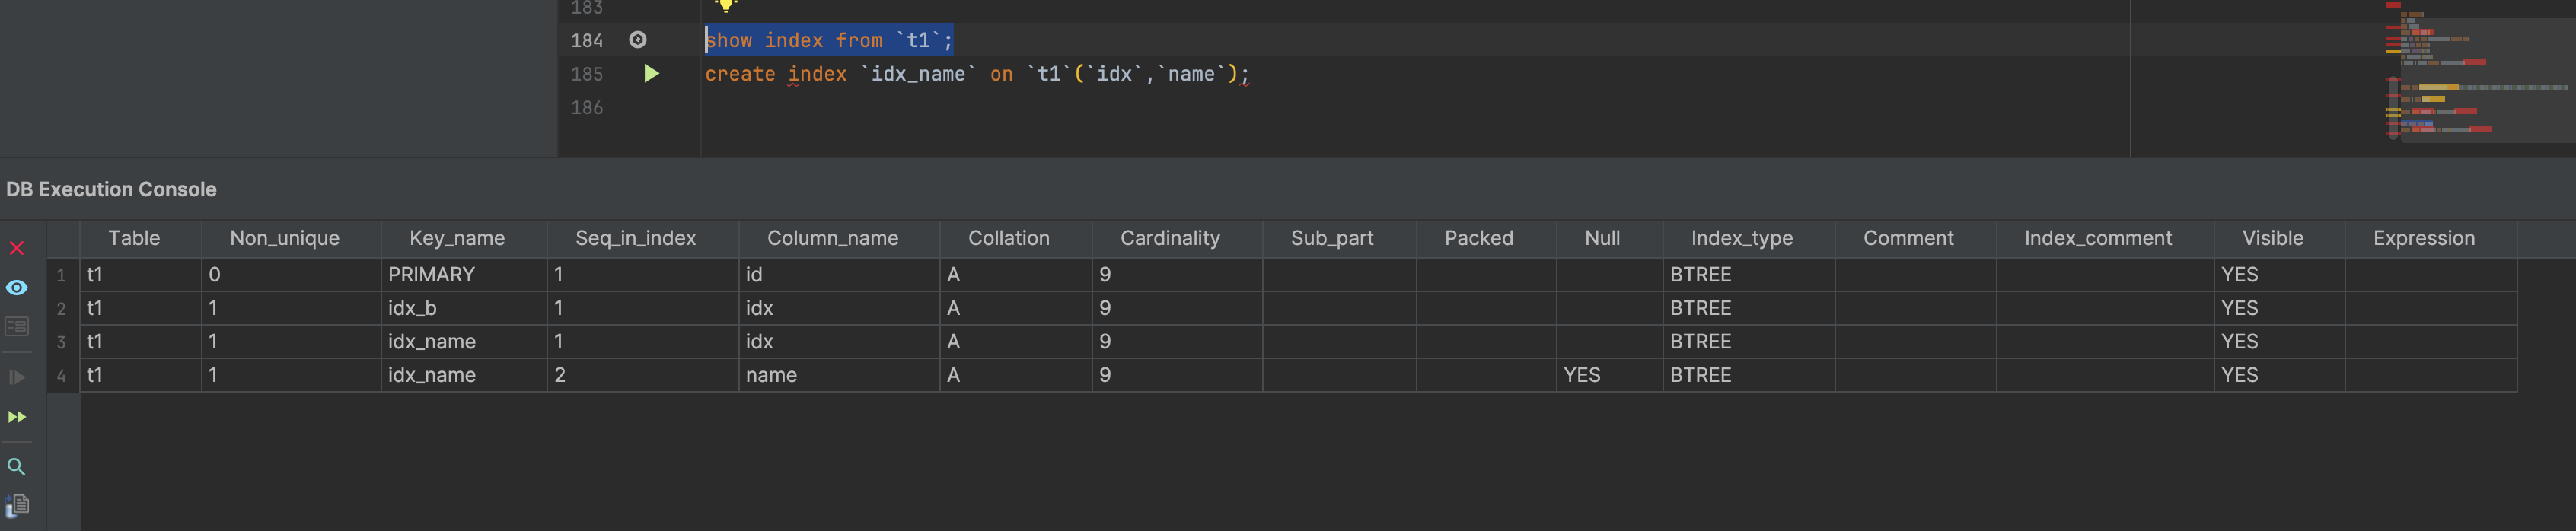
可以看到 idx_name有两个列
查看执行计划
1
explain select `name` from `t1` where `idx`=1 or `name`='c';
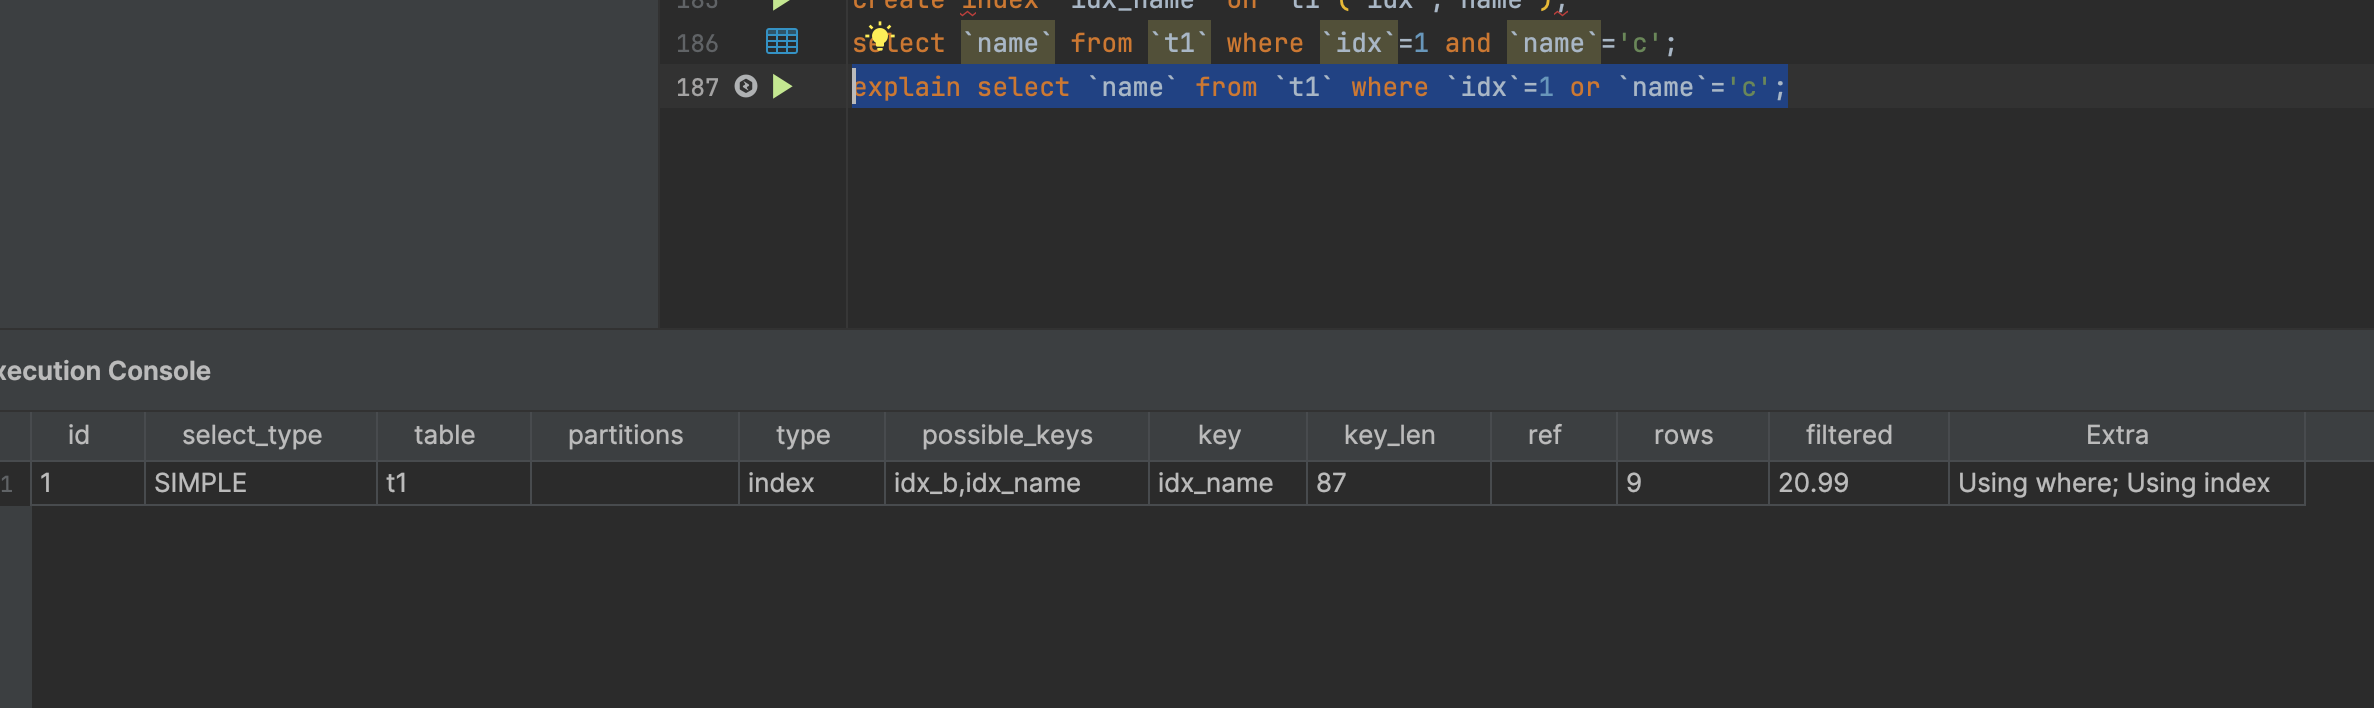
key列的值为 idx_name 表示使用了联合索引。key_len 列的值为87
len(idx)=4,len(name)=20*4,加上因为name允许为空,所以需要在加1.总计87
4 (int) + [2 (varchar长度前缀) + 20*4 (utf8mb4每个字符4字节) + 1 (可为NULL标记)] = 4 + (2+80+1) = 87
使用or是无法使用联合索引的,所以在index之外还要再次判断where 条件。
比如查询
1
explain select `name` from `t1` where `idx`=3 and `name`='c';
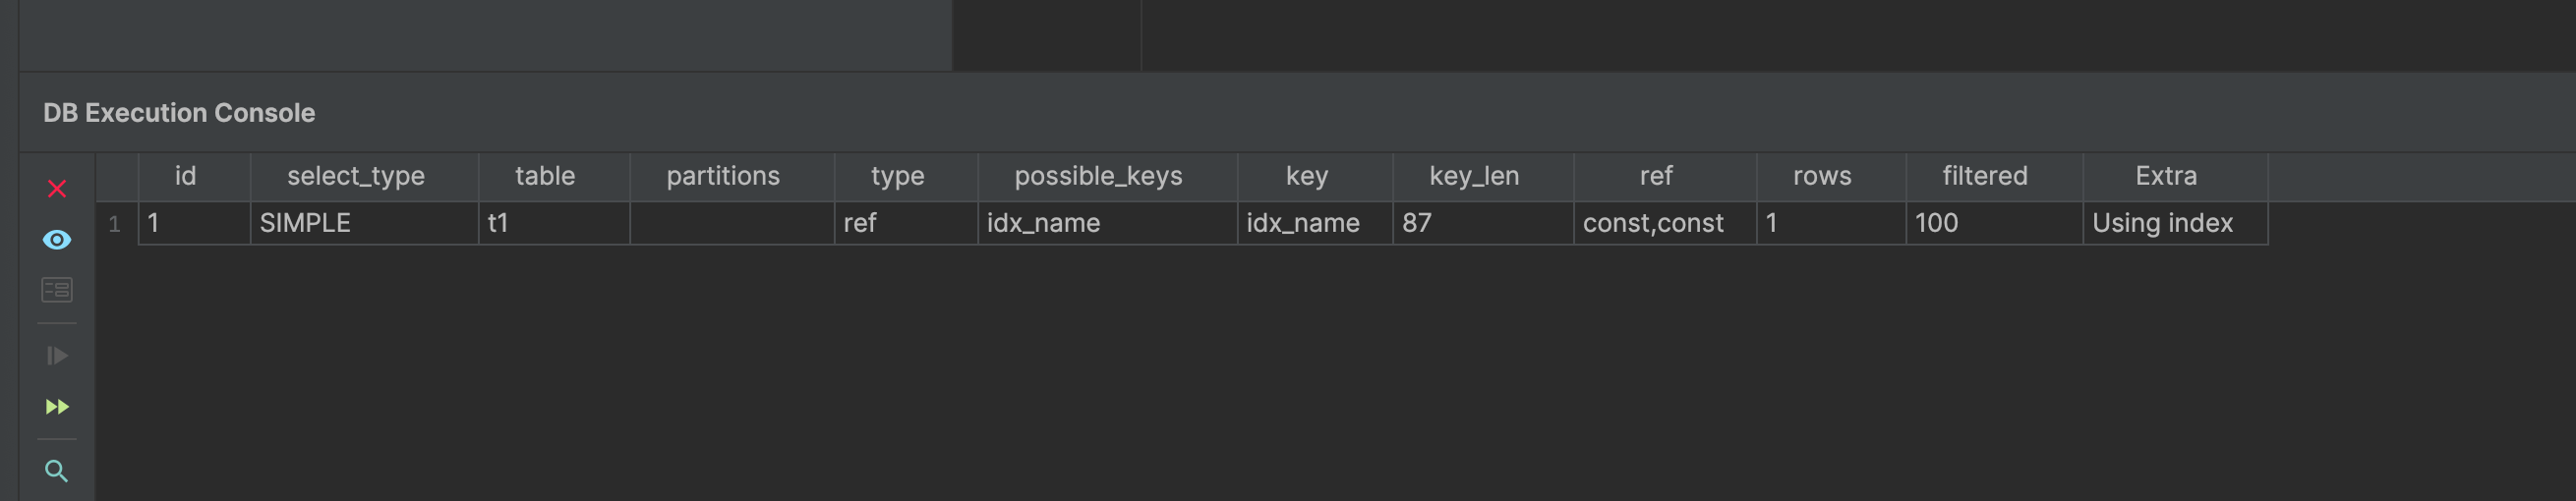
直接使用index就能完成数据过滤。
只有idx作为条件时,也能使用联合索引
1
explain select `name` from `t1` where `idx`=3
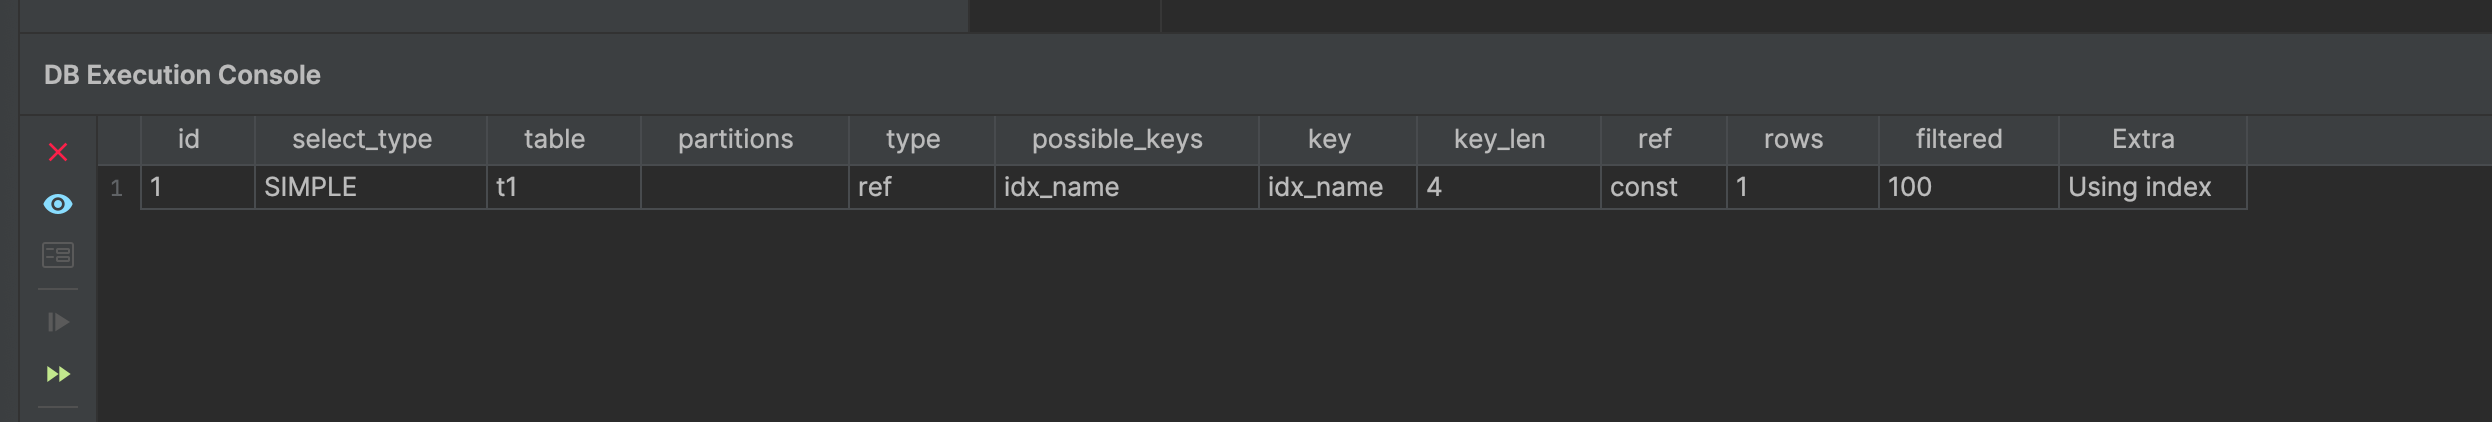
key列的值为idx_name,表示使用了索引idx_name。key_len列的值为4,因为 idx字段是不允许为空的int类型,所以key_len是4.
只有name作为条件时,不能使用联合索引
1
explain select `name` from `t1` where `name`='c';
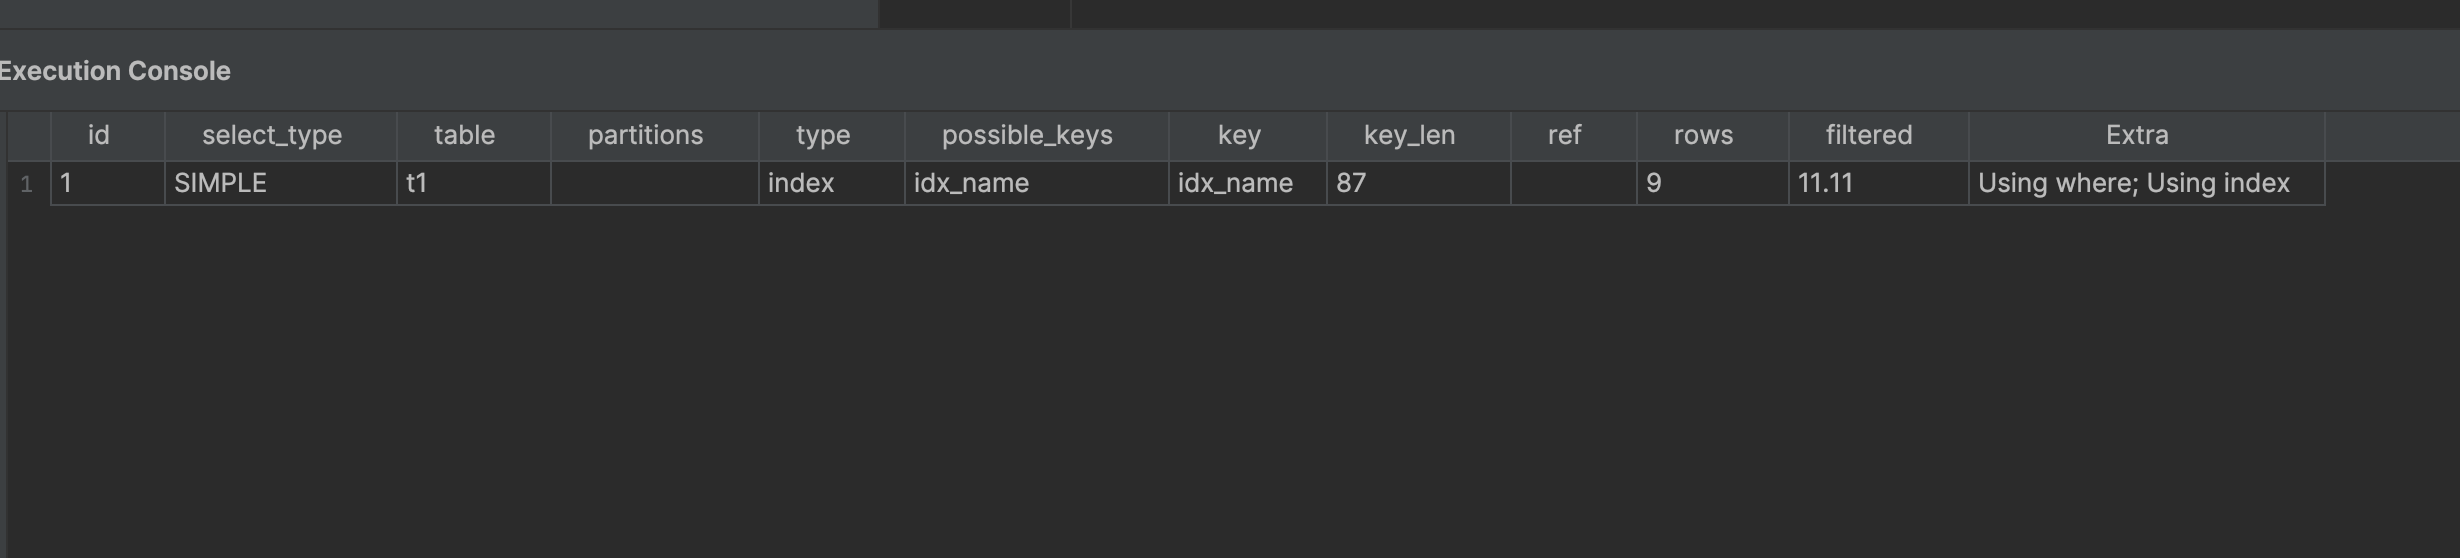
在上面的例子中,Extra字段的值有的是Using index,并且rows等于1,并且filtered=100,而且查询的字段正好是索引的字段,因此不需要回表就能获取到信息。可以减少SQL语句执行过程中的IO次数。