【教程】Loop Engineering 落地实战:状态机、Gate 与 Watchdog 全解析
【教程】Loop Engineering 落地实战:状态机、Gate 与 Watchdog 全解析 本文以一套真实运行的"失败任务批量排查系统"(状态机 v3 + watchdog 守护进程)为例,系统拆解 Loop Engineering(循环工程)从概念到工程落地的完整路径:状态机设计、Gate 硬约束与状态门槛的对应关系、Prompt 填空模板、watchdog 调度与执行模型钉住、/goa
文章信息
- 原文链接:https://jiayq.blog.csdn.net/article/details/162544889
- 发布时间:2026-07-23 00:38:25
- 标签:#智能体, #agent, #ai, ##goal, ##loop
【教程】Loop Engineering 落地实战:状态机、Gate 与 Watchdog 全解析
本文以一套真实运行的”失败任务批量排查系统”(状态机 v3 + watchdog 守护进程)为例,系统拆解 Loop Engineering(循环工程)从概念到工程落地的完整路径:状态机设计、Gate 硬约束与状态门槛的对应关系、Prompt 填空模板、watchdog 调度与执行模型钉住、
/goal自驱动模式,并给出一份”如何从零搭建同类系统”的可复用清单,同时用系统实际跑出的运行数据(脱敏后的成果展示)验证前面每一条设计决策,最后复盘搭建过程中踩过的坑与沉淀的亮点。文中涉及的工单系统 / 在线文档系统均为通用指代,不绑定具体厂商产品,方便读者对照自己团队的技术栈迁移使用。全文正文近 9000 字,配 8 张架构/流程/数据图,适合正在设计 Agent 自主运行系统的工程师参考。
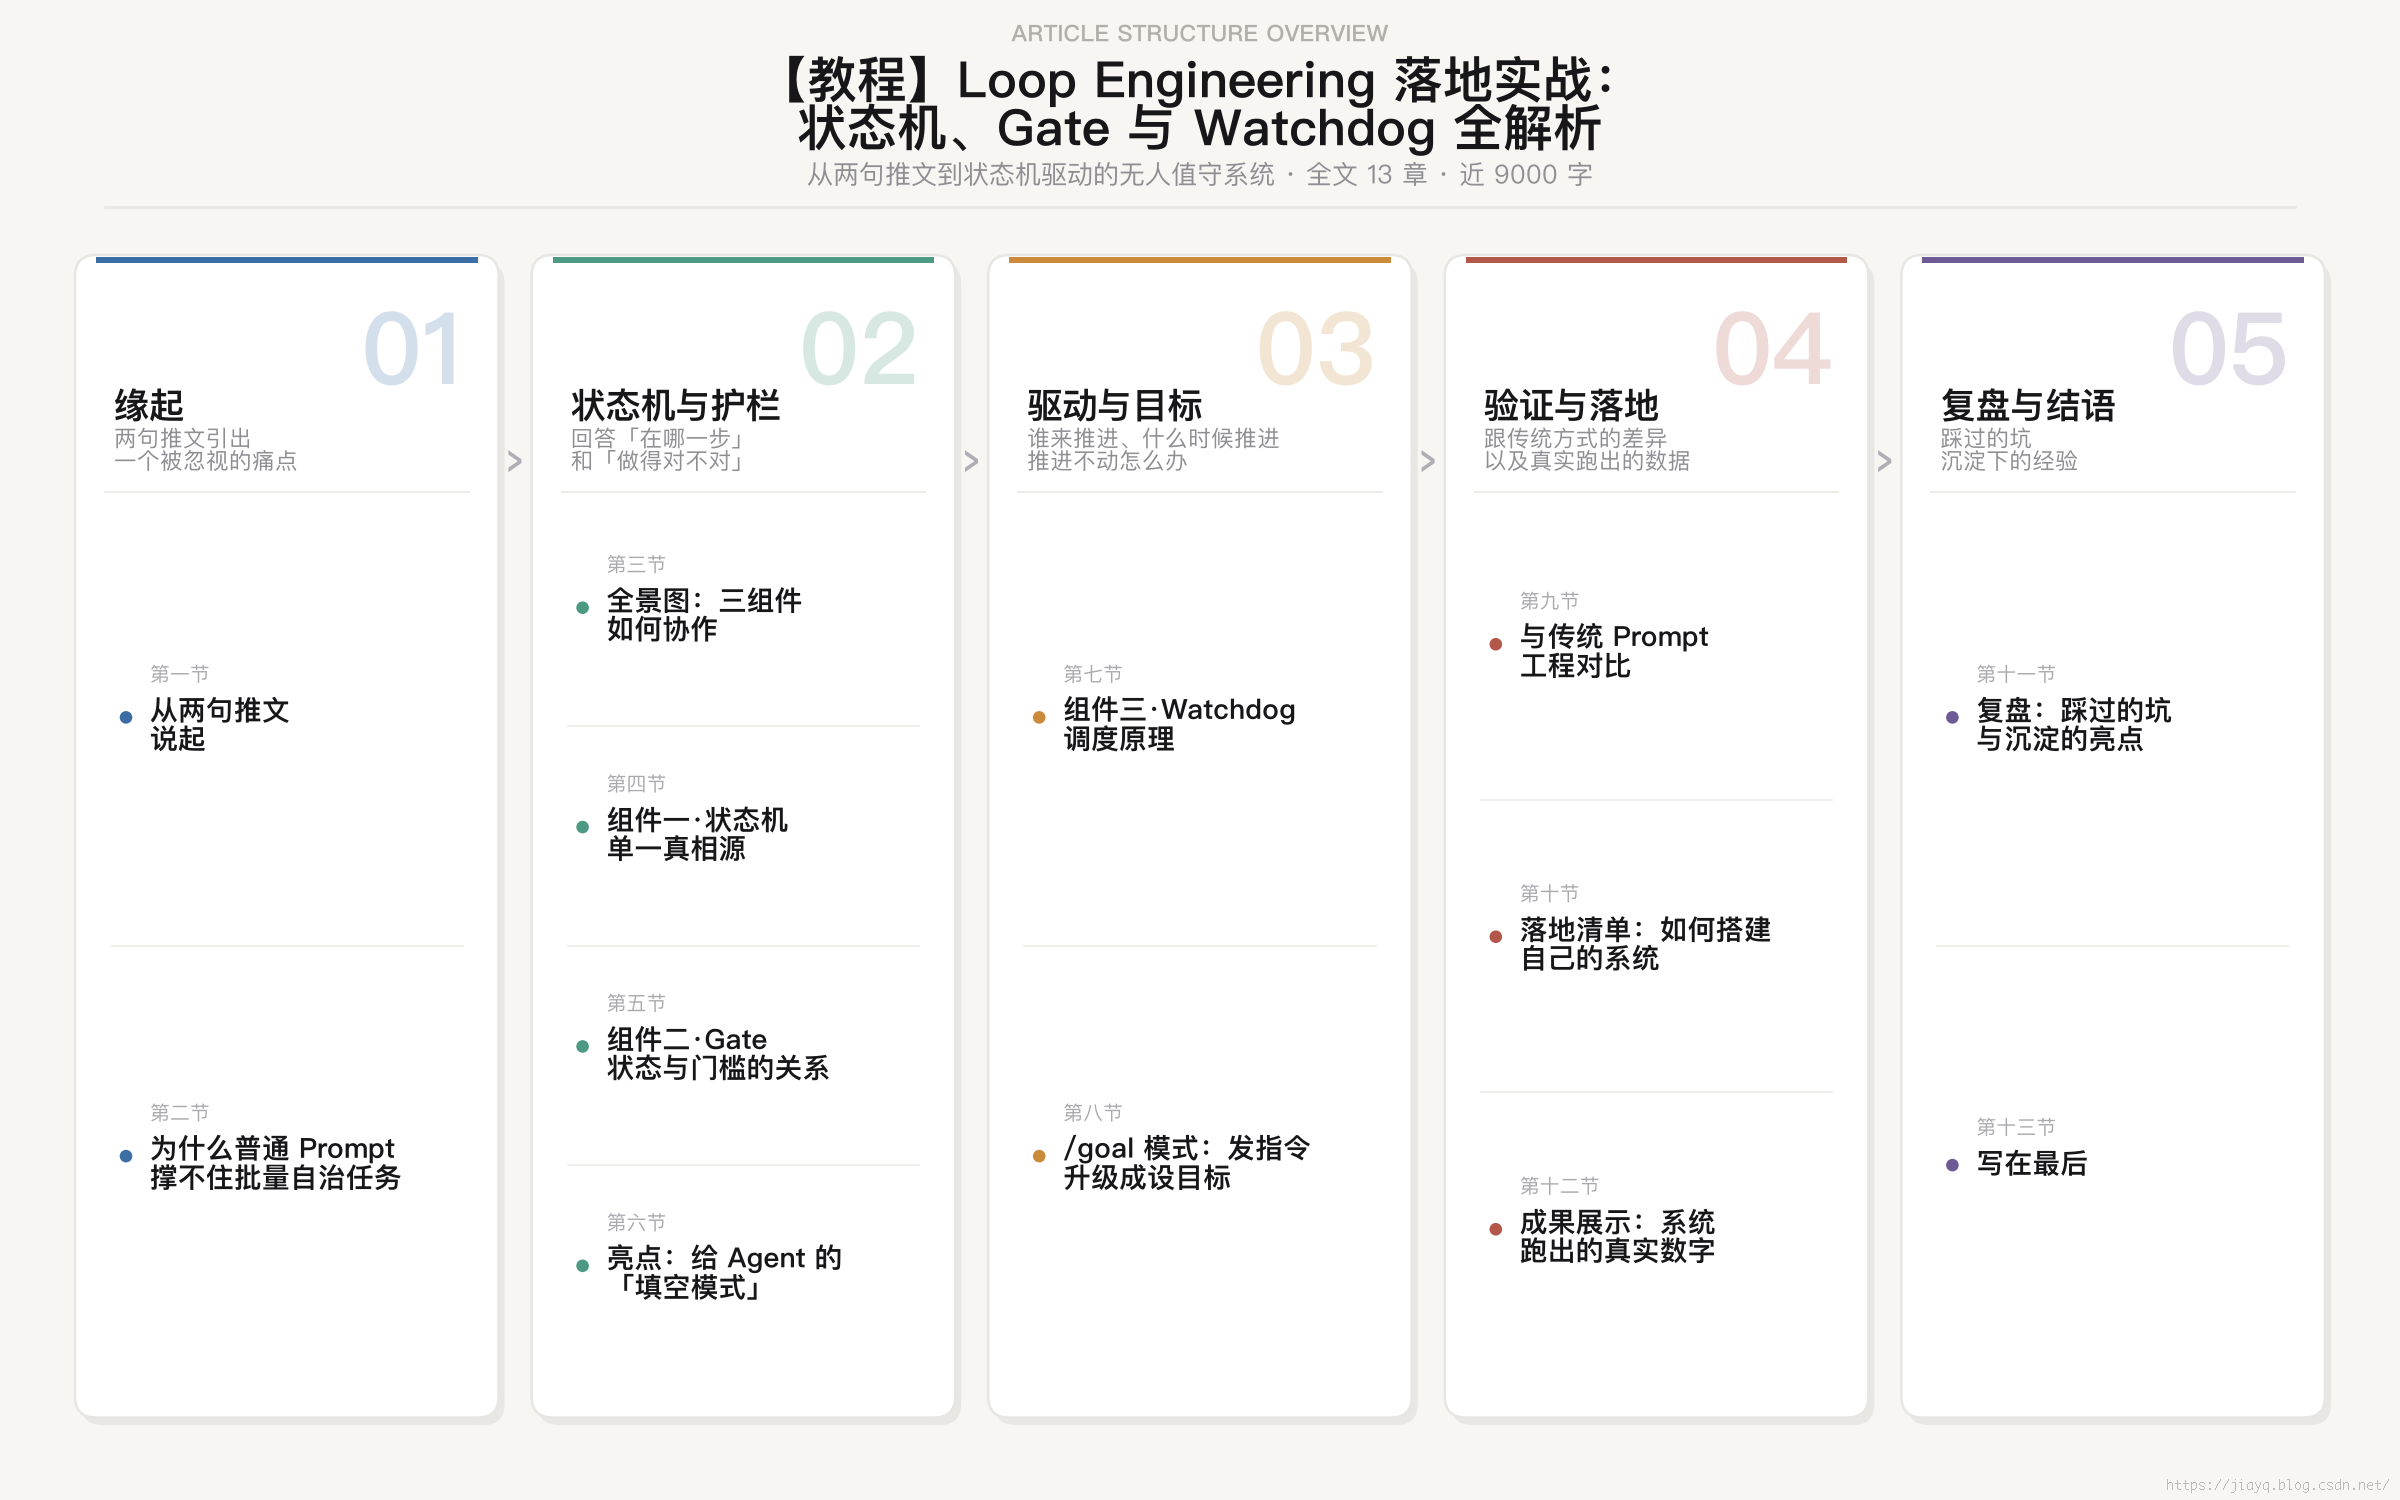
一、从两句推文说起
2026 年 6 月,AI 编程圈被两句话点燃。
Anthropic 的 Boris Cherny 说: “I don’t write prompts for Claude anymore, my job is writing loops.”
OpenClaw 创始人 Peter Steinberger 说得更直接: “You should not be prompting coding agents anymore. You should be designing loops that prompt your agents.”
这两条推文加起来收获了千万级曝光,随后 Google 工程主管 Addy Osmani 把这套实践正式命名为 Loop Engineering(循环工程) 。它的核心主张只有一句话:不要再逐句地给 Agent 写提示词,而是设计一个能让 Agent 持续、自主、可靠运行的循环系统。
说实话,我第一次刷到这两条推文时,心里嘀咕的是”又一个换个说法炒热度的新词”。真正让我改变想法,是自己也经手过一套需要 Agent 无人值守跑几百次任务的系统之后才明白,这话说得一点都不虚——单条 Prompt 写得再漂亮,也扛不住第 37 次运行时突然抽风的 Agent。
这个说法听起来像是又一个”新瓶装旧酒”的概念炒作,但如果你真的搭过一个需要 Agent 24 小时无人值守运行的系统,就会发现它精准地命中了一个长期被忽视的痛点:单次 Prompt 调优的收益是线性的,而 Loop 设计的收益是指数级的 ——因为 Loop 决定了 Agent 犯错之后能不能自己爬起来。
本文不打算停留在概念层面,而是用一个已经在生产环境跑了几百条任务的真实系统——一个失败任务批量排查平台 ——来拆解 Loop Engineering 究竟应该怎么落地。文中给出的所有机制(状态机、Gate、Prompt 模板、调度器、/goal)都是领域无关 的通用设计,替换成客服工单批量处理、财报批量审阅、代码批量迁移等任何”需要 Agent 重复执行、无人值守、可审计”的场景,结论都成立。
二、为什么普通 Prompt 撑不住批量自治任务
先说清楚这类系统要解决什么问题:某产线每天会产生上百条需要排查的失败任务,每条都需要:查现网日志、查业务数据库、定位代码根因、生成排查报告,经人工审核后落地到工单系统 (记录问题跟踪单,可以是 Jira / 禅道 / 内部工单系统等)和在线文档系统 (记录排查报告全文,可以是 Confluence / 语雀 / 内部 Wiki 等),并在两者之间建立双向回链。
如果用最朴素的方式做,就是写一个巨大的 Prompt:
1
2
3
4
请帮我排查这条失败任务:先查日志,再查数据库,
再看代码,然后写一份完整的排查报告,包括根因和建议,
最后帮我建好工单和 Wiki 页面。
这种”一把梭”式的 Prompt 在单条任务、有人盯着的场景下能凑合用。但一旦要求批量、无人值守、可审计、可恢复 ,它会在几个地方全部失效:
一把梭式 Prompt
一次性完成全部动作
中间态不可见
出错不知道错在哪一步
无法断点续跑
进程被杀后从头再来
自由生成产物无法校验
字段缺失/格式跑偏
人工介入点混乱
AI 可能代替人工签字
批量 + 无人值守场景下
整体不可控
这正是 Loop Engineering 想解决的问题:把”一次性问答”重新组织成”状态机驱动的循环” ,让每一步都可观测、可重试、可裁决。
三、Loop Engineering 全景图:三个组件如何协作
结合这套系统的实现,我把 Loop Engineering 的落地拆成三个必须同时具备的组件:状态机(State Machine)、护栏(Gate)、驱动器(Driver / Watchdog) 。三者的关系可以概括为一句话:状态机回答”任务在哪一步”,Gate 回答”这一步做得对不对”,驱动器回答”谁来推进、什么时候推进、推进不动怎么办” 。缺一个都撑不起”无人值守”这个目标。
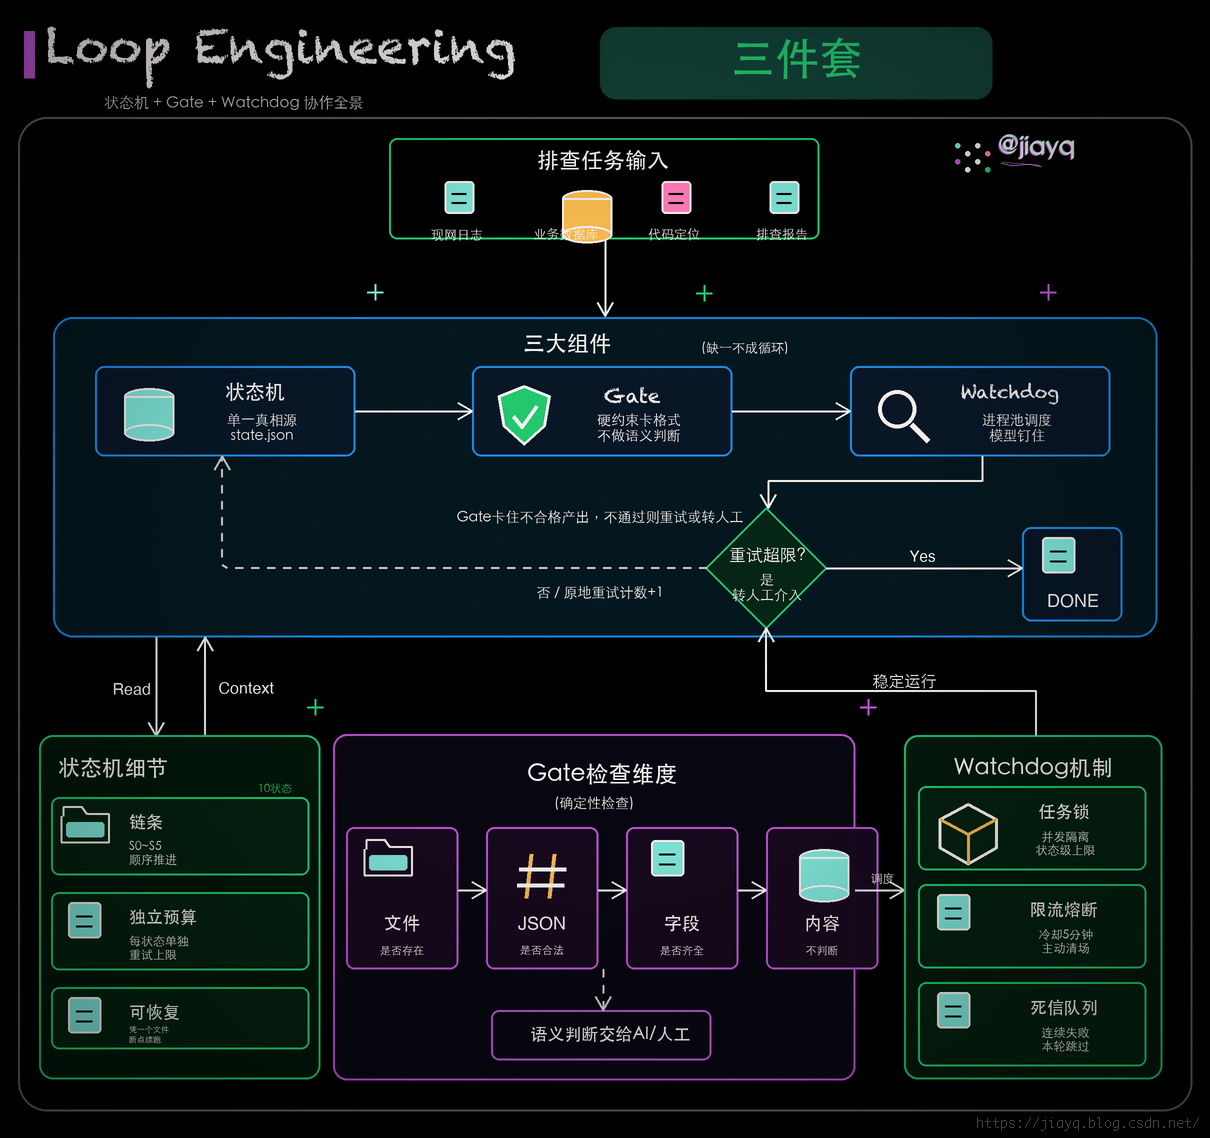
下面依次展开这三个组件,其中第二个组件(Gate)会重点回应”状态和门槛究竟是什么关系”这个问题。
四、组件一:状态机——单一真相源,而不是聊天记录
整套系统把每条排查任务抽象成一个 10 状态的有限状态机,任务目录下的 state.json 是唯一真相来源(Single Source of Truth) ,不依赖任何对话上下文——这意味着进程被杀掉、机器重启、换一个 Agent 会话接手,都可以凭这一个文件恢复到断点继续跑。
| State | 含义 | 产出物 | 最大重试次数 |
|---|---|---|---|
| S0_PARSE | 解析输入字段 | meta.json | 3 |
| S1_COLLECT | 并行采集日志 + 数据库 | log.md / db.md | 20 |
| S2_CODE | 本地代码定位根因 | code.md | 12 |
| S3_DRAFT | 生成初版报告 | v0.md | 10 |
| S3_JUDGE | AI 独立裁决(三要素 + 假失败预判) | judge.json | 50 |
| S4_REVIEW | 人工审核循环 | 无(等人) | 无限(0=不计入重试) |
| S4_AI_JUDGE | AI 解读人工意见后自决 | 无 | 5 |
| S5_PUBLISH | 落地工单 + Wiki + 双向回链 | publish.json | 8 |
| DONE | 终态:完成 | — | — |
| BLOCKED | 终态:转人工 | — | — |
状态之间不是简单的直线推进,而是”原地重试 → 通过则前进 → 超限则转人工”的循环结构,下图完整画出了这条状态机的转移逻辑(含每个状态的重试分支):
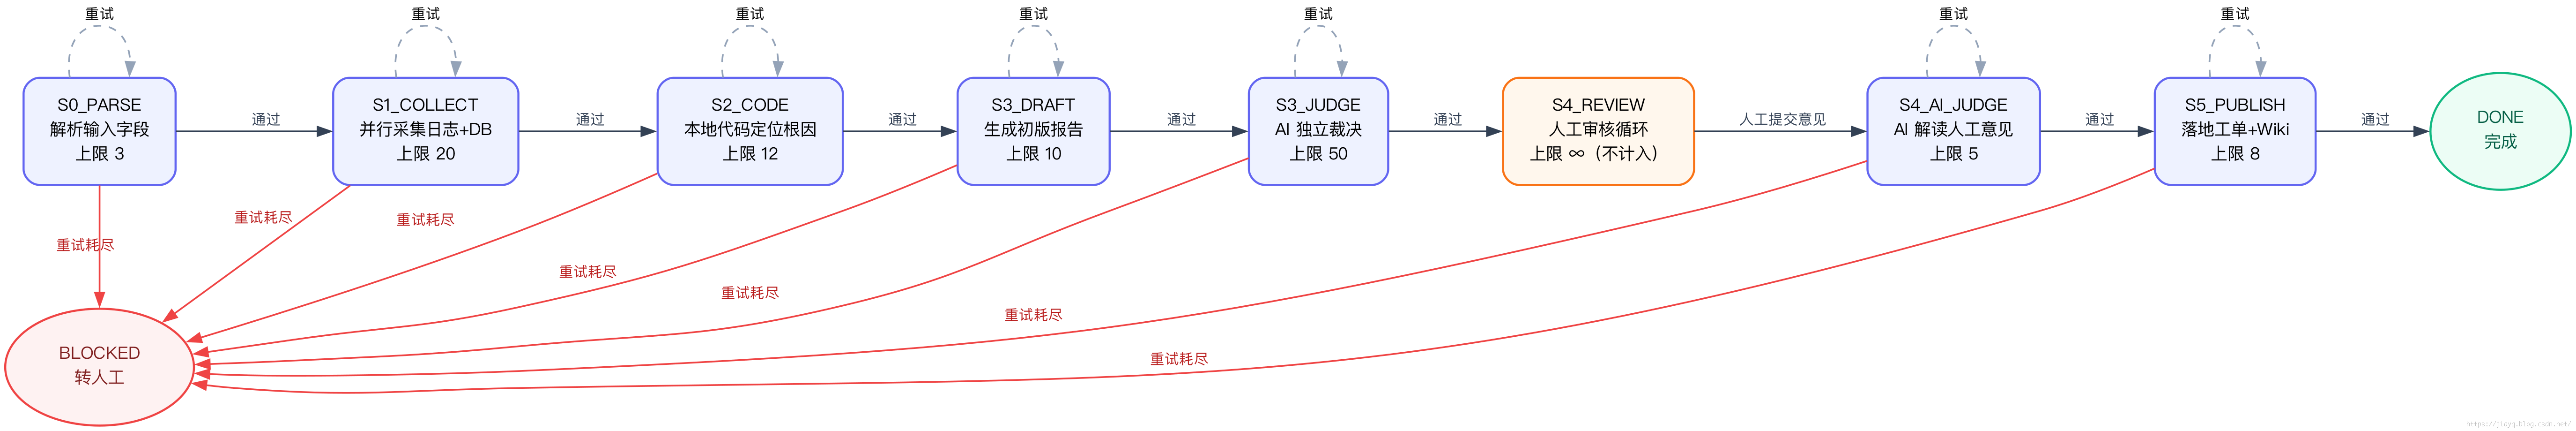
这里有个细节很值得说:每个状态的重试上限是独立设置的 ,而不是全局统一一个”最多重试 3 次”。S1_COLLECT 依赖的下游查询通道响应慢、偶发限流,所以给到 20 次;S3_JUDGE 是纯 AI 裁决,成本低、失败大多是格式问题,所以给到 50 次;S4_REVIEW 本质是等人,直接设为 0(无限循环,不消耗重试预算)。这是 Loop Engineering 里”循环预算分配”的第一课:不同环节的失败代价不同,重试策略也必须分层设计,而不是一刀切。通用规则是:重试代价越低、失败越可能是”噪声”而非”真实错误”的状态,给的预算越大;依赖人的状态,预算应该是”无限但不占用循环资源”,而不是被硬性掐断。
五、组件二:护栏 Gate——状态与门槛的关系
单靠状态机只解决了”任务在哪一步”的问题,没解决”这一步做得对不对”的问题。真正让循环敢无人值守跑起来的,是叠加在每一次状态转移上的 Gate(硬约束)。
状态和门槛的关系可以这样理解:状态是”任务此刻停在哪个格子”,Gate 是”离开这个格子之前必须先跨过的一道门”。 只有 Gate 判定通过,状态机才允许把 state.json 里的 state 字段改写成下一个值;判定不通过,任务原地不动、重试计数 +1,直到用完这个状态的重试预算才会被打上 BLOCKED。这套系统里有一条被反复验证的设计原则:
Gate 只做”确定性检查”(文件是否存在、JSON 是否合法、必填章节是否齐全、字段是否非空),不做”语义质量判断”(内容对不对、根因准不准)——语义判断交给专门的 AI judge 环节或人工审核环节。
把这条原则拆开看,就是”机器负责卡格式,智能负责卡内容”的分权。这样设计的好处是:Gate 逻辑可以用几行正则/JSON 校验写死、100% 确定性、不会因为模型漂移而变得时而严格时而宽松;而真正需要”理解”的质量判断,则被单独放进一个可审计、可复盘的裁决步骤里(S3_JUDGE / S4_AI_JUDGE),不会和格式检查混在一起。
下面这张图给出了任意一个状态通用的 Gate 判定流程:
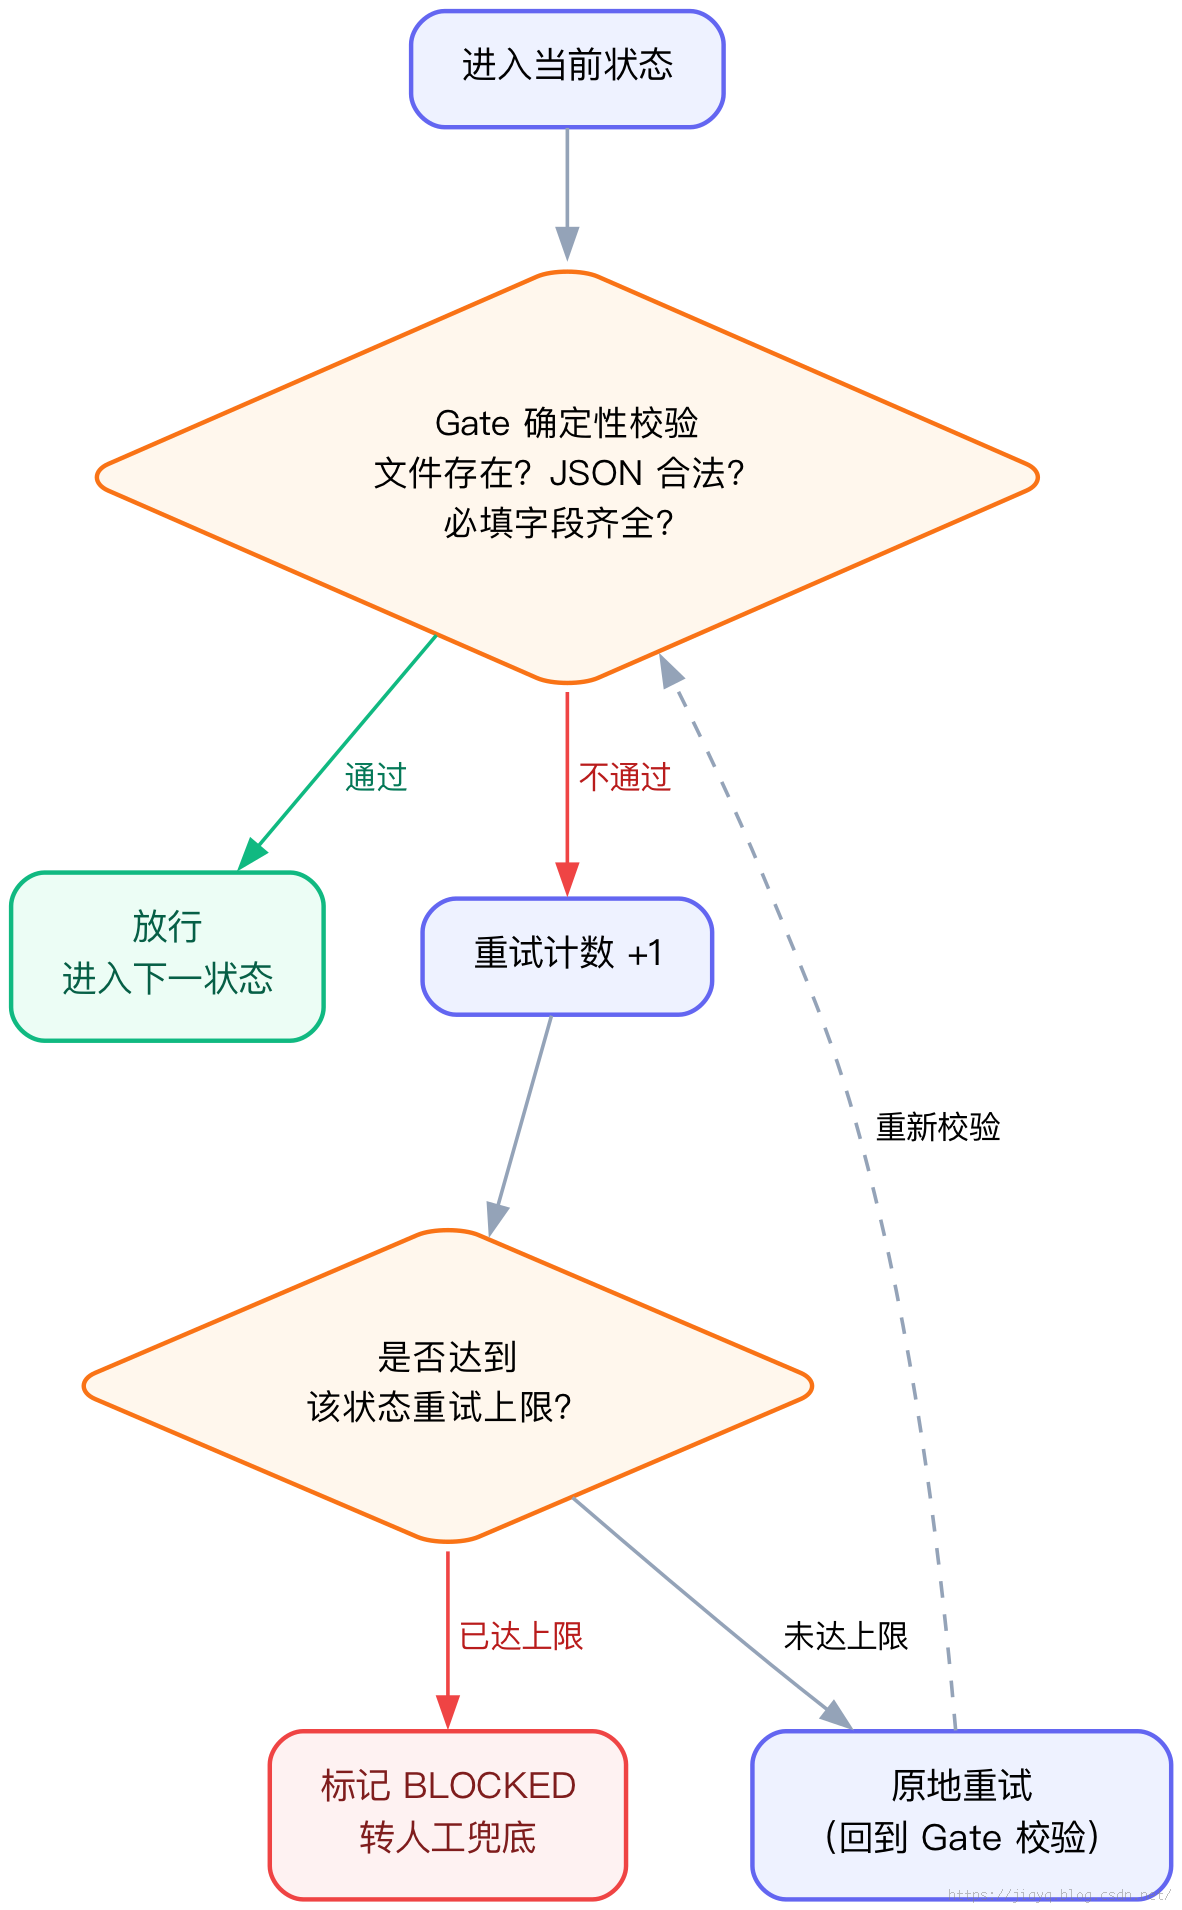
结合真实的 Gate 实现,逐条列出每个状态的门槛具体检查什么、以及它堵住了哪种”看起来完成了但其实没做对”的高危场景:
| State | Gate 检查什么(确定性) | 挡住的典型风险 |
|---|---|---|
| S0_PARSE | meta.json 关键字段齐全(地域/集群/应用/任务号等)且”定位组合”合法 | 关键定位信息缺失,导致后续查询无从下手却继续往下跑 |
| S1_COLLECT | 日志/数据库两份产出文件都存在,且都带 ## status: 状态头 | 采集没跑完或悄悄失败,却被当成”已采集”直接进入分析 |
| S2_CODE | 至少命中一条 文件路径:行号,或显式声明”证据不足” | AI 编造一个不存在的代码位置当根因,且无法核实 |
| S3_DRAFT | 8 个必填章节齐全 + “排查状态”三项指示灯全部为绿色/明确红色终态 | 报告看起来结构完整,但某个数据源其实是空的却没有任何提示 |
| S3_JUDGE | 裁决产出是合法 JSON,且 verdict 取值只能是 advance/retry 等枚举值 | AI 裁决结果格式跑偏,导致下游代码解析失败、状态机被写坏 |
| S4_REVIEW | 报告文件的修改时间(mtime)必须比进入审核时的基线更新,且新增了”人工意见”章节 | AI 自己在报告末尾补一句”通过”然后自我放行 (见下文单独展开) |
| S4_AI_JUDGE | 无格式门槛,但要求”理解语义”而非关键词匹配 | 把人工”这条不算真失败,但下次还要跟进”误判成简单的”通过” |
| S5_PUBLISH | 工单/文档的 ID 与链接 4 个字段非空,且双向回链校验通过 | 工单建了但文档没建成、或建了却没有互相引用,事后无法追溯 |
其中最值得单独展开的是 S4_REVIEW 的 mtime 防伪 :进入人工审核状态时,系统会记录报告文件的修改时间基线。只有当用户用编辑器打开文件、手动追加”人工意见”章节并保存(文件 mtime 真实变化)后,状态机才会放行进入下一状态。这条 Gate 直接堵死了一个高危场景——AI 自己在报告末尾补一句”通过”然后自我放行 。人工审核环节的可信度,本质上就是靠这一个 Agent 无法伪造的外部时间戳撑起来的。
另外一条同等重要的设计是结构化产出的”读写分权” :所有 JSON / 章节 / 表格类的结构化产出,全部由驱动脚本的自治命令拼装生成,Agent(无论主流程还是被调用的子任务)只允许填自由文本字段 。比如生成初版报告阶段,Agent 只能写 5 个自由文本字段(日志摘要/数据库摘要/代码摘要/根因/建议),报告的标题、章节结构、下游系统的字段映射全部是代码逻辑生成。这条设计的收益是:下游系统永远拿到格式正确的结构化数据,出错也只会出在自由文本内容的质量上,不会出在解析失败上。
六、亮点:给 Agent 的”填空模板”——把 Prompt Engineering 降级成填空题
如果说 Gate 是”事后拦截不合格产出”,那么这套系统里另一个同样值得借鉴的亮点是”事前从源头收窄 Agent 的自由度”——也就是发给 Agent 的每一条 Prompt 本身,都必须满足一份写死的规范(这套系统内部称为”指令铁律”,本文按通用叫法称为Prompt 模板铁律 ):
8 条铁律:
- 单一动作 :每个 Prompt 只做一件事,复合任务由驱动脚本拆成 N 个原子 Prompt 逐个发送,不许”读A然后分析B然后写C”。
- 输入输出绝对路径化 :所有文件给绝对路径,不让 Agent 自己拼路径,用占位符 token(如
<<LOG_FILE>>)由驱动脚本渲染替换。 - 输出格式给完整模板 :不让 Agent 自由生成结构(JSON / 章节 / 表格),给完整模板 +
<REPLACE_*>占位符,Agent 只填空位。 - 字数/行数硬约束 :自由文本必须给出”≥X 字且≤Y 字”,不给约束,Agent 不是写两行敷衍就是写两千字跑题。
- 句式骨架 :自由文本提供骨架句子,Agent 只填变量,例如”XX任务的直接原因是{X};根本原因是{Y}”。
- 完成信号
DONE::<TAG>:每个 Prompt 末尾要求 Agent 输出固定字符串,驱动脚本据此机器判定是否完成,没出现就视为未完成、自动重试。 - 禁止动作清单 :明令列出”禁止读取本 Prompt 未列出的文件”“禁止调用未指定工具”等负面清单,因为 Agent 很容易”举一反三”做超出预期的事。
- 失败回退指令 :给出”做不到时应该输出什么”的明确路径(例如
NOT_FOUND::REQUEST_ID),不让 Agent 在找不到数据时自己编一个。
把这 8 条落到一个通用框架里,每条 Prompt 都长这样:
1
2
3
4
5
6
7
8
9
10
[ACTION] <一句话动作描述>
[INPUT]  <输入文件绝对路径列表>
[OUTPUT] <输出文件绝对路径 + 格式模板>
[RULES]
- <字数/行数约束>
- <句式骨架(如有)>
- <禁止动作清单>
- <失败回退指令>
[DONE]   完成后输出最后一行:DONE::<TAG>
一个真实的反面/正面对比例子:
1
2
3
4
5
6
7
8
9
10
11
12
❌ 反样例(自由度过高):
请把日志、数据库、代码三份分析综合起来,给出根因分析报告,
内容要详尽,包括日志分析、代码分析、根因和建议。

✅ 改写后(拆 5 个原子动作):
[ACTION 1] 读事实卡片中"日志事实"段,用 ≤200 字总结写入 slots 文件的 log_summary 字段。
[ACTION 2] 读"数据库事实"段,用 ≤150 字总结写入 db_summary 字段。
[ACTION 3] 读"代码事实"段,用 ≤200 字总结写入 code_summary 字段。
[ACTION 4] 按句式:"{任务类型}任务的直接原因是{X};根本原因是{Y}。"写一行到
           root_cause 字段(30~150 字,必须包含"直接原因""根本原因"两个词)。
[ACTION 5] 写 2~5 条 bullet 到 suggestions 字段,每条 ≤100 字。
这 8 条铁律本质上是把”Prompt Engineering”降级成了”填空题设计”——这恰恰是 Loop Engineering 的精髓:当循环需要跑几百次而无人盯着时,Agent 的自由度是风险而不是能力。 这套模板体系也是这个项目里除状态机和 Gate 之外,投入产出比最高的一个亮点:它几乎不需要额外的运行时代码,只靠”写 Prompt 时更克制”就大幅降低了下游解析失败率。
七、组件三:驱动器——watchdog 的调度原则与”模型钉住”
如果说状态机是”骨架”、Gate 是”护栏”,那么驱动循环真正转起来的是 watchdog 守护进程。这是我认为整套系统里 Loop Engineering 落地得最彻底的部分,它的调度原则可以概括为五条:
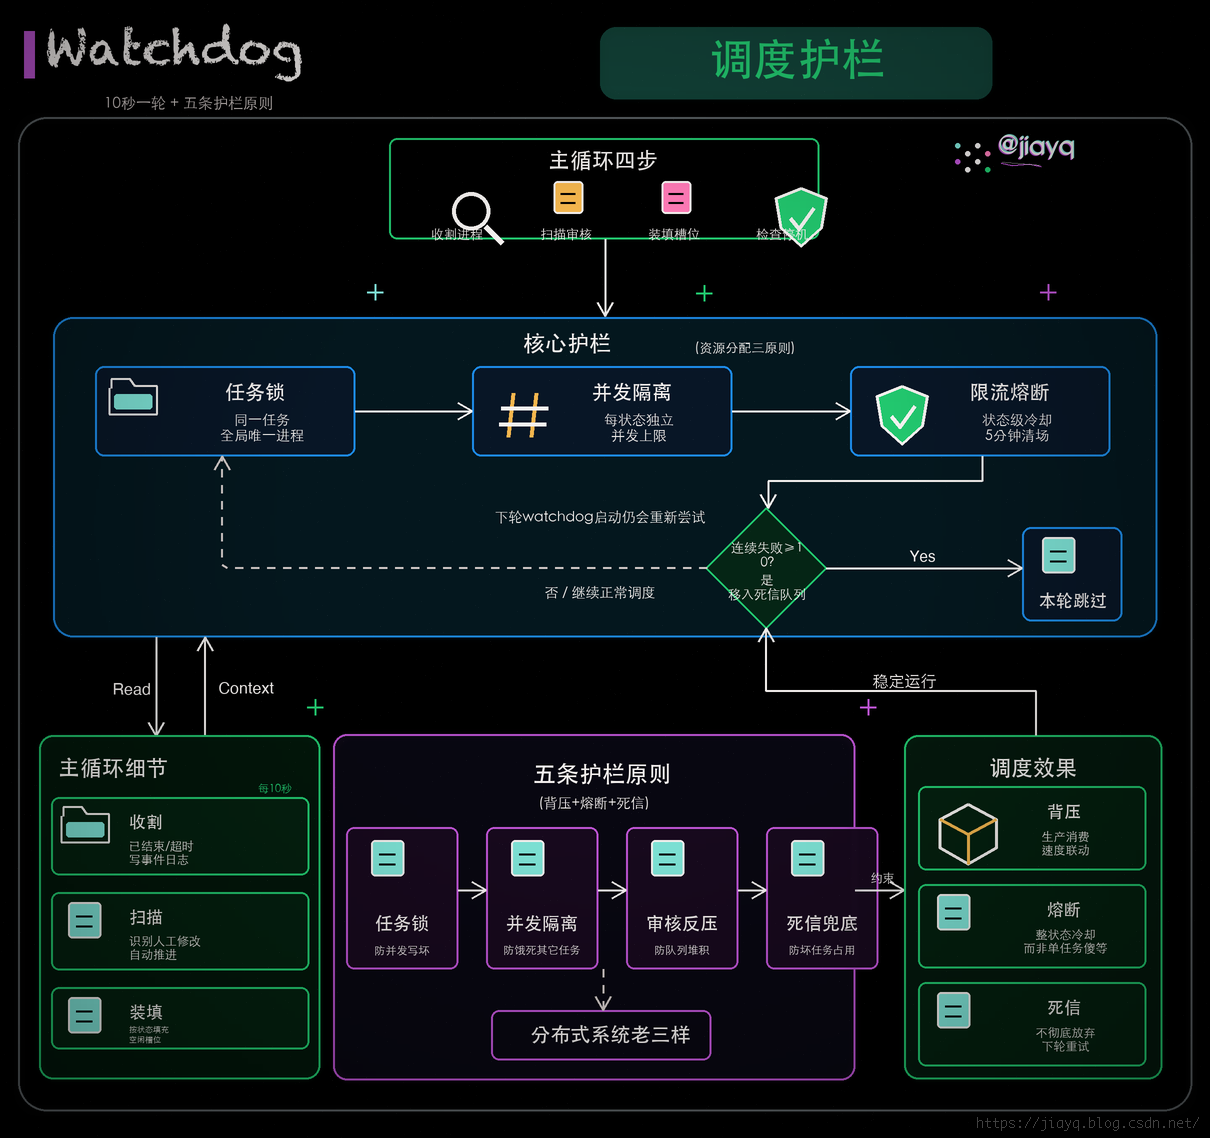
① 任务级锁 + 状态级并发隔离 :每条任务在独立的锁文件上加锁,保证同一条任务永远只有一个进程在跑(避免状态机被并发写坏),但不同任务之间可以并行——默认 5 个进程池,每个状态还单独设了并发上限(10)。这解决了一个常见的坑:如果不做状态级隔离,当某个状态(比如依赖限流下游通道的采集状态)大量堆积时,会把整个进程池占满,导致其它本可以推进的任务被饿死。
② 人工审核队列反压 :这套系统还专门给”等待人工审核”的任务队列设了一个上限(10 条)。一旦排队等审核的任务数达到上限,调度器会暂停向前置状态继续调度 (只保留消费队列的两个状态继续跑),直到人工把队列消化下去。这是一条容易被忽视但很关键的原则:循环的生产速度必须和消费速度(这里是人工审核速度)做联动限速,否则批量场景会演变成”AI 生产远快于人工消费”,队列无限堆积、审核体验直接崩掉。
③ 下游限流全局熔断 :当探测到某个状态大量因下游限流失败时,watchdog 会对整个状态 触发 5 分钟全局冷却,杀掉该状态下所有活跃进程,而不是让每条任务各自傻等重试——这是从”单任务重试”升级到”状态级熔断”的设计。
④ 死信队列兜底 :单任务连续罢工超过 10 次会被打入死信队列,本轮跳过、下轮 watchdog 启动仍会重新尝试。这样既不会让一条坏任务无限占用资源,也不会彻底放弃它。
这四条组合起来,本质上是给循环加上了背压(backpressure)+ 熔断(circuit breaker)+ 死信队列(dead letter queue)这套分布式系统里的老三样,只不过服务对象从”HTTP 请求”变成了”Agent 执行”。
⑤ 全局替换模型(模型钉住)—— 容易被忽视但很值得复用的设计 :watchdog 拉起的每一个执行子进程,都会通过显式参数强制指定一个统一、固定的模型版本去执行任务,完全不受当前交互式会话正在使用哪个模型的影响 。这背后是一条通用原则:
设计/调试 Loop 用的模型,和真正跑几百次重复劳动的”循环执行体”用的模型,应该被解耦,并显式钉住(pin),而不是隐式继承当前会话的模型。
这样做至少有三个好处:一是行为可复现 ——同一版本的执行模型跑同一套 Prompt,行为分布是稳定的,出问题也方便回归定位;二是成本可控 ——真正执行体可以选性价比更高的模型版本,而不必和用来设计/调试系统的模型保持一致;三是免受”默默升级”影响 ——如果执行模型隐式跟随当前会话,一旦默认模型版本发生变更,几百个正在跑的循环任务的行为可能一夜之间悄悄漂移而不自知。“循环的执行环境必须显式钉住” ,是这套系统里除状态机和 Gate 之外,第三个值得单独拎出来的亮点。
八、/goal 模式:把”发指令”升级成”设目标”
这套系统最初驱动一条任务的方式,是外部脚本每次只发一条原子指令、等 Agent 回复、脚本再判断下一步发什么——本质上是”一步一次外部调度”。升级到 v3 之后,改成了 /goal 模式:驱动脚本不再逐步发指令,而是给 Agent 一条目标声明 ,让 Agent 在一个进程内部自己反复调用工具、自主决定走多少步,直到命中某个可机器验证的终止条件为止。
/goal 的结构可以归纳成四要素(对应 Addy Osmani 总结的 Loop Engineering 四要素):
未达成且未超轮次
已达成
超过轮次上限仍未达成
① 目标 Goal
到达某个可描述的终态
② 执行 Execute
内部自驱多步、自主调用工具
③ 验证 Verify
外部命令输出是否
包含目标字符串
④ 终止 Terminate
正常退出
④ 终止 Terminate
无进展兜底退出
一个真实的 /goal Prompt 例子(<TASK_ID> 为示例任务标识,实际使用时替换为具体任务号):
1
2
3
4
5
6
7
8
9
10
11
12
13
/goal task <TASK_ID> in <项目目录>
reaches state S4_REVIEW or DONE or BLOCKED,
verified by <驱动脚本> show <TASK_ID>
output containing one of: '"state": "S4_REVIEW"' / '"state": "DONE"' / '"state": "BLOCKED"'.
Execute: cd <项目目录> && <驱动脚本> run <TASK_ID> --max-loops 60.
...
Strict constraints:
- ONLY process this one task
- NEVER ask user questions or wait for input
- NEVER spawn watchdog or other agent processes
- Stop when state reaches S4_REVIEW, DONE, or BLOCKED
- Stop after 60 turns if no progress
这条 Prompt 本身就是”设计一个循环”而不是”下达一个任务”——它规定了:
- 目标 :到达 S4_REVIEW / DONE / BLOCKED 任一状态;
- 验证 :某条外部命令的输出字符串 里是否出现指定内容——注意这里的验证条件是客观、机器可 grep 的字符串 ,而不是”Agent 自己说完成了”;
- 执行 :内部反复调用驱动脚本,自主决定跑多少轮;
- 终止 :命中目标状态即正常终止,或超过轮次上限仍未推进则兜底终止。
/goal 模式相比”外部脚本一步步发指令”的收益是减少了调度往返次数 :原来每推进一小步都要外部脚本重新发起一次调用,现在一个进程可以在内部自己跑完好几步直到命中终止条件,调度开销显著下降,同时终止条件依然是可机器验证的,不牺牲可控性。
九、Loop Engineering 与传统 Prompt 工程的对比
把上面拆的三个组件汇总起来,可以做一个直观对比:
| 维度 | 传统 Prompt Engineering | Loop Engineering |
|---|---|---|
| 优化对象 | 单次输入的措辞、示例、格式 | 整个执行循环的结构、终止条件、护栏 |
| 失败处理 | 靠更好的 Prompt 减少失败概率 | 假设一定会失败,设计重试/退避/熔断/死信 |
| 中间状态 | 隐藏在一次对话上下文里 | 显式落盘为 state.json,可观测可恢复 |
| 人工介入 | 混在对话里,边界模糊 | 独立状态(S4_REVIEW)+ 硬约束(mtime 防伪) |
| 自由度 | Agent 自由生成全部内容 | 结构化产出交给代码拼装,Agent 只填自由文本 |
| 执行模型 | 跟随当前会话,隐式继承 | 显式钉住固定版本,行为可复现、成本可控 |
| 调度粒度 | 无,人工盯着一条条跑 | 状态级并发隔离 + 队列反压 + 熔断死信 |
| 终止判据 | “感觉它应该做完了” | 机器可验证的字符串(如状态字段值) |
| 扩展到批量 | 需要人工逐条盯着 | 天然支持批量无人值守 |
这套对比也回应了行业讨论里的一个争议——Loop Engineering 争议的焦点从来不是”发明了新技术”,而是”给一个长期被低估的工程实践正式起了名字” 。状态机、幂等重试、熔断降级、单一真相源,这些在传统后端工程里早已是常识;Loop Engineering 做的事情是把这些常识重新应用到”用 Agent 自主执行长任务”这个新场景里,并强调了几个 Agent 场景特有的坑:Agent 会自己给自己”通过”审核、Agent 的自由发挥在批量场景下是负债、Agent 犯错后需要机器可判定的终止条件而不是”感觉它应该做完了” 。
十、落地点是什么:如何用这套方法论搭建你自己的系统
需要先澄清一个容易被误解的点:这篇文章真正的”落地点”,不是”排查失败任务”这套具体代码本身,而是一套可以迁移到任意”Agent 批量无人值守执行”场景的方法论骨架 ——说白了,只要你的任务满足”要重复执行很多次、有明确的成功/失败判据、可以容忍异步和重试”,就可以照搬下面这份九步清单,从零搭建一套结构相似的系统。
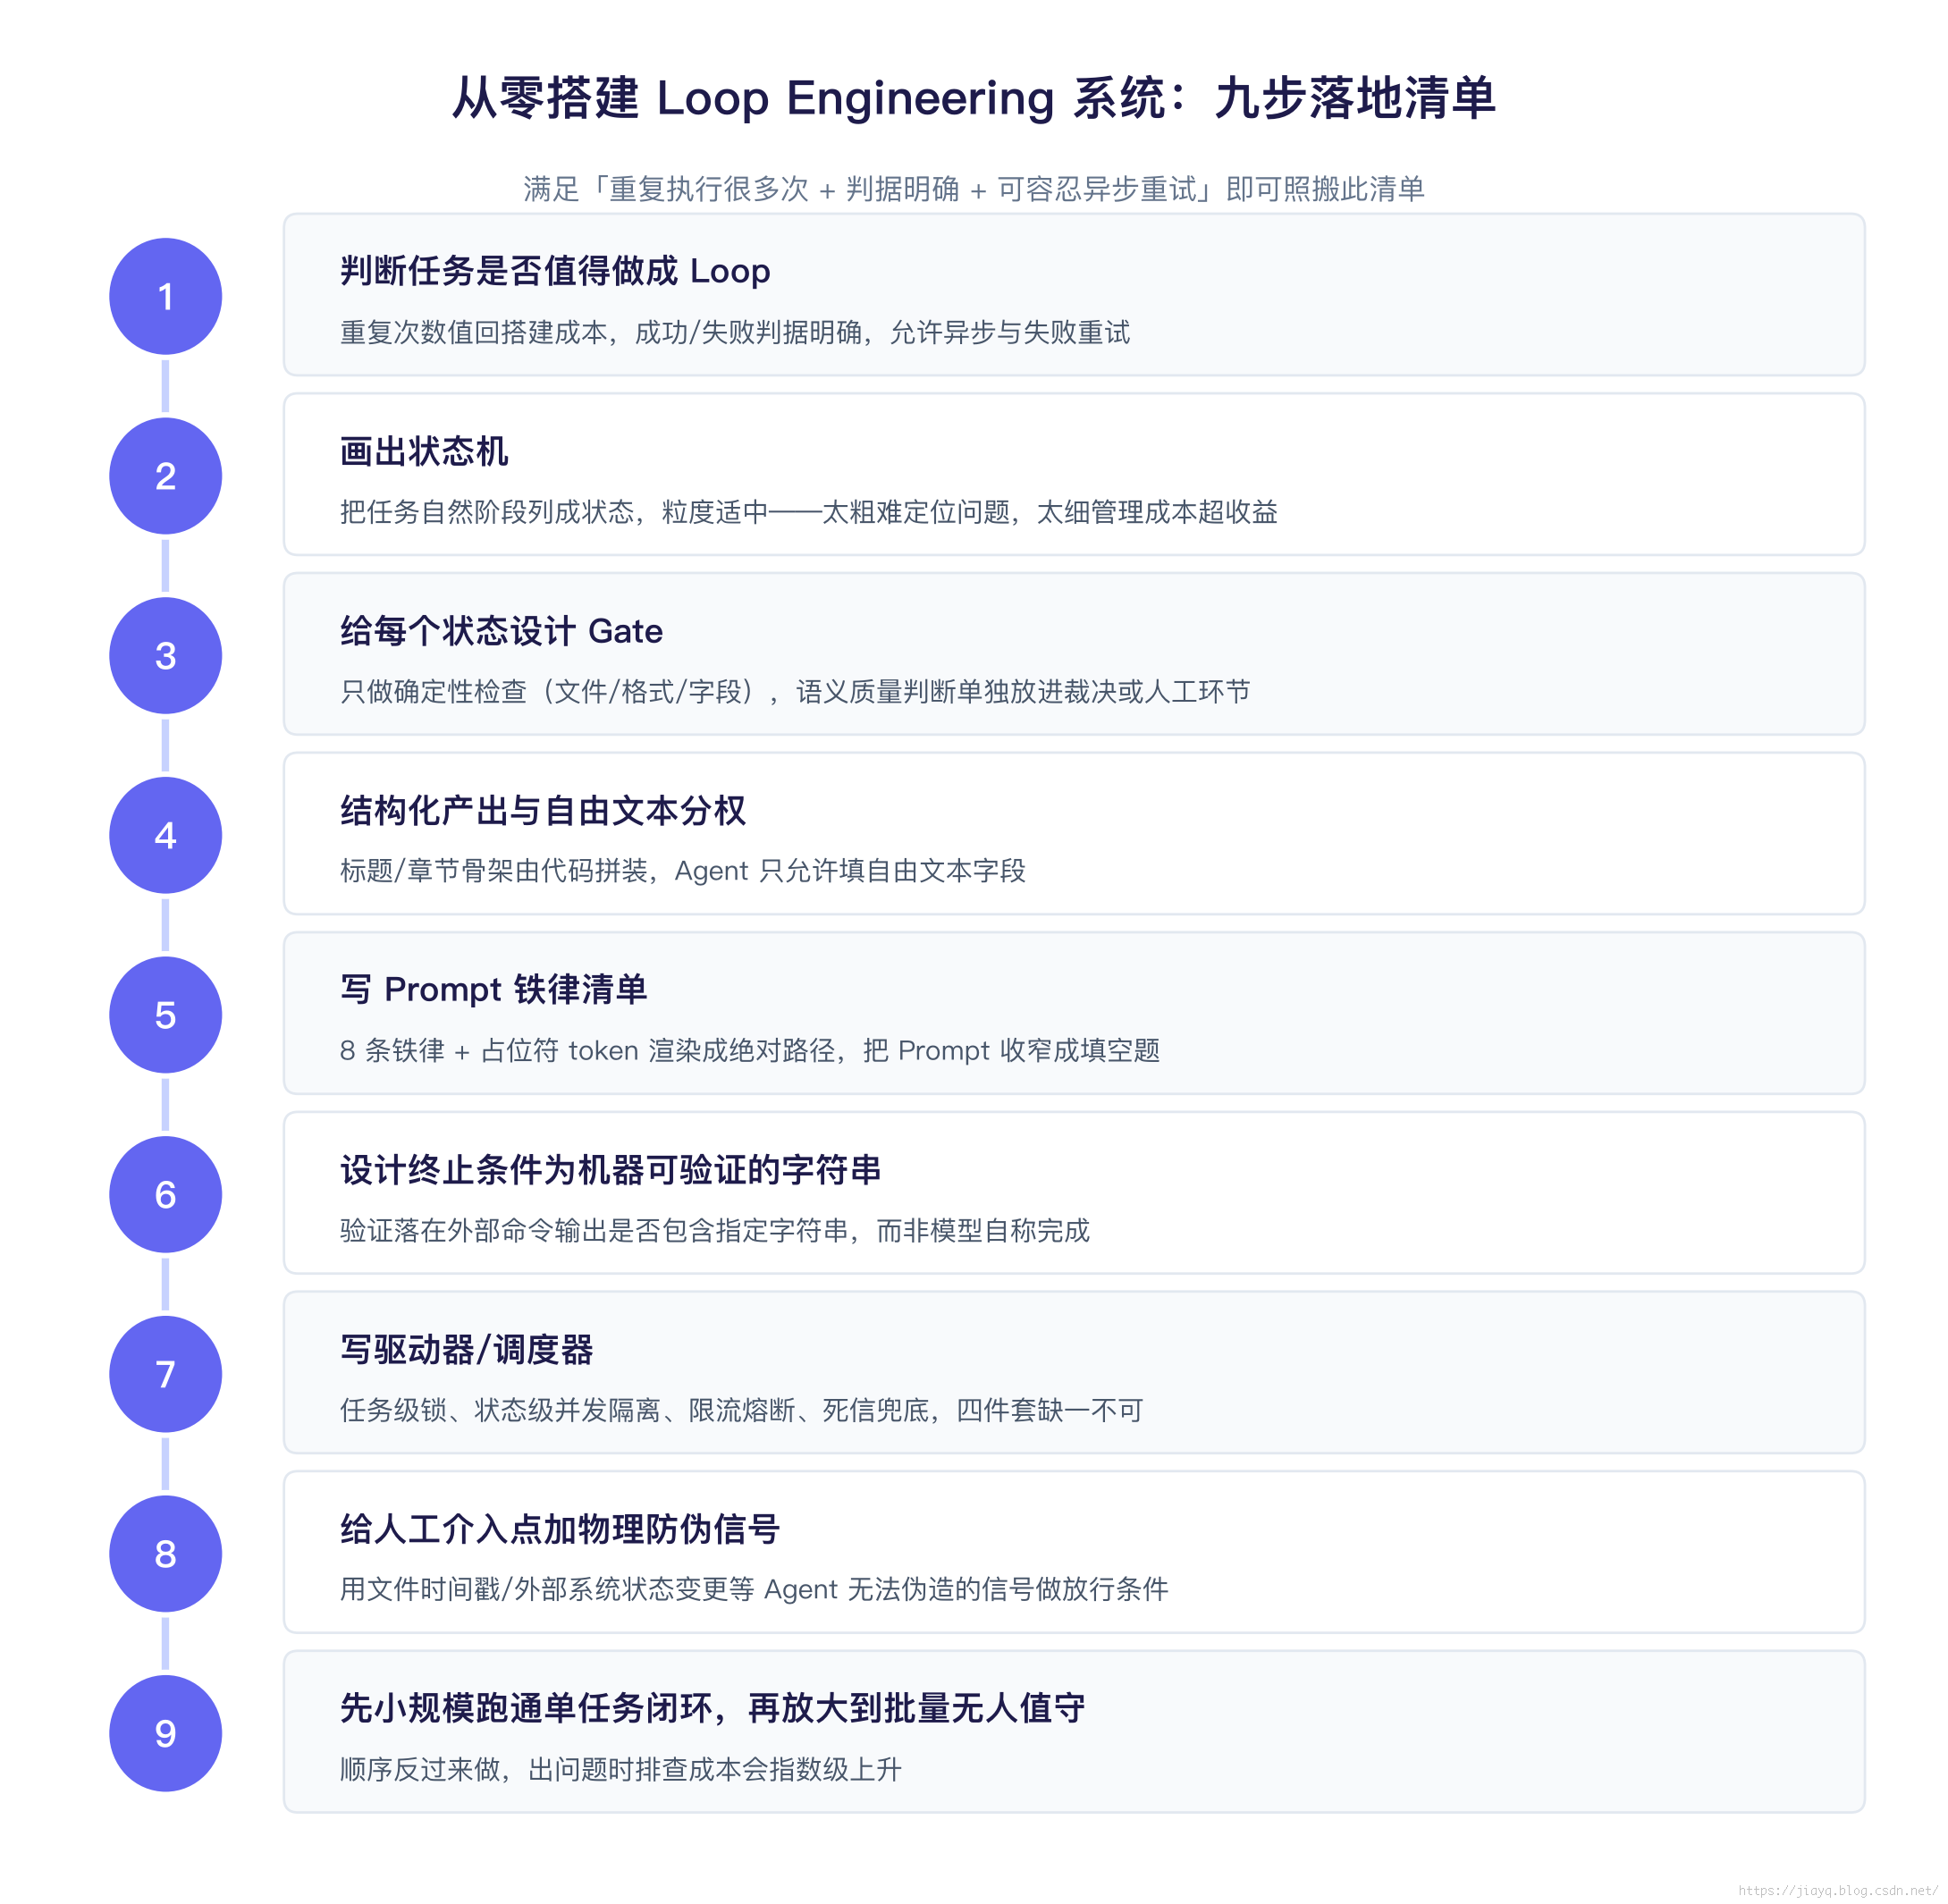
逐条展开:
- 判断任务是否值得做成 Loop :任务要重复很多次(几十次以上才值回搭建成本)、每一步的成功/失败有明确判据、允许异步执行和失败重试。如果只是偶尔跑一次,一把梭 Prompt 更划算。
- 画出状态机 :先把任务的自然阶段罗列出来(比如:收集数据 → 分析 → 生成草稿 → 裁决 → 人工审核 → 发布),每个阶段对应一个状态。状态划分的粒度要适中:太粗(比如把”收集+分析+草稿”合并成一个状态)会导致失败时无法定位是哪个子步骤出的问题;太细(拆成几十个微状态)会让状态机本身的管理成本超过收益。
- 给每个状态设计 Gate :牢记第五节的分权原则——Gate 只做”文件存不存在、格式对不对、字段齐不齐”这类确定性检查;”内容对不对、判断准不准”这类语义质量问题,单独放进一个裁决步骤或人工审核步骤,不要塞进 Gate 里用正则硬判。
- 结构化产出与自由文本分权 :明确哪些字段必须由代码拼装(标题、章节骨架、下游系统的字段映射),哪些字段允许 Agent 自由填空(摘要、根因描述、建议)。这条决定了你的系统会不会被”格式跑偏”反复卡死。
- 写 Prompt 铁律清单 :可以直接照搬第六节的 8 条铁律,再配上”占位符 token → 驱动脚本渲染成绝对路径”的机制,把每条 Prompt 都收窄成”填空题”。
- 设计终止条件为机器可验证的字符串 :不管是简单的一步式 Prompt,还是
/goal式自驱动指令,验证成功与否都要落在”某条外部命令的输出里是否出现指定字符串”,而不是”模型自己说完成了”。 - 写驱动器/调度器 :至少要有四件套——任务级锁(防止同一任务被并发跑坏)、状态级并发隔离(防止热点状态占满资源池)、超时与限流熔断(防止下游抖动拖垮整个池子)、死信兜底(防止坏任务无限占用资源,同时又不彻底放弃)。
- 给人工介入点加物理防伪信号 :不要相信”Agent 承诺不会代替人工签字”,要给一个 Agent 无法伪造的外部信号(文件时间戳、外部系统状态变更、第三方回调)作为放行条件。
- 先小规模跑通单任务闭环,再放大到批量无人值守 :单任务闭环验证状态机+Gate 设计是否合理,批量放大验证调度器的并发/熔断/反压设计是否顶得住。顺序反过来做,出问题时排查成本会指数级上升。
十一、复盘:踩过的坑与沉淀的亮点
从代码里保留的版本痕迹能看出,这套系统本身经历过多轮迭代(Gate 设计标注为第 4 版、驱动器标注为第 3 版),下面把”如果没有某个机制会出现什么问题”和”为此沉淀出的应对设计”配对复盘,供后来者参考同类坑位:
| 曾经/假设会遇到的坑 | 沉淀出的应对设计 |
|---|---|
| 一次性大 Prompt 在批量、无人值守场景下中间态不可见、无法断点续跑 | 拆成状态机,state.json 作为单一真相源,随时可从断点恢复(第二、四节) |
| 如果没有物理防伪,AI 有可能在报告末尾自己补一句”通过”然后自我放行审核 | mtime 防伪:只信任”文件被人编辑保存”这个 Agent 无法伪造的外部信号(第五节) |
| 只做简单关键词匹配来解析人工意见,容易把”这次不算真失败,但要跟进”误判成”通过” | 单独设一个 AI 解读人工意见的状态,明确要求”理解语义而非关键词匹配” |
| 全局统一一个重试上限,会导致依赖慢通道的状态总被过早判死,或本地判断类状态浪费太多重试预算 | 按状态分层设置重试预算(3 / 20 / 12 / 10 / 50 / 无限 / 5 / 8),依据失败代价和失败性质分别调整(第四节) |
| 不做状态级并发隔离,热点状态(比如依赖限流下游的采集状态)会把整个进程池占满,其它任务被饿死 | 状态级独立并发上限(第七节①) |
| 不做限流熔断,下游一限流,一堆任务同时傻等/反复重试,白白消耗进程池资源 | 探测到限流后对整个状态做全局冷却,主动清场(第七节③) |
| 人工审核队列如果不设上限,前置状态会无限制往里塞任务,人工根本看不完,体验直接崩掉 | 审核队列反压:超过上限暂停前置状态调度(第七节②) |
| 每一步都由外部脚本单独发起一次新的模型调用,调度开销大、总耗时长 | 升级为 /goal 自驱动模式,一个进程内部自己跑完多步(第八节) |
| 执行子进程如果隐式继承交互式会话当前用的模型,模型一升级,几百个跑着的任务行为可能悄悄漂移而不自知 | 显式钉住执行模型版本,和设计/调试用的模型解耦(第七节⑤) |
对应的亮点回顾一句话版:单一真相源的状态机、只卡格式不卡语义的 Gate、mtime 物理防伪、结构化与自由文本读写分权、8 条 Prompt 铁律、状态级并发隔离+队列反压+限流熔断+死信兜底的调度器四件套、/goal 自驱动、执行模型显式钉住——这八个点组合起来,就是这套系统能够无人值守跑几百条任务而不失控的全部秘密。
十二、成果展示:系统实际跑出的数字(脱敏统计)
前面十一节讲的都是设计决策,这一节把镜头切到运行数据本身——用系统投产以来累计沉淀的调度日志和产出物做一次脱敏统计,一是给”这套方法论到底管不管用”一个量化回答,二是反过来验证第四、五、七节里几个”拍脑袋”式的设计参数(重试预算、熔断阈值、并发上限)是不是真的踩在了实际负载的点上。以下所有数字均为聚合统计,已剔除任务号、地域、集群 ID、工单/文档链接等具体标识。
12.1 运行时长与任务规模
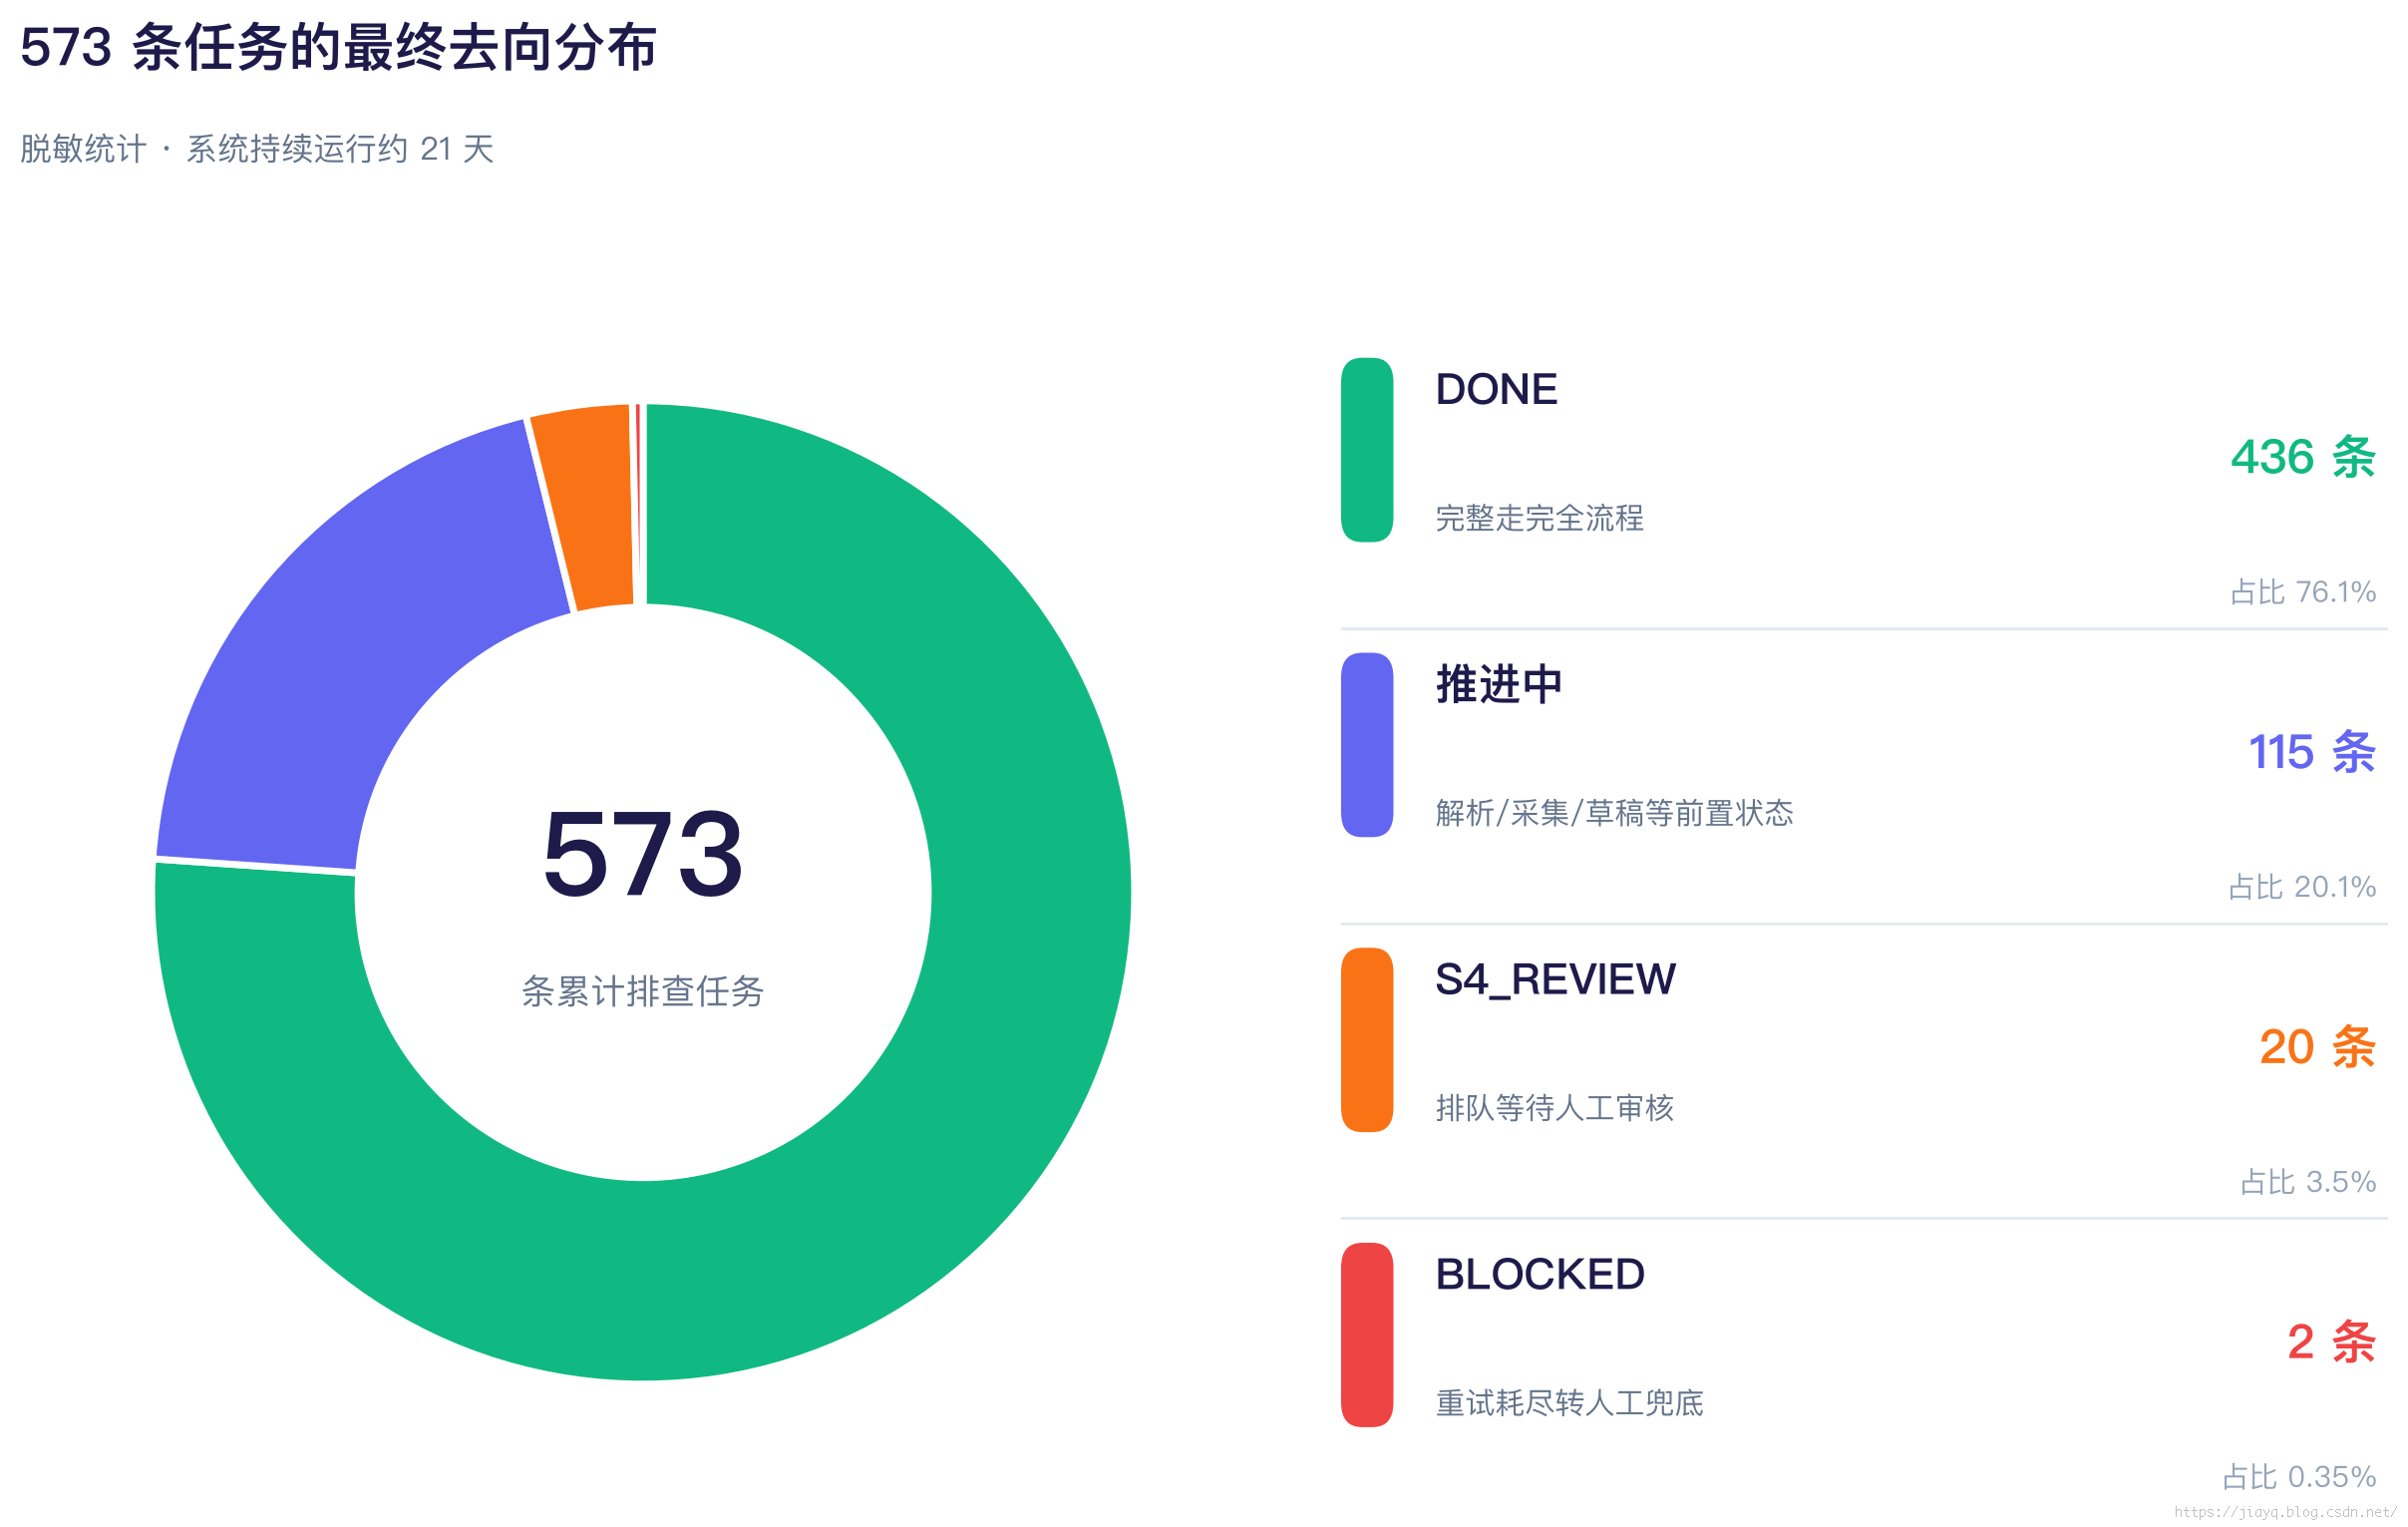
系统自首次投产以来已持续运行约 21 天(含 21 次 watchdog 重启/恢复周期,进度零丢失) ,期间累计纳入排查的失败任务达到 573 条 :
| 终态/当前状态 | 任务数 | 占比 |
|---|---|---|
| DONE(完整走完全流程,含发布) | 436 | 76.1% |
| S4_REVIEW(排队等待人工审核) | 20 | 3.5% |
| BLOCKED(重试耗尽,转人工兜底) | 2 | 0.35% |
| 仍在推进(解析/采集/草稿等前置状态) | 115 | 20.1% |
这里”21 次重启进度零丢失”值得单独点一下:因为 state.json 是单一真相源,21 天里无论是代码升级、机器重启还是人为调试打断,watchdog 每次重新拉起后都能直接从断点继续跑,没有一条任务因为进程被杀而从头重来——这是第四节”状态机是单一真相源”这条设计在真实运行中最直接的收益。
12.2 成果产出:工单与在线文档
排查完成并经人工审核通过的任务,会自动落地到工单系统和在线文档系统,并建立双向回链:
| 产出物 | 数量 |
|---|---|
| 成功创建的工单(issue / story) | 242 条 |
| 成功创建的在线文档(排查报告全文) | 242 篇 |
| 工单 ↔ 文档双向回链校验通过 | 242 条(占尝试发布任务的 98.8%) |
| 发布未完全成功(字段缺失/待补,已转人工兜底) | 3 条 |
242 条工单和 242 篇文档几乎一一对应,这不是巧合,而是第五节里 S5_PUBLISH 状态 Gate 的直接效果——Gate 强制要求”工单 ID / 文档 ID / 双向链接 4 个字段全部非空”才允许放行到 DONE,所以只要任务进了 DONE,就意味着这两个产出物一定是配套完整的,不存在”建了工单却没建文档”的半成品。
12.3 调度执行规模与每状态成功率
把 watchdog 的调度事件日志按类型汇总:
| 事件类型 | 累计次数 | 说明 |
|---|---|---|
| 子进程调度(spawn) | 6,443 | 累计拉起的 Agent 执行子进程总数 |
| 正常收割(reap) | 6,413 | 子进程结束并被 watchdog 回收 |
| 超时强杀(kill) | 2,531 | 与下表各状态 timeout 计数总和完全吻合,交叉验证了日志的一致性 |
| 死信队列触发 | 1,950 | 连续失败任务被暂时移入死信队列、本轮跳过 |
| 下游限流全局熔断 | 239 次触发 / 238 次解除 | 平均每次冷却 5 分钟,累计约 20 小时的保护性冷却 |
| 人工审核后批量推进 | 760 | watchdog 扫描到人工意见后自动触发的批量 advance |
| watchdog(重)启动 | 21 | 对应 12.1 节的 21 个运行周期 |
再按状态拆开看每一轮执行的成功 / 失败 / 超时次数(这里的”失败”特指 Gate 判定不通过触发重试,”超时”指单次子进程跑满时限被强杀):
| 状态 | 成功 | Gate 判定失败 | 超时 | 单轮通过率 |
|---|---|---|---|---|
| S0_PARSE(解析输入) | 1,770 | 1 | 89 | 95.2% |
| S1_COLLECT(并行采集日志+数据库) | 303 | 17 | 2,406 | 11.1% |
| S2_CODE(代码定位) | 90 | 1 | 1 | 97.8% |
| S3_DRAFT(生成草稿) | 223 | 8 | 6 | 94.1% |
| S3_JUDGE(AI 裁决) | 391 | 17 | 11 | 93.3% |
| S4_AI_JUDGE(解读人工意见) | 661 | 7 | 11 | 97.4% |
| S5_PUBLISH(发布工单+文档) | 196 | 15 | 7 | 89.9% |
| 合计 | 3,804 | 78 | 2,531 | 59.3%(剔除 S1_COLLECT 后为 95.0%) |
这张表里最值得解读的是 S1_COLLECT 的超时占比高达 88% :这个状态依赖的是外部日志/数据库查询通道,天然响应慢、偶发限流,这正是第四节里解释”为什么给 S1_COLLECT 单独分配 20 次重试预算(远高于其它状态的 3~12 次)”的原始动机——这份运行数据反过来验证了那个”拍脑袋”参数拍对了 :如果按全局统一的重试上限(比如 3 次)来跑,S1_COLLECT 里绝大多数任务会在真正查到数据之前就被判定重试耗尽、错误地打成 BLOCKED。而把这一个”噪声大户”状态摘出去看,其余状态的单轮通过率普遍在 90%~98% 之间,整体(剔除 S1_COLLECT)单轮通过率达到 95.0%,说明 Gate 的”只卡格式不卡语义”设计在绝大多数状态下都能一次性放行,只在依赖不稳定下游的环节才需要靠重试预算和熔断去扛。
12.4 小结
把这几组数字连起来看:21 天、573 条任务、6,443 次子进程调度、242 组配套完整的工单+文档、95% 的(剔除慢通道后)单轮通过率、零进度丢失的 21 次重启 ——这些数字本身不是重点,重点是它们全部来自日志和产出物的机器统计,而不是”感觉这套系统跑得还不错”。这也是 Loop Engineering 相比传统人工判断的一个隐性收益:当循环被设计成状态机 + Gate + 结构化日志,系统运行得好不好,从来不需要问 Agent,直接问日志就行。
十三、写在最后
Loop Engineering 不是一个全新的架构范式,它更像是给”如何让 AI Agent 在无人盯着的情况下长期自主运行”这件事,提供了一套可以对齐讨论的词汇表:Loop(循环体怎么设计)、Gate(护栏怎么卡、和状态是什么关系)、模板(怎么把 Prompt 收窄成填空题)、调度原则(怎么分配资源、怎么熔断、执行模型怎么钉住)、/goal(怎么把”发指令”升级成”设目标”)、终止条件(什么时候算完成)、恢复机制(失败了怎么自己爬起来)。
这次拆解的排查系统只是一个具体案例,但它验证的结论是通用的:当你需要 Agent 从”回答一个问题”升级到”独立跑完一个跨越几十步、持续几小时、可能中途失败重启的任务”时,你真正要设计的从来不是更好的 Prompt,而是一个更好的循环。 第十节给出的九步清单,就是把这个结论转化为”别人也能照着搭一遍”的具体行动路径——这大概就是”Loop Engineering 的落地”最朴素的含义。
写到这里回头再看,这套系统从 v1 迭代到 v3(Gate 第 4 版、驱动器第 3 版),说白了就是不停在”哪里会被 Agent 钻空子”和”怎么用最朴素的机制堵住”之间打补丁——状态机、幂等重试、熔断降级这些手艺,后端工程师干了十几年,谈不上什么新发明。真正的门槛从来不是”发明”,而是有没有把这些老手艺一条条踏踏实实地用在”看着 Agent 犯错然后帮它自己爬起来”这件新场景上。以后要是还要搭类似的无人值守系统,这份九步清单我是打算直接照搬的,加油!
参考资料
- Peter Steinberger / Boris Cherny 关于 Loop Engineering 的原始推文讨论
- Addy Osmani 对 Loop Engineering 概念的系统整理
- 本文案例:内部失败任务批量排查系统(状态机 v3 + watchdog 守护进程实现,文中工单系统 / 在线文档系统均为通用指代)