从一条直线到大模型输出一个token(八):残差连接与前馈网络
从一条直线到大模型输出一个token(八):残差连接与前馈网络 建议先看:从一条直线到大模型输出一个token(七):注意力权重与多头机制 上一篇算出了注意力的输出 O。这一篇走完 Block 的剩余三步:残差相加、归一化、FFN。本篇的主角其实是激活函数——网络里唯一的"掰弯"零件。 1. 分工:注意力管交流,FFN 管消化 先摆清楚 Block 两员大将的分工,如图 8-1 所示。 图8-1
文章信息
- 原文链接:https://jiayq.blog.csdn.net/article/details/163999130
- 发布时间:2026-09-07 11:49:43
从一条直线到大模型输出一个token(八):残差连接与前馈网络
建议先看:从一条直线到大模型输出一个token(七):注意力权重与多头机制
上一篇算出了注意力的输出 O。这一篇走完 Block 的剩余三步:残差相加、归一化、FFN。本篇的主角其实是激活函数——网络里唯一的”掰弯”零件。
1. 分工:注意力管交流,FFN 管消化
先摆清楚 Block 两员大将的分工,如图 8-1 所示。
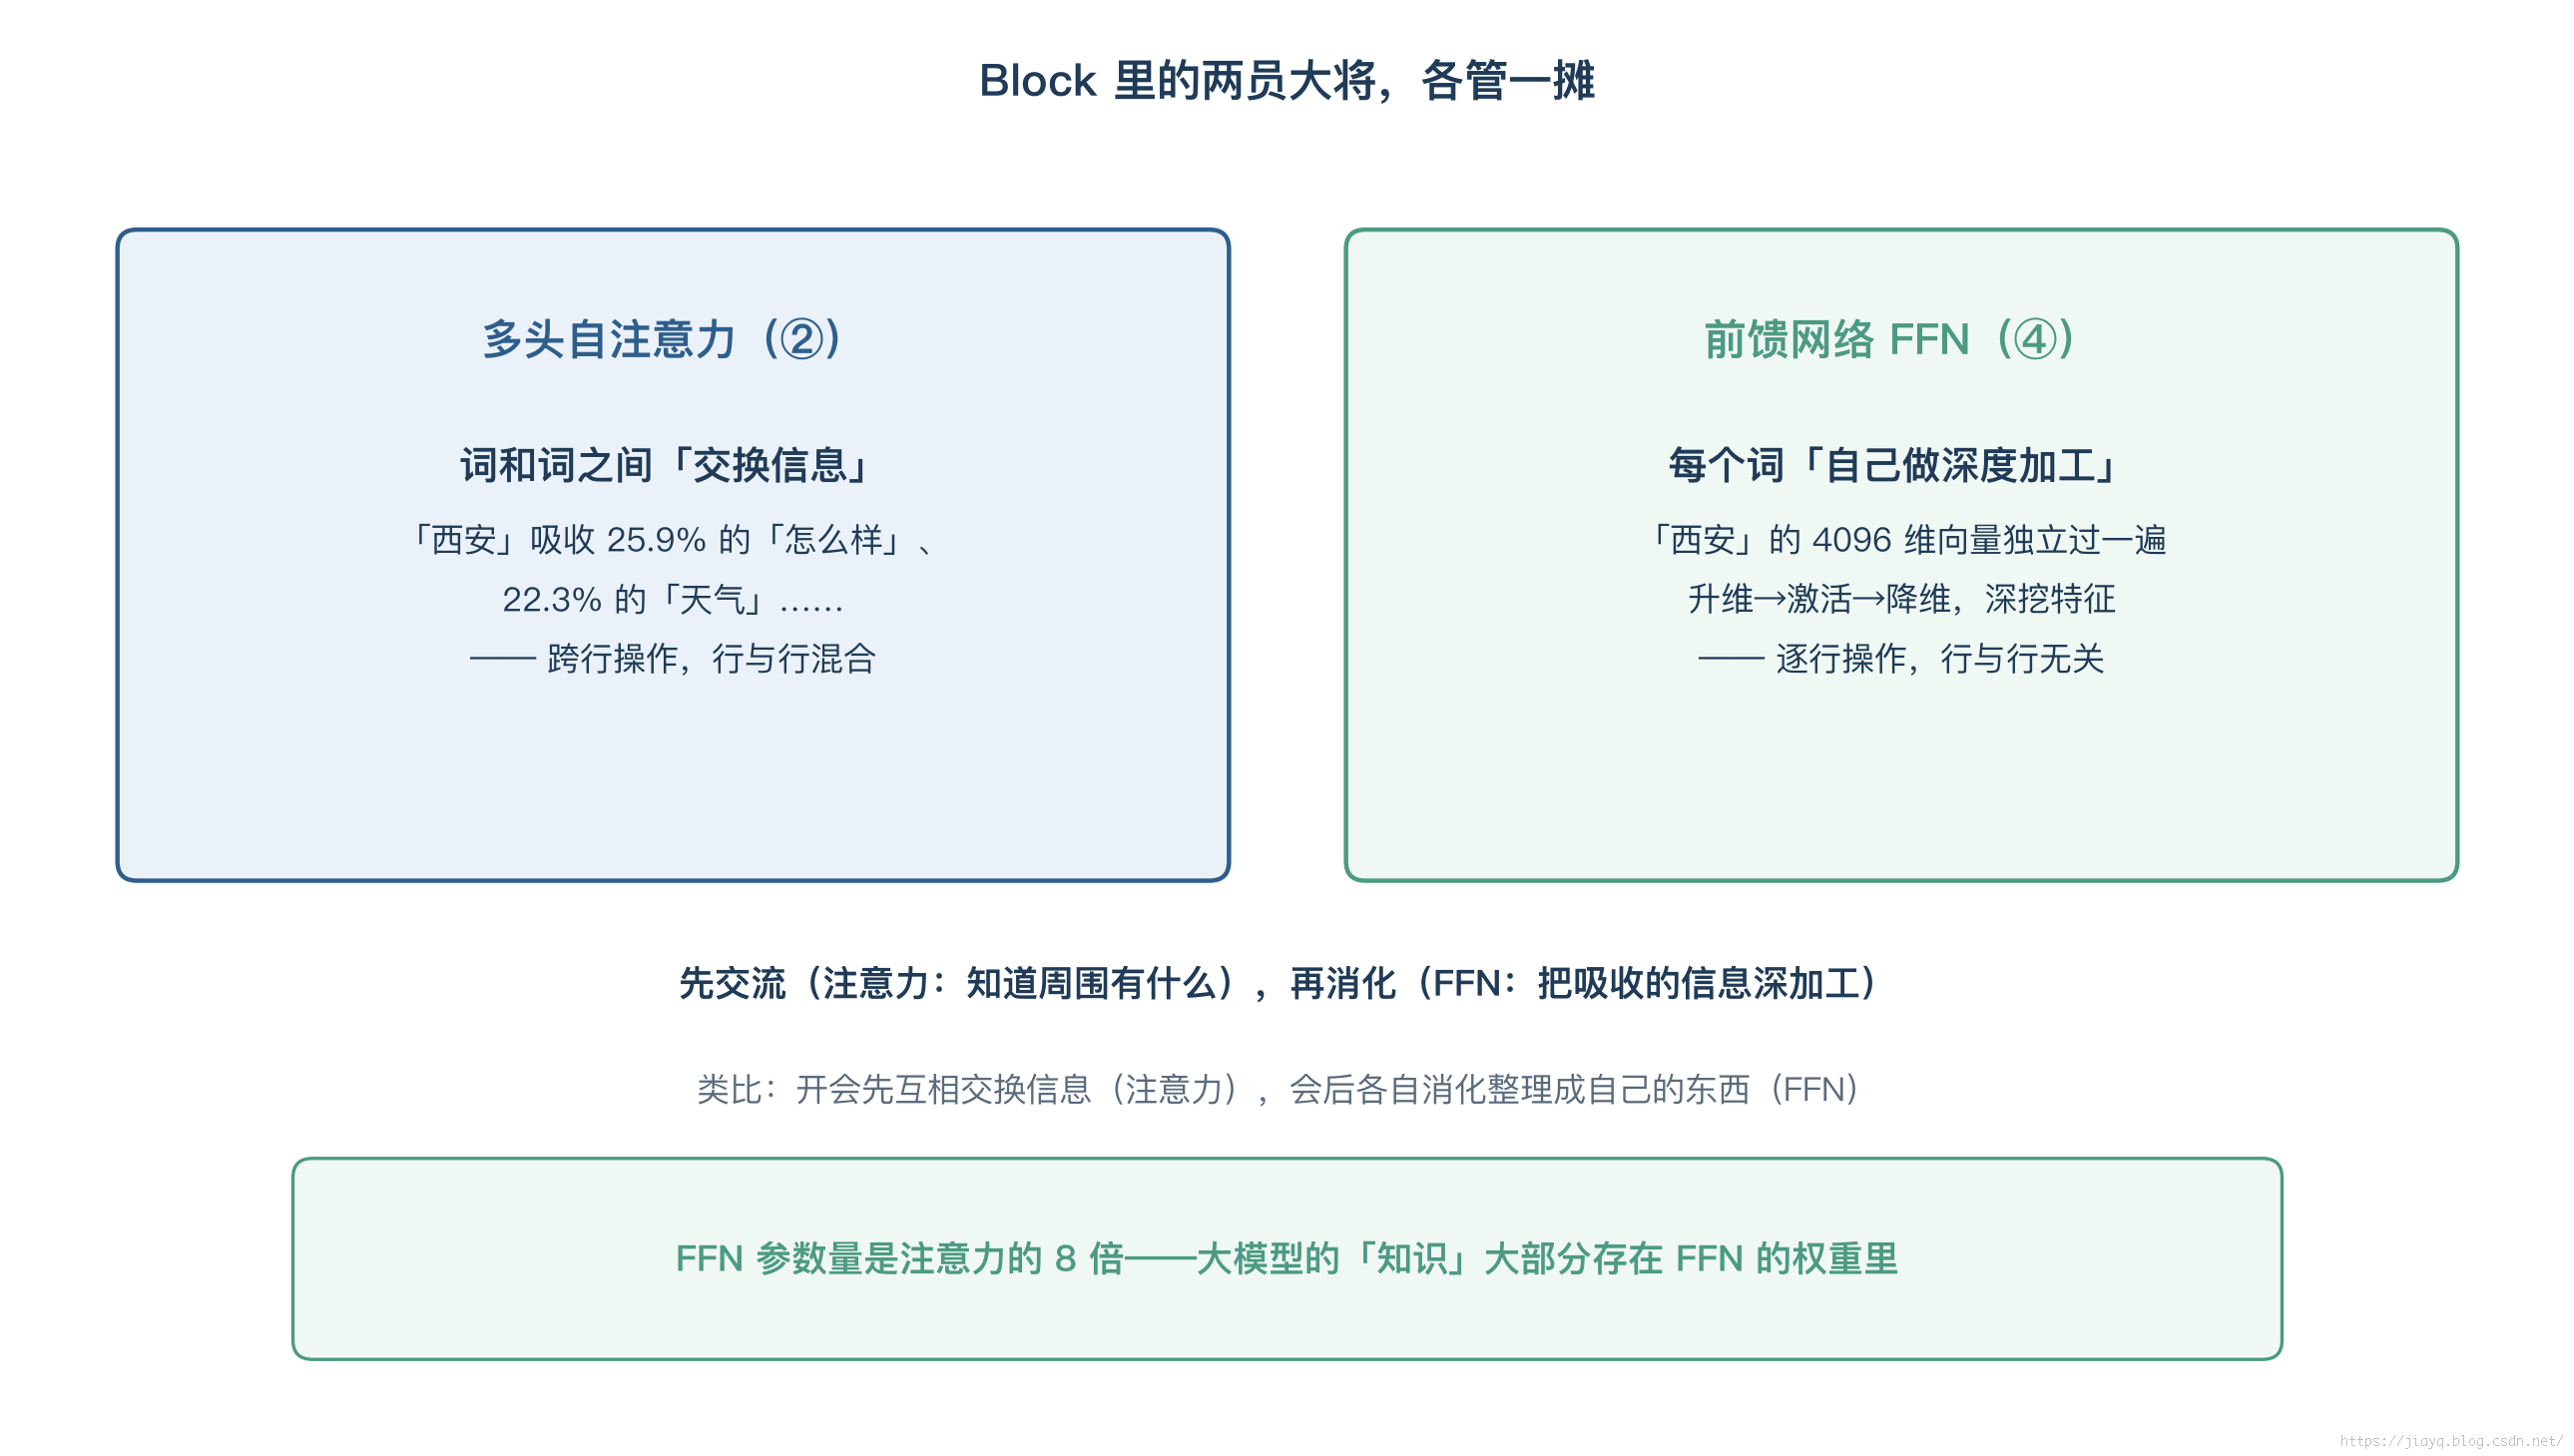
图8-1 注意力 vs FFN:一个管词间交换信息,一个管词内深度加工
- 多头自注意力(②):词和词之间交换信息。「西安」吸收 25.9% 的「怎么样」、22.3% 的「天气」……上一篇的 $\mathbf{A}\mathbf{V}$ 干的就是跨行混合——跨行操作,行与行互相影响
- 前馈网络 FFN(④):每个词自己做深度加工。「西安」的 4096 维向量独立过一遍”升维→激活→降维”,深挖自己的特征——逐行操作,行与行互不相干
类比:开会先互相交换信息(注意力:知道周围有什么),会后各自消化整理成自己的东西(FFN:把吸收的信息深加工)。
2. 残差连接:原始信息的高速通道
2.1 定义:加工结果 + 原始输入
残差连接的公式只有一行:
\[\mathbf{H} = \mathbf{X} + \text{Attention}(\mathbf{X})\]注意力算完的加工结果,逐元素加上未经加工的原始输入。贯穿案例的手算如图 8-2 所示(红色 = 每行最大值,下同)。
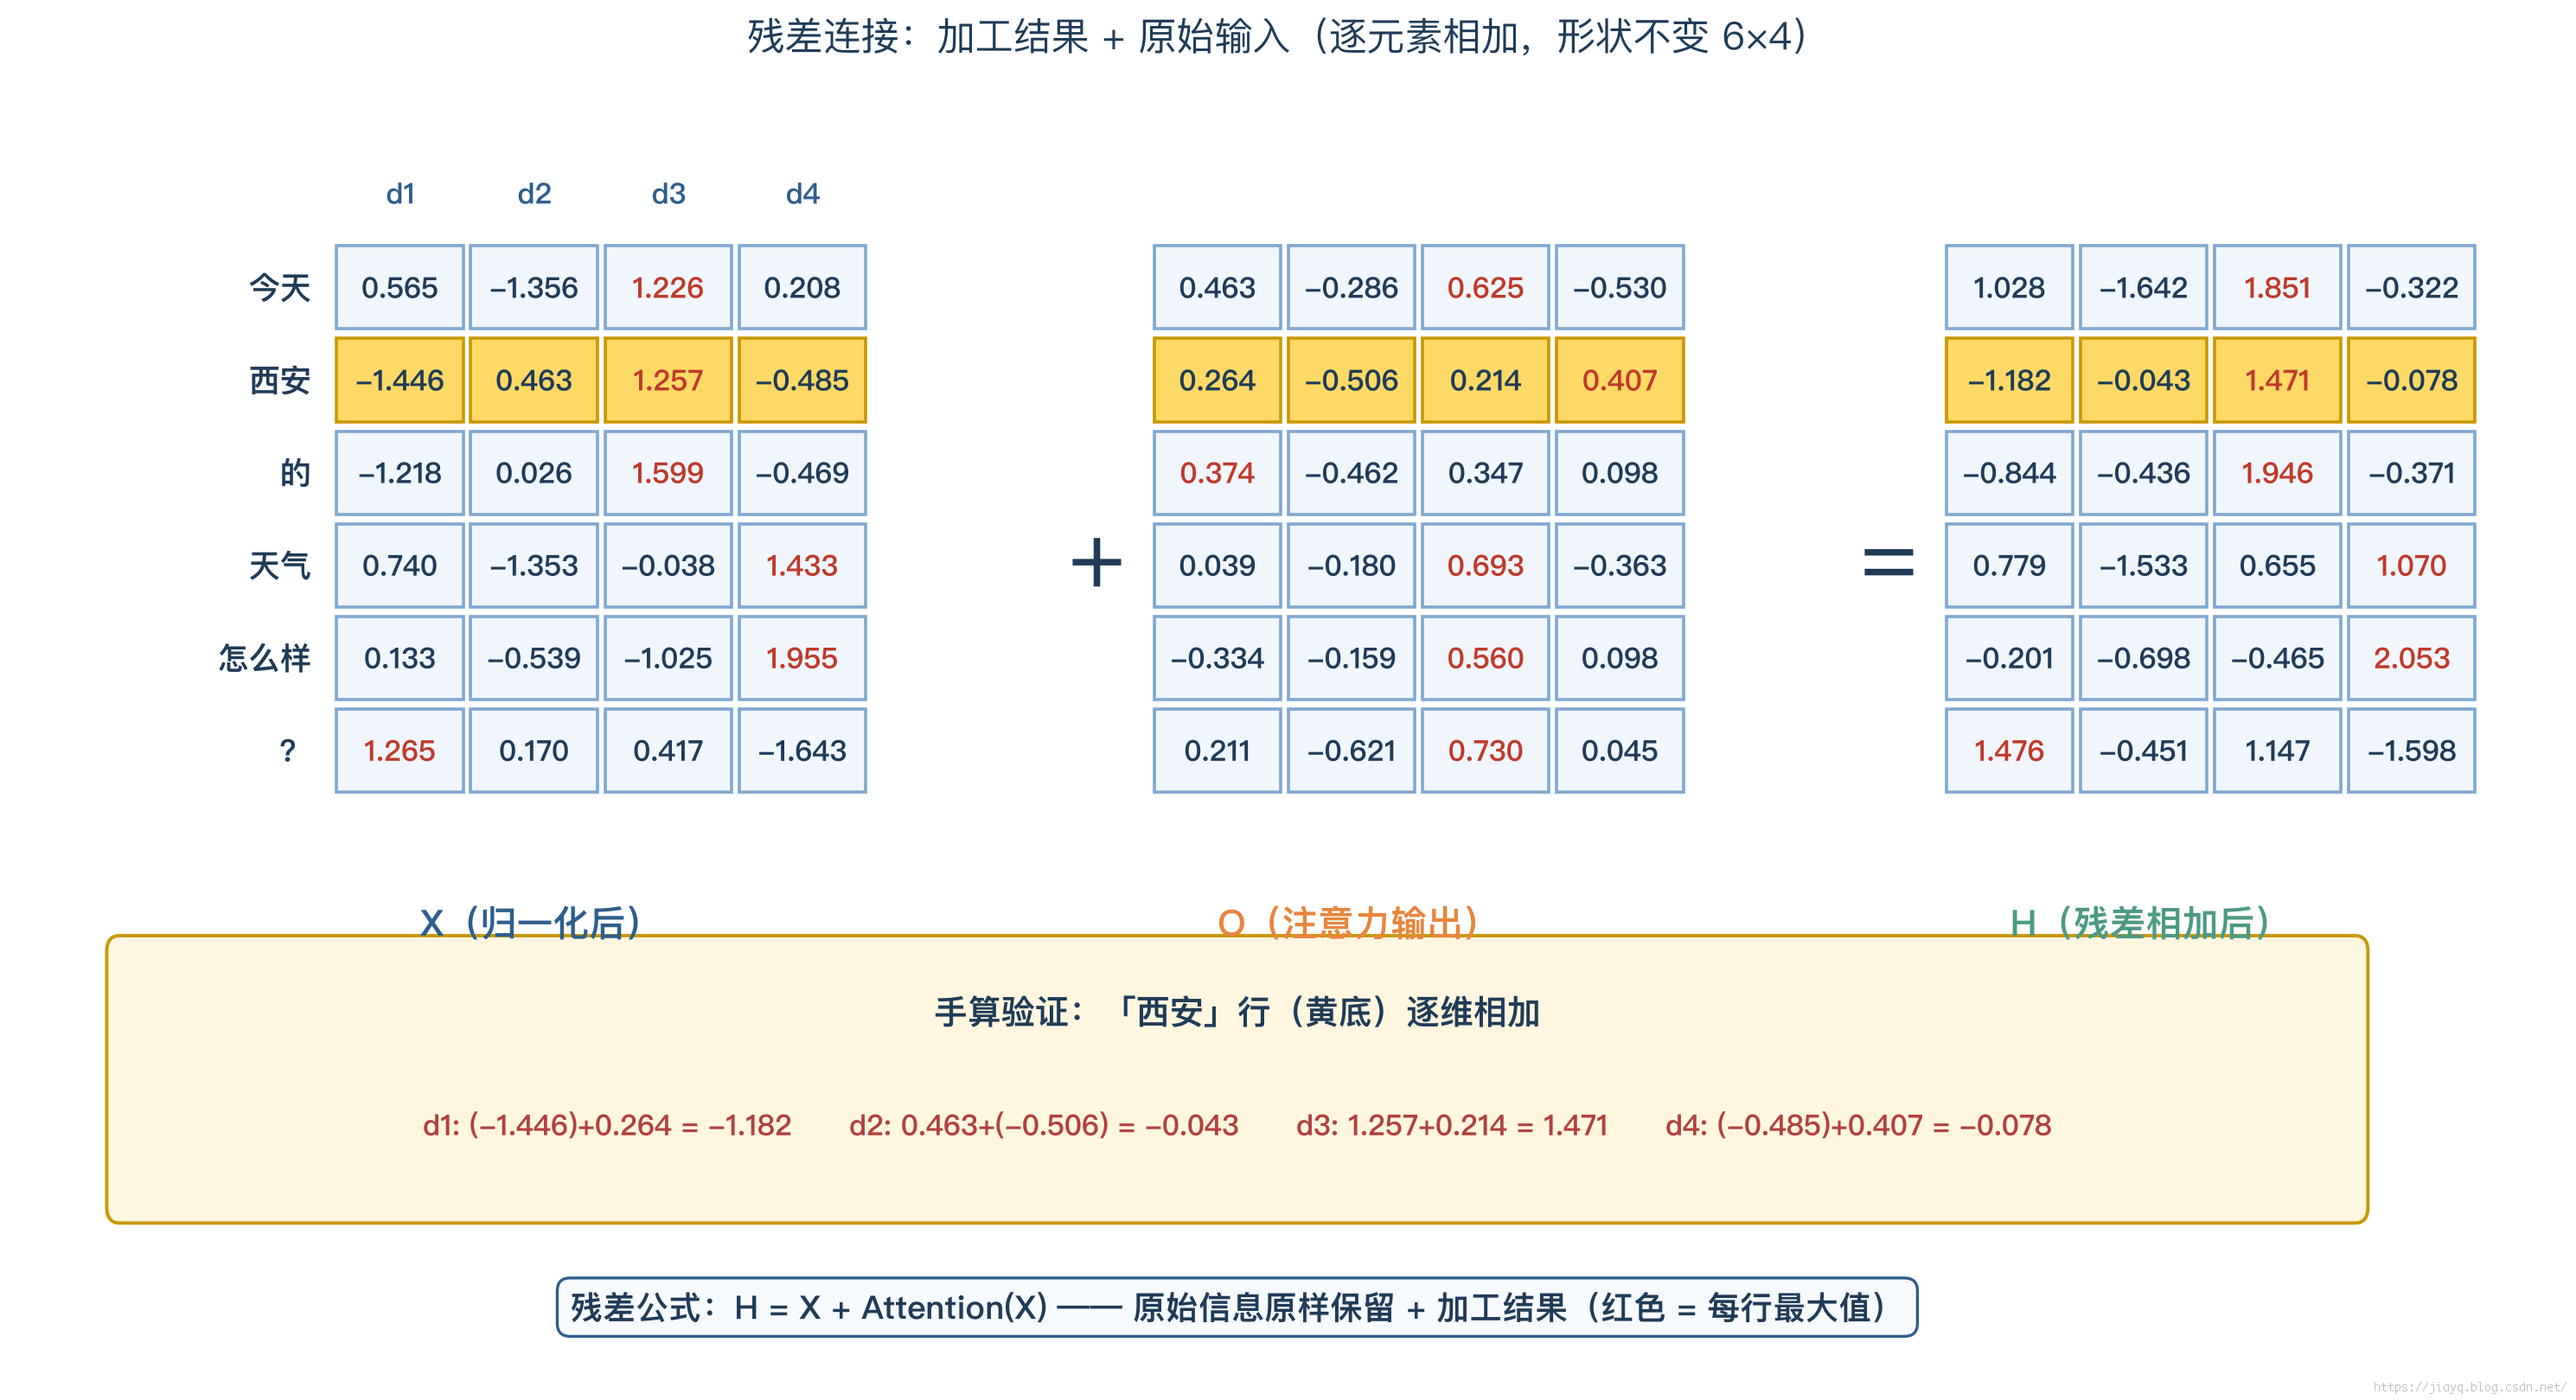
图8-2 残差连接:加工结果 + 原始输入(西安行手算,红色 = 每行最大值)
「西安」行逐维相加:$(-1.446) + 0.264 = -1.182$,$0.463 + (-0.506) = -0.043$,$1.257 + 0.214 = 1.471$,$(-0.485) + 0.407 = -0.078$,得到 $\mathbf{H}_{西安} = [-1.182, -0.043, 1.471, -0.078]$。
2.2 举例:全部 6 个 token 的残差连接
残差不是只加一行——矩阵的每一行都做同样的事。全部 6 个 token 的残差连接对比(逐行手算验证),如图 8-3 所示。
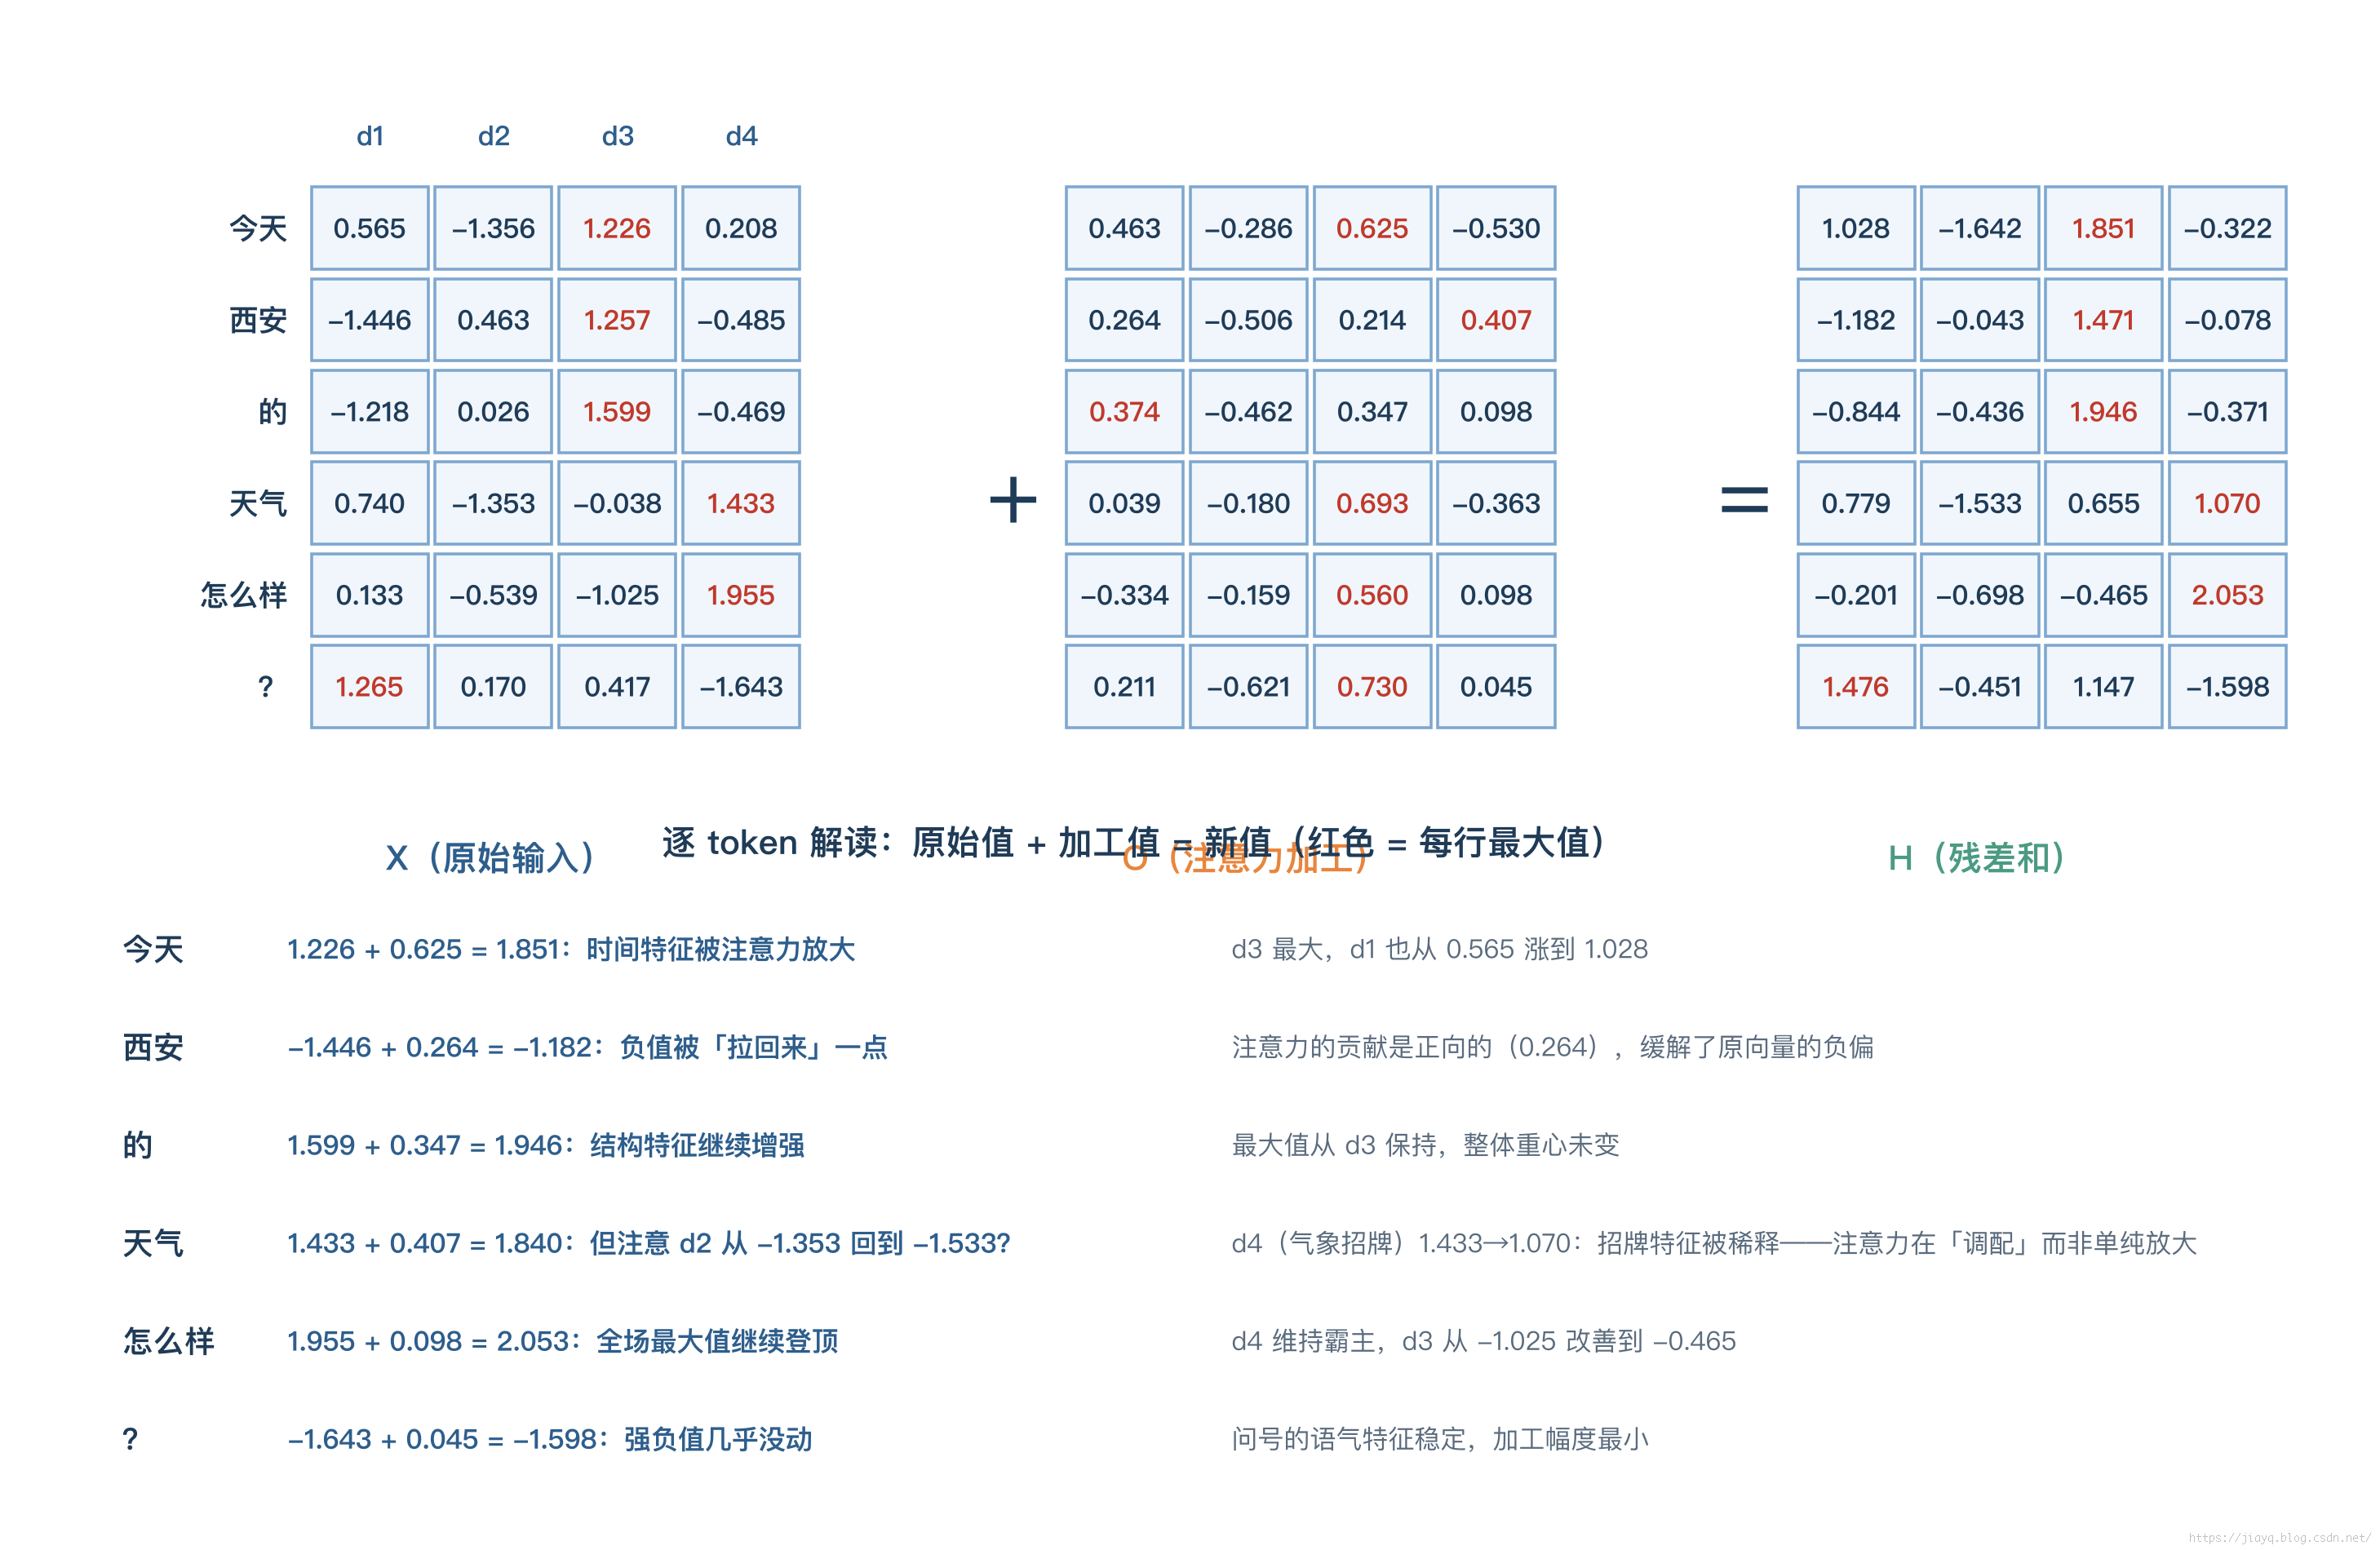
图8-3 全部 6 个 token 的残差连接:逐行解读(红色 = 每行最大值)
几个值得注意的细节:
- 「西安」的 d1 从 -1.446 回到 -1.182:原向量的负偏被注意力的正向贡献(+0.264)拉回来一点——残差是”微调”而不是”重写”
- 「天气」的 d4 从 1.433 降到 1.070:招牌特征反而被稀释了——注意力的角色是”调配”,不是单纯放大
- 「怎么样」的 d4 从 1.955 涨到 2.053:全场最大值继续登顶
- 「?」的 d4 几乎没动(-1.643 → -1.598):问号的语气特征很稳定,加工幅度最小
残差的语义:每个词的新向量 = 自己原来的样子 + 从上下文吸收的信息。变化幅度因词而异——这正是”加工”应有的样子。
2.3 作用:梯度高速路
残差看似只是加了一下,为什么所有深网络都离不开它?关键在训练时的梯度回传,如图 8-4 所示。
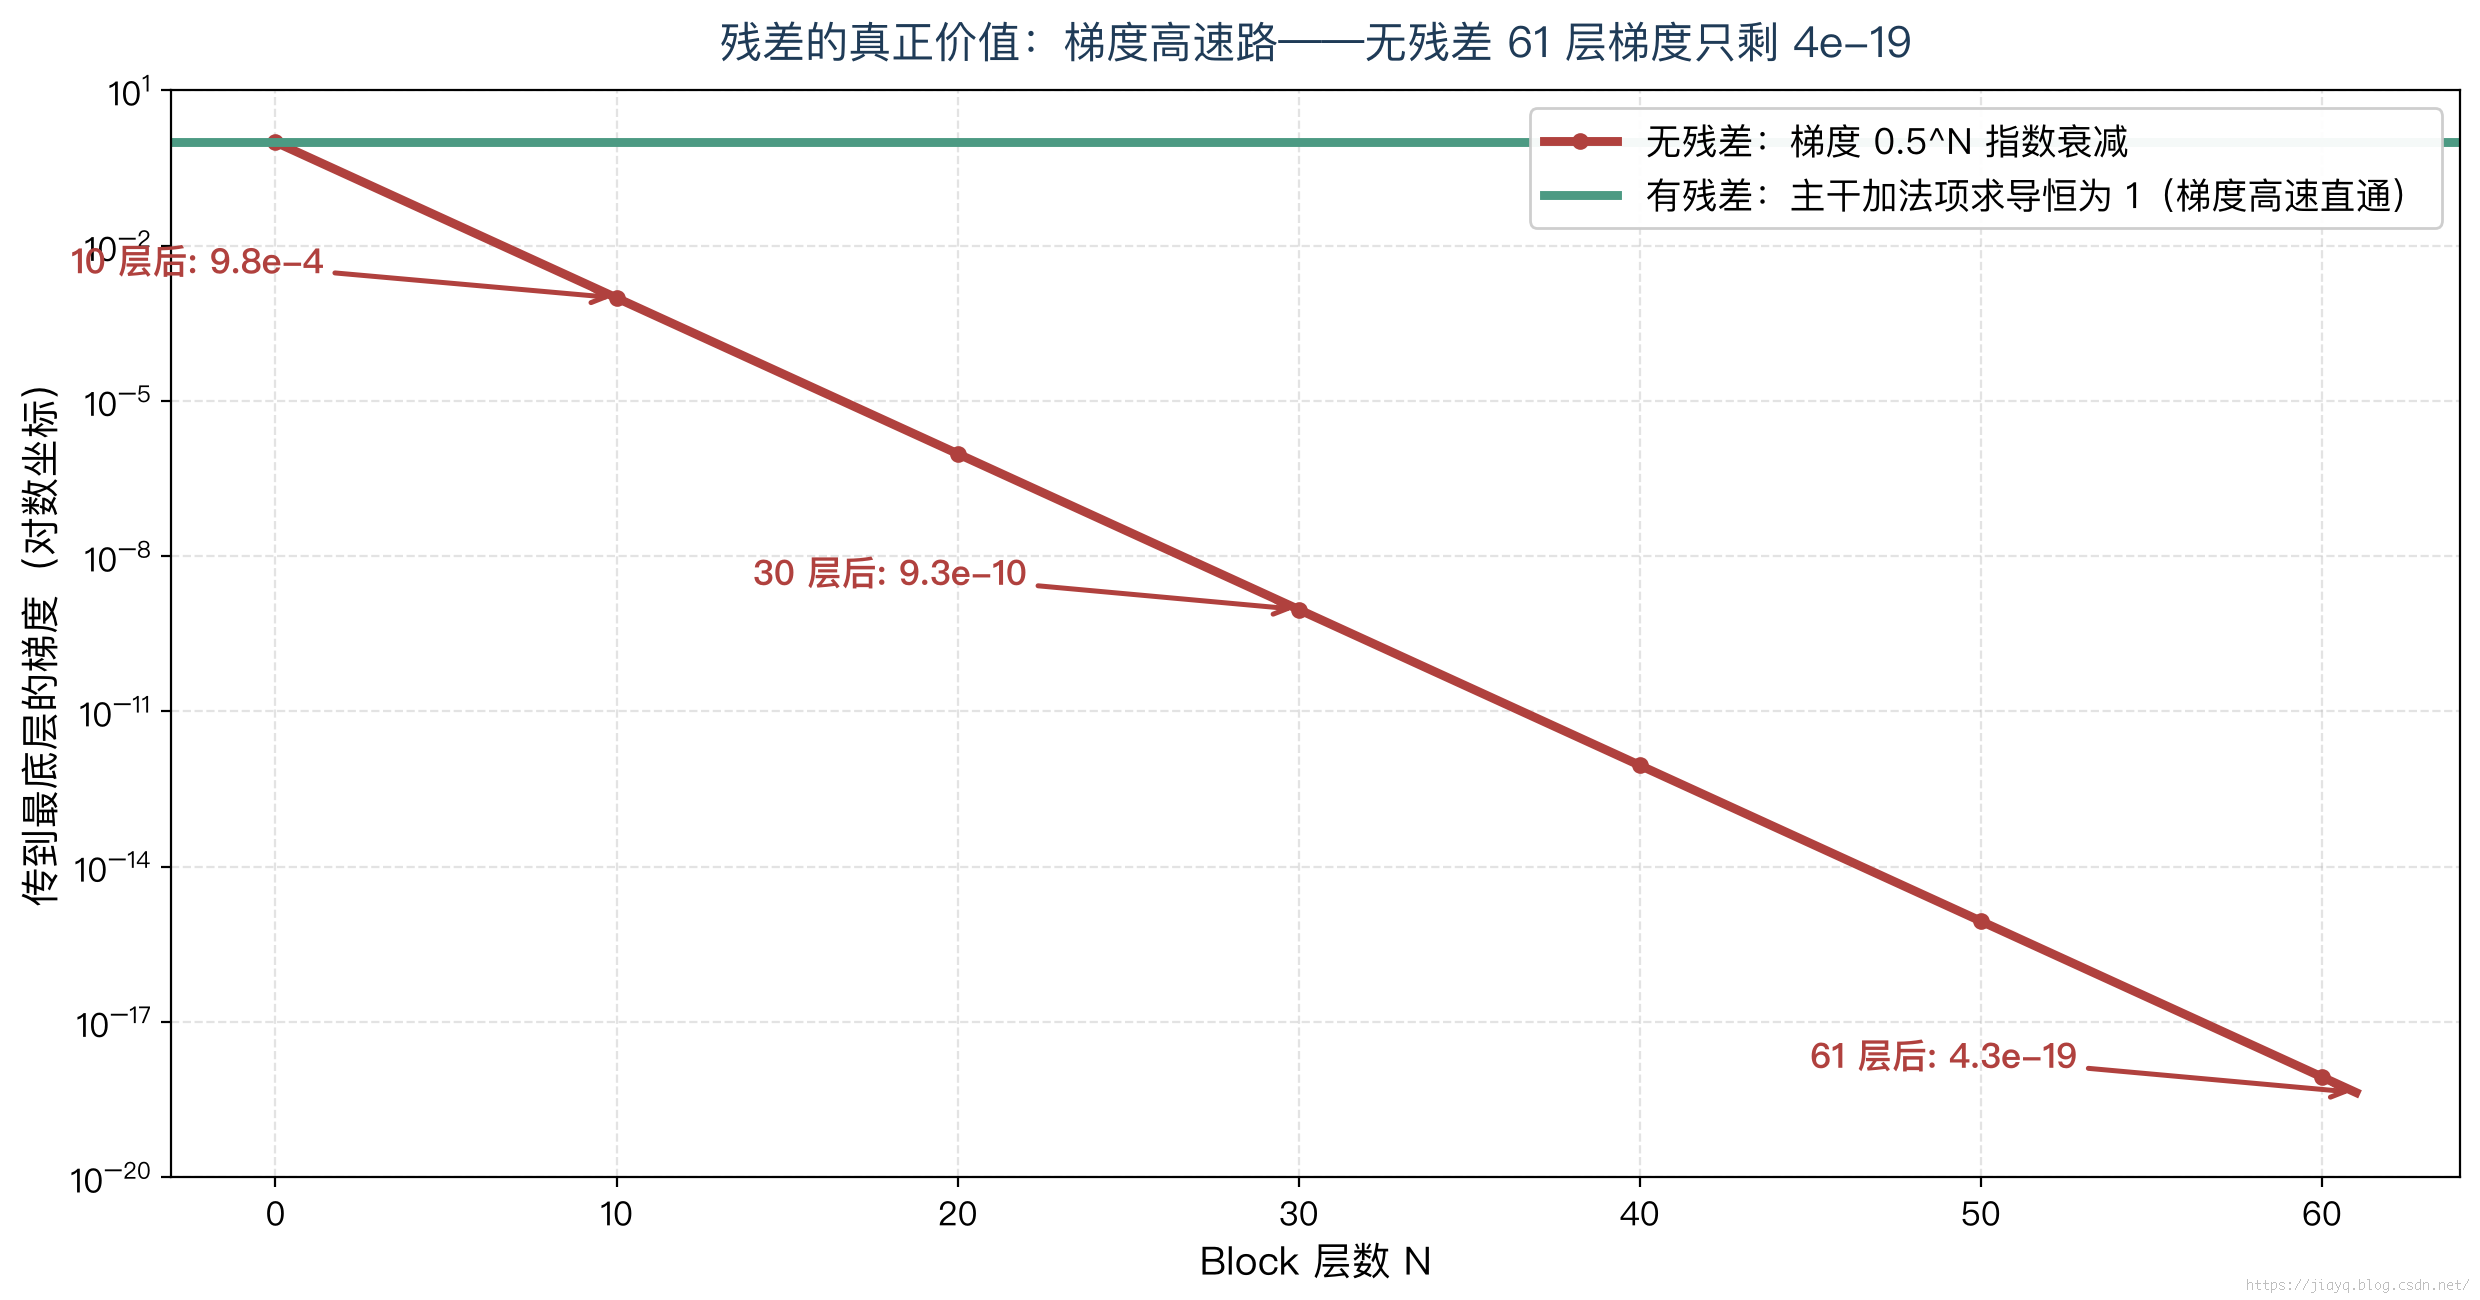
图8-4 残差的真正价值:梯度高速路
没有残差时,梯度要穿过每层的加工函数回传,每层都被乘上一个小于 1 的系数(举例:假设每层保留一半,0.5):
- 举例 1:10 层网络 → $0.5^{10} \approx 0.001$,底层只收到千分之一的信号
- 举例 2:61 层(DeepSeek-V3 的深度)→ $0.5^{61} \approx 4 \times 10^{-19}$——梯度完全消失,底层几亿个参数集体”失聪”,训练无从谈起
有了残差,$\mathbf{H} = \mathbf{X} + f(\mathbf{X})$ 里的 $\mathbf{X}$ 是直通项——对它求导恒等于 1,梯度沿这条加法主干一路高速直达底层,不管多少层都不衰减。
出处:这个思想来自 ResNet(Residual Network)——He Kaiming(何恺明)等人 2015 年的论文《Deep Residual Learning for Image Recognition》(CVPR 2016),为解决”网络越深反而越难训”的问题提出。它是计算机视觉史乃至整个深度学习史引用量最高的论文之一(超过 20 万次),Transformers 的残差设计直接继承于此。2024 年何恺明因这一工作获得 IEEE 计算机学会先驱奖。
附带的好处:即使某一层 $f$ 学废了(输出全 0),残差保证 $\mathbf{H} = \mathbf{X}$——信息至少不比原来差,深层网络不会因为个别层拉胯而全盘崩溃。
3. FFN 三段式:升维 → 激活 → 降维
3.1 流程与为什么要升维
FFN 的结构是个”先膨胀再收缩”的三段式,如图 8-5 所示。
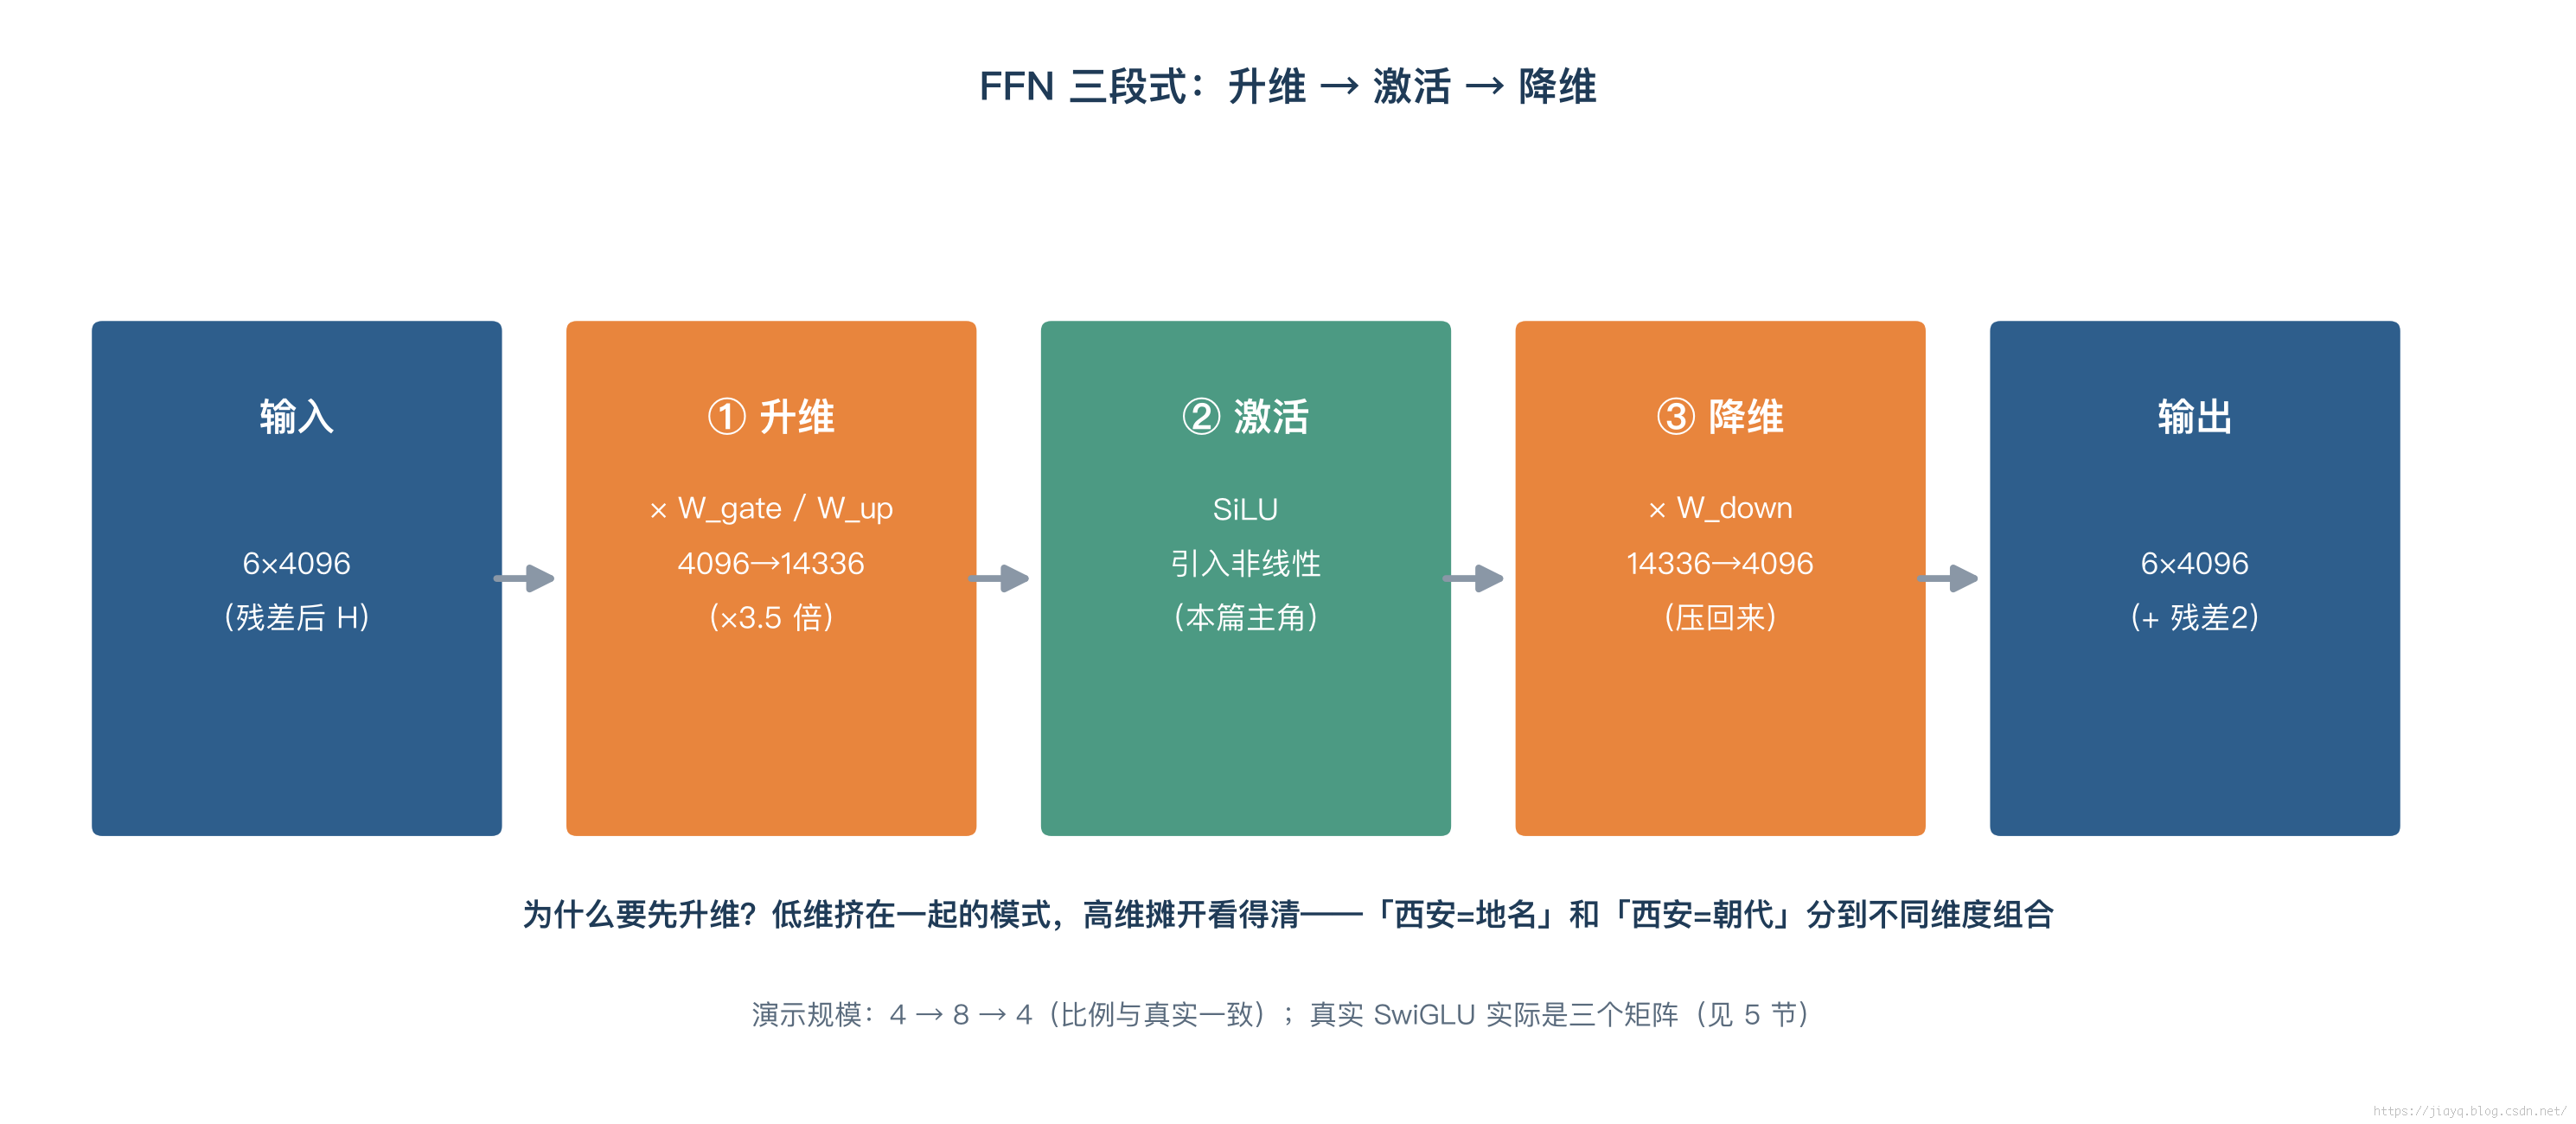
图8-5 FFN 三段式:升维 → 激活 → 降维(大字号版)
\[\text{FFN}(\mathbf{x}) = \text{SiLU}(\mathbf{x} \cdot \mathbf{W}_{up}) \cdot \mathbf{W}_{down}\]- 升维:乘 $\mathbf{W}_{up}$(4096×14336),一行 4096 个数展开成 14336 个——为什么要升:低维挤在一起的模式,高维摊开看得清。就像把一团揉皱的纸展开——”西安=地名”和”西安=朝代”这两种特征,在 14336 维的大空间里可以摊到完全不同的维度组合上分别加工
- 激活:逐格过 SiLU 函数(第 4 节专门讲,本篇真正的重头戏)
- 降维:乘 $\mathbf{W}_{down}$(14336×4096),压回 4096 个——为什么再降回来:升维是为了加工,降维是为了交付;下游的 Block 入口只收 4096 维
$\mathbf{W}{up}$ 和 $\mathbf{W}{down}$ 是什么、怎么来的:和篇6 的 $\mathbf{W}_Q$/$\mathbf{W}_K$/$\mathbf{W}_V$ 完全同理——都是训练学出来的权重矩阵(训练前随机初始化,训练中靠梯度下降一点点调整),不是人手工设计的。
3.2 贯穿案例:「西安」行手算
「西安」行完整走一遍三段式(每行最大值红色标注,升维后的 8 个数、激活后的 8 个数都遵守这个约定),如图 8-6 所示。
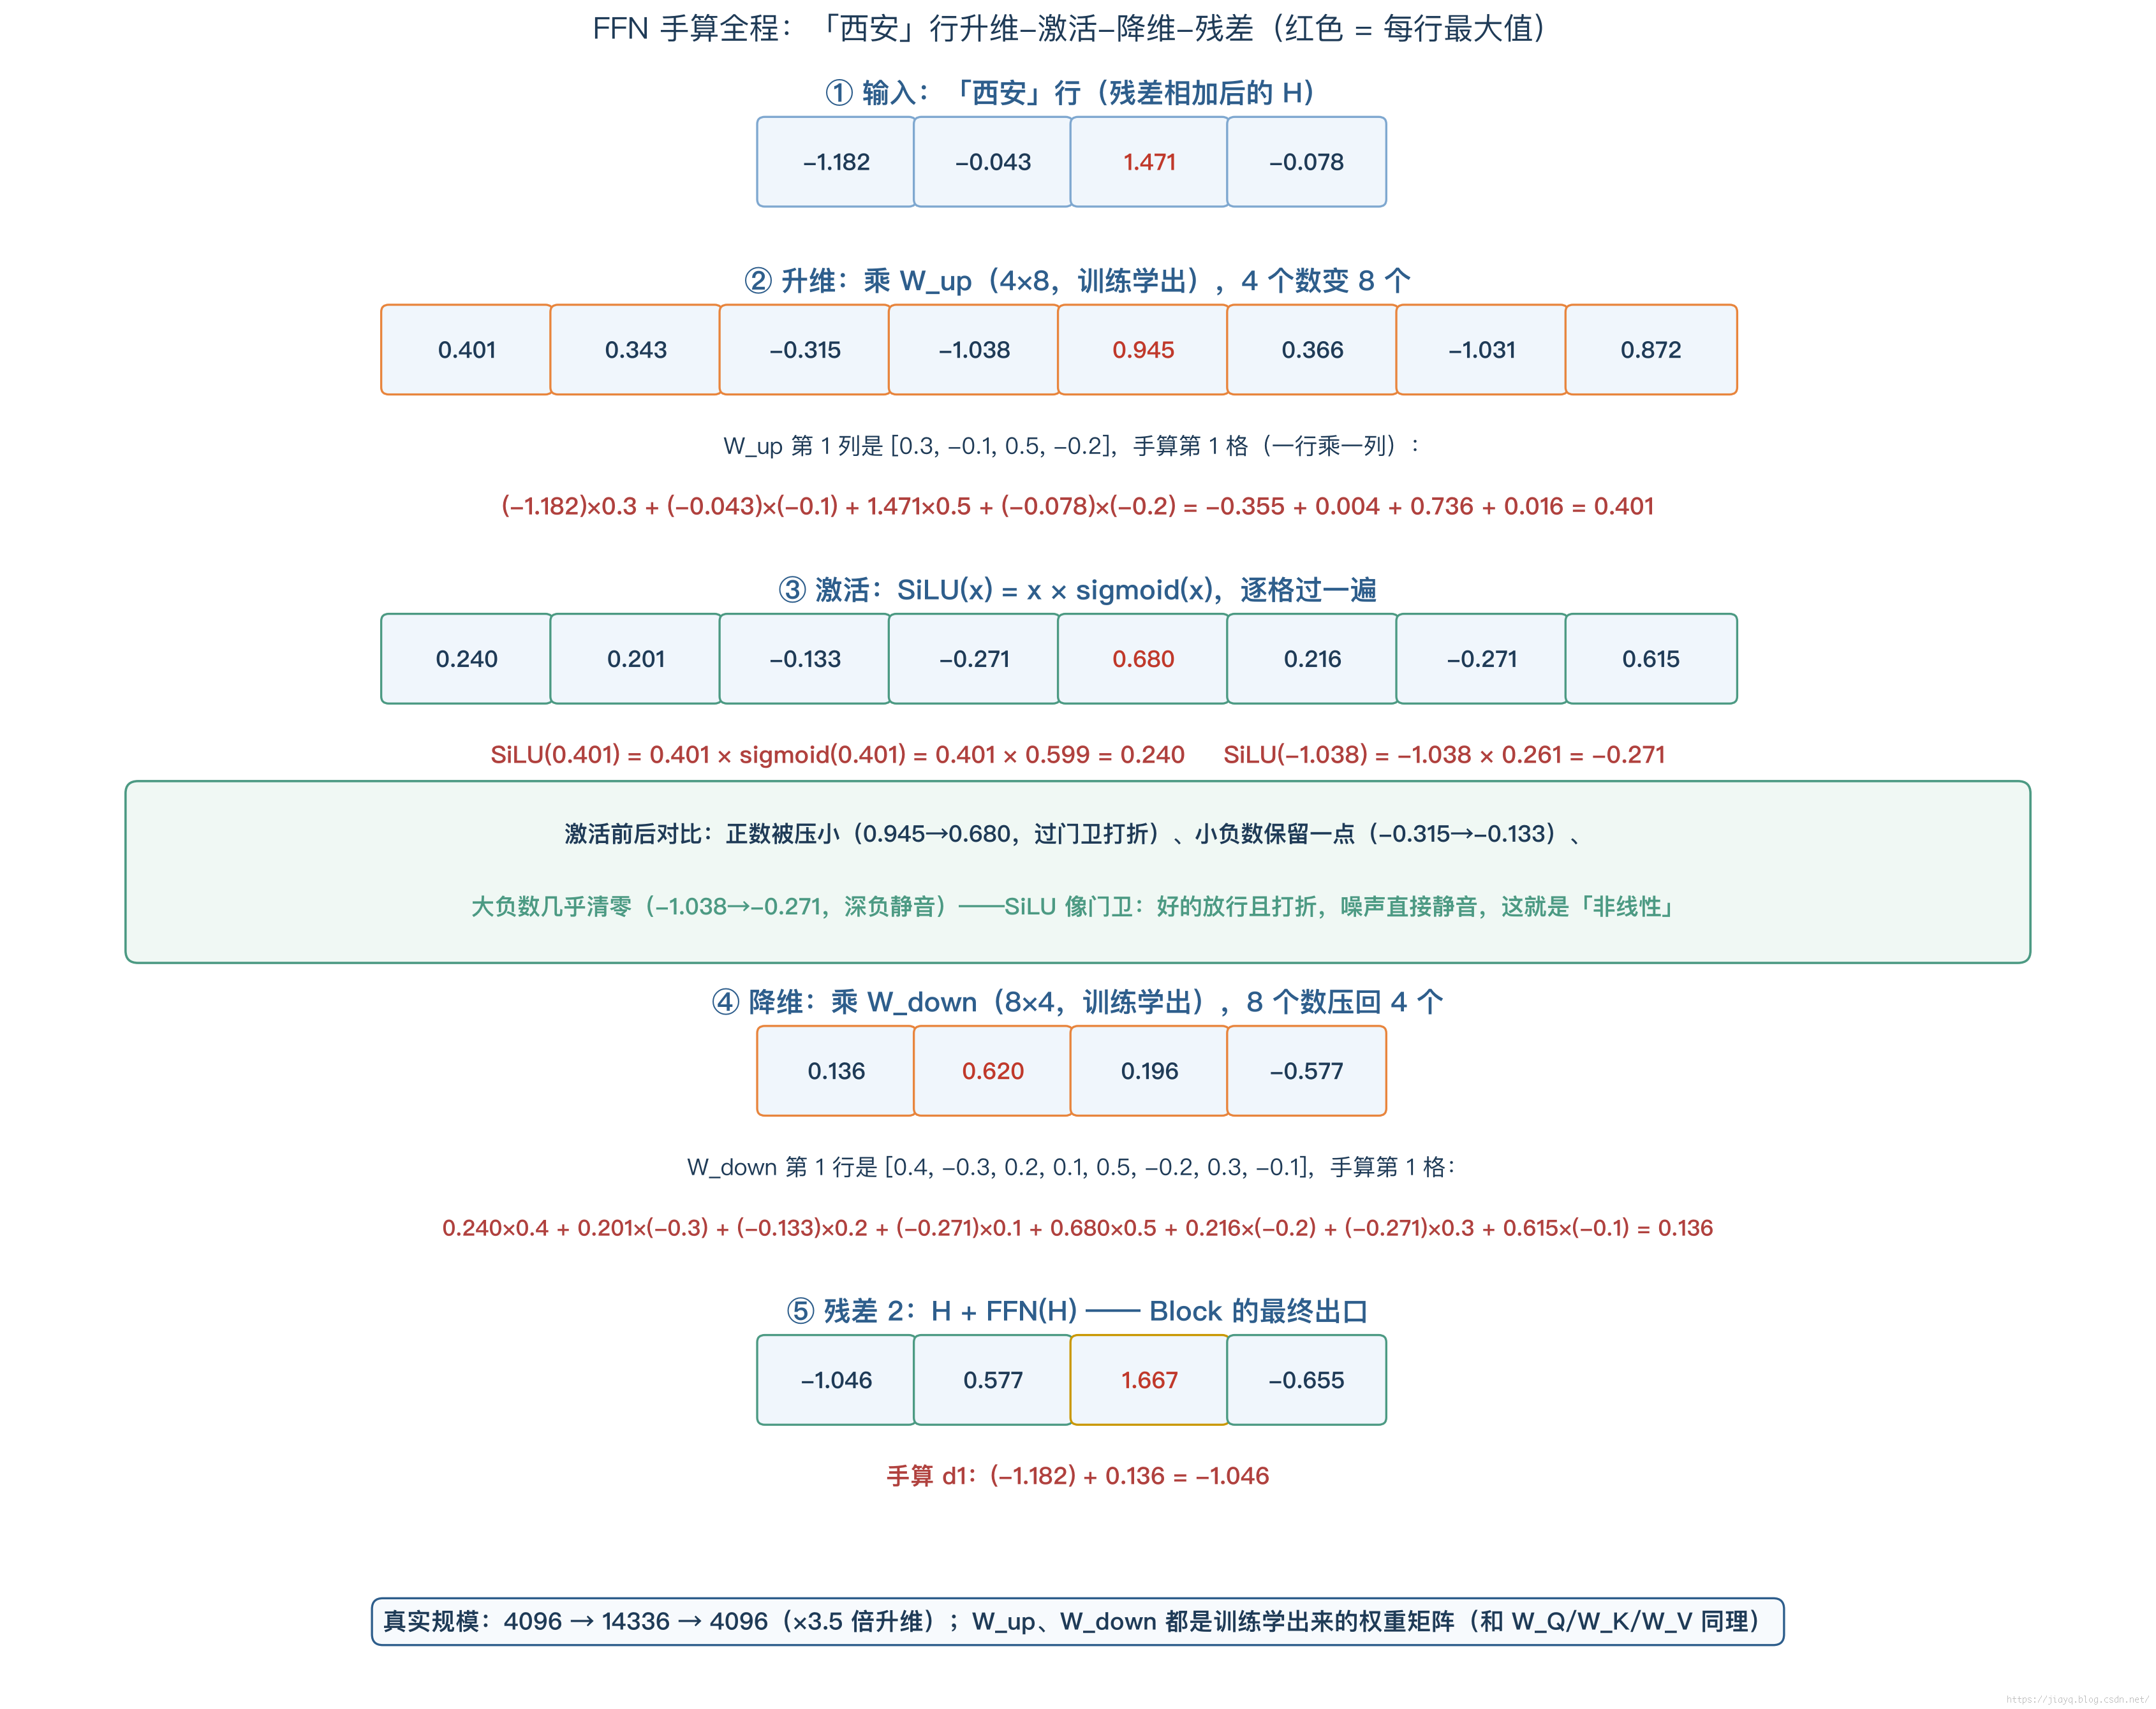
图8-6 FFN 手算全程:升维-激活-降维-残差(红色 = 每行最大值)
升维手算($\mathbf{H}{西安}$ 乘 $\mathbf{W}{up}$ 第 1 列 $[0.3, -0.1, 0.5, -0.2]$,还是一行乘一列):
\[(-1.182) \times 0.3 + (-0.043) \times (-0.1) + 1.471 \times 0.5 + (-0.078) \times (-0.2) = 0.401\]升维后 8 个数:$[\textcolor{red}{0.401}, 0.343, -0.315, -1.038, \textcolor{red}{0.945}, 0.366, -1.031, 0.872]$(红标最大 0.945,演示图里统一处理)。
降维手算(激活后的 8 个数乘 $\mathbf{W}_{down}$ 第 1 行):
\[0.240 \times 0.4 + 0.201 \times (-0.3) + \cdots + 0.615 \times (-0.1) = 0.136\]残差 2:$(-1.182) + 0.136 = -1.046$,最终「西安」的 Block 出口 $[-1.046, \textcolor{red}{0.577}, \textcolor{red}{1.667}, -0.655]$。
3.3 全部 6 个 token 的 Block 出口
每个 token 独立走完三段式再加残差,Block 完整出口如图 8-7 所示。
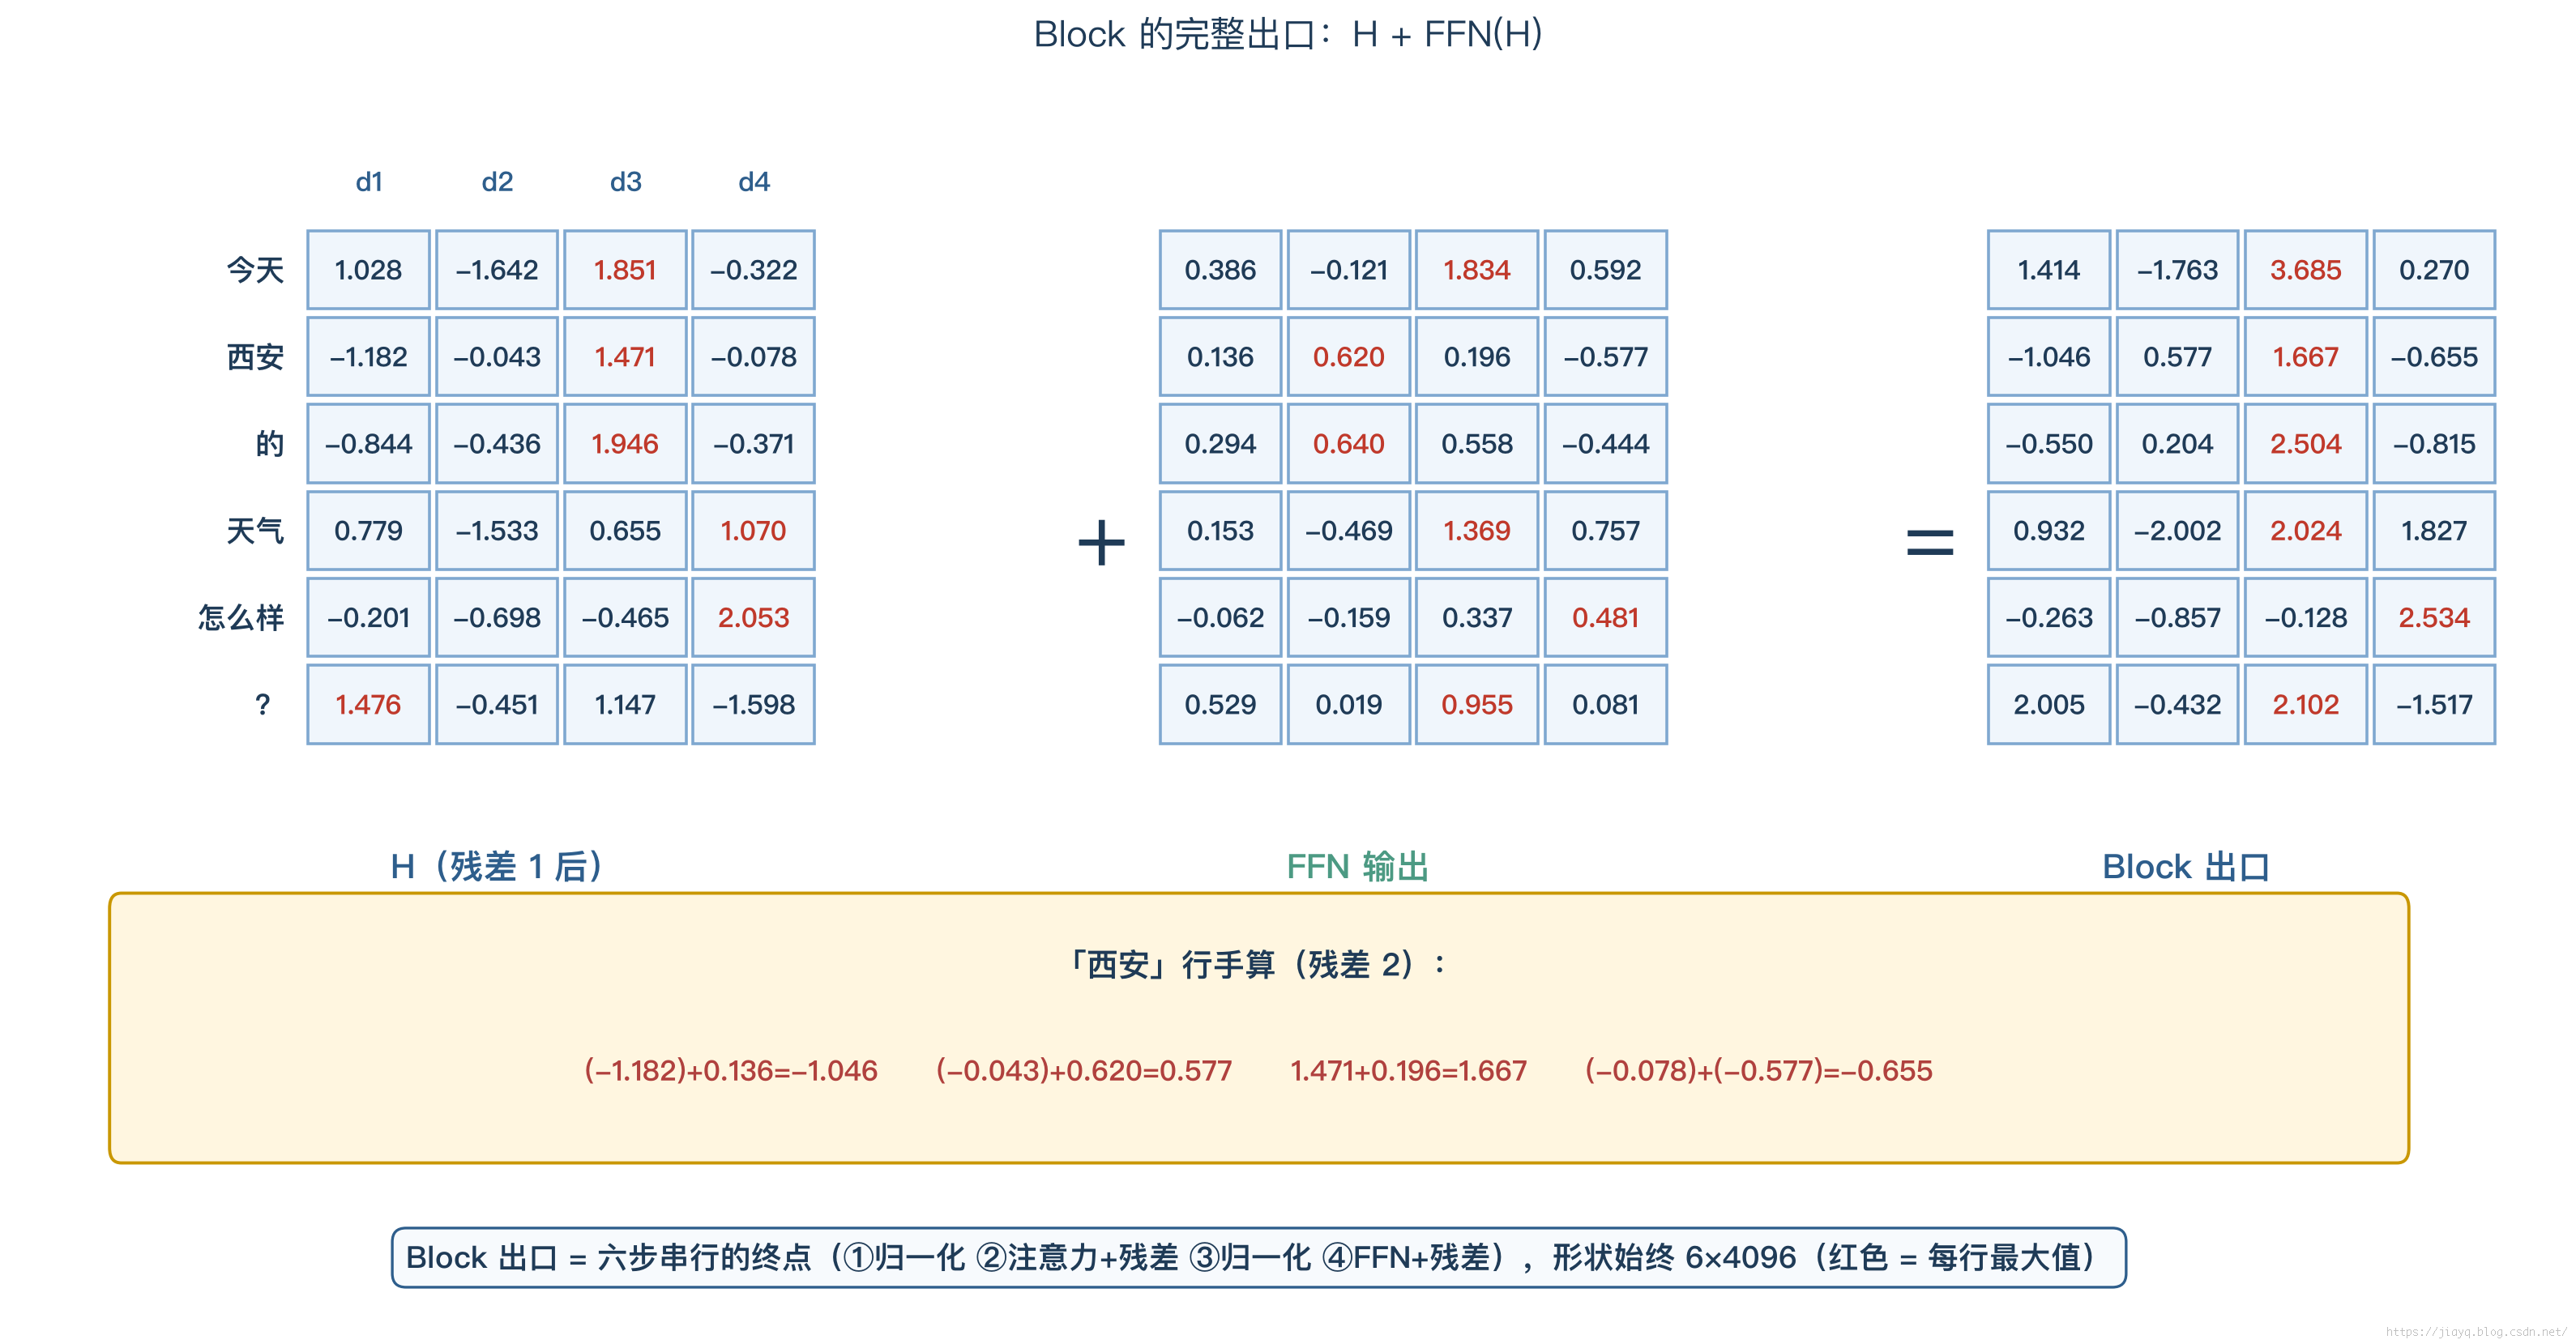
图8-7 Block 的完整出口:H + FFN(H)(红色 = 每行最大值)
到这一步,Block 六步串行全部走完:①归一化 → ②注意力 → +残差 → ③归一化 → ④FFN → +残差。出口形状还是 6×4096,但每个词都已混入上下文信息(注意力的功劳),又各自完成深度加工(FFN 的功劳)。
4. 激活函数:网络里唯一的”掰弯”零件
前面铺垫了这么久,现在正式讲本篇真正的重点。很多读者到这里可能还是云里雾里:”激活函数到底是个啥?为什么非要它不可?”
4.1 一个直观的例子:为什么没有它不行
先看一个具体问题,如图 8-8 所示。
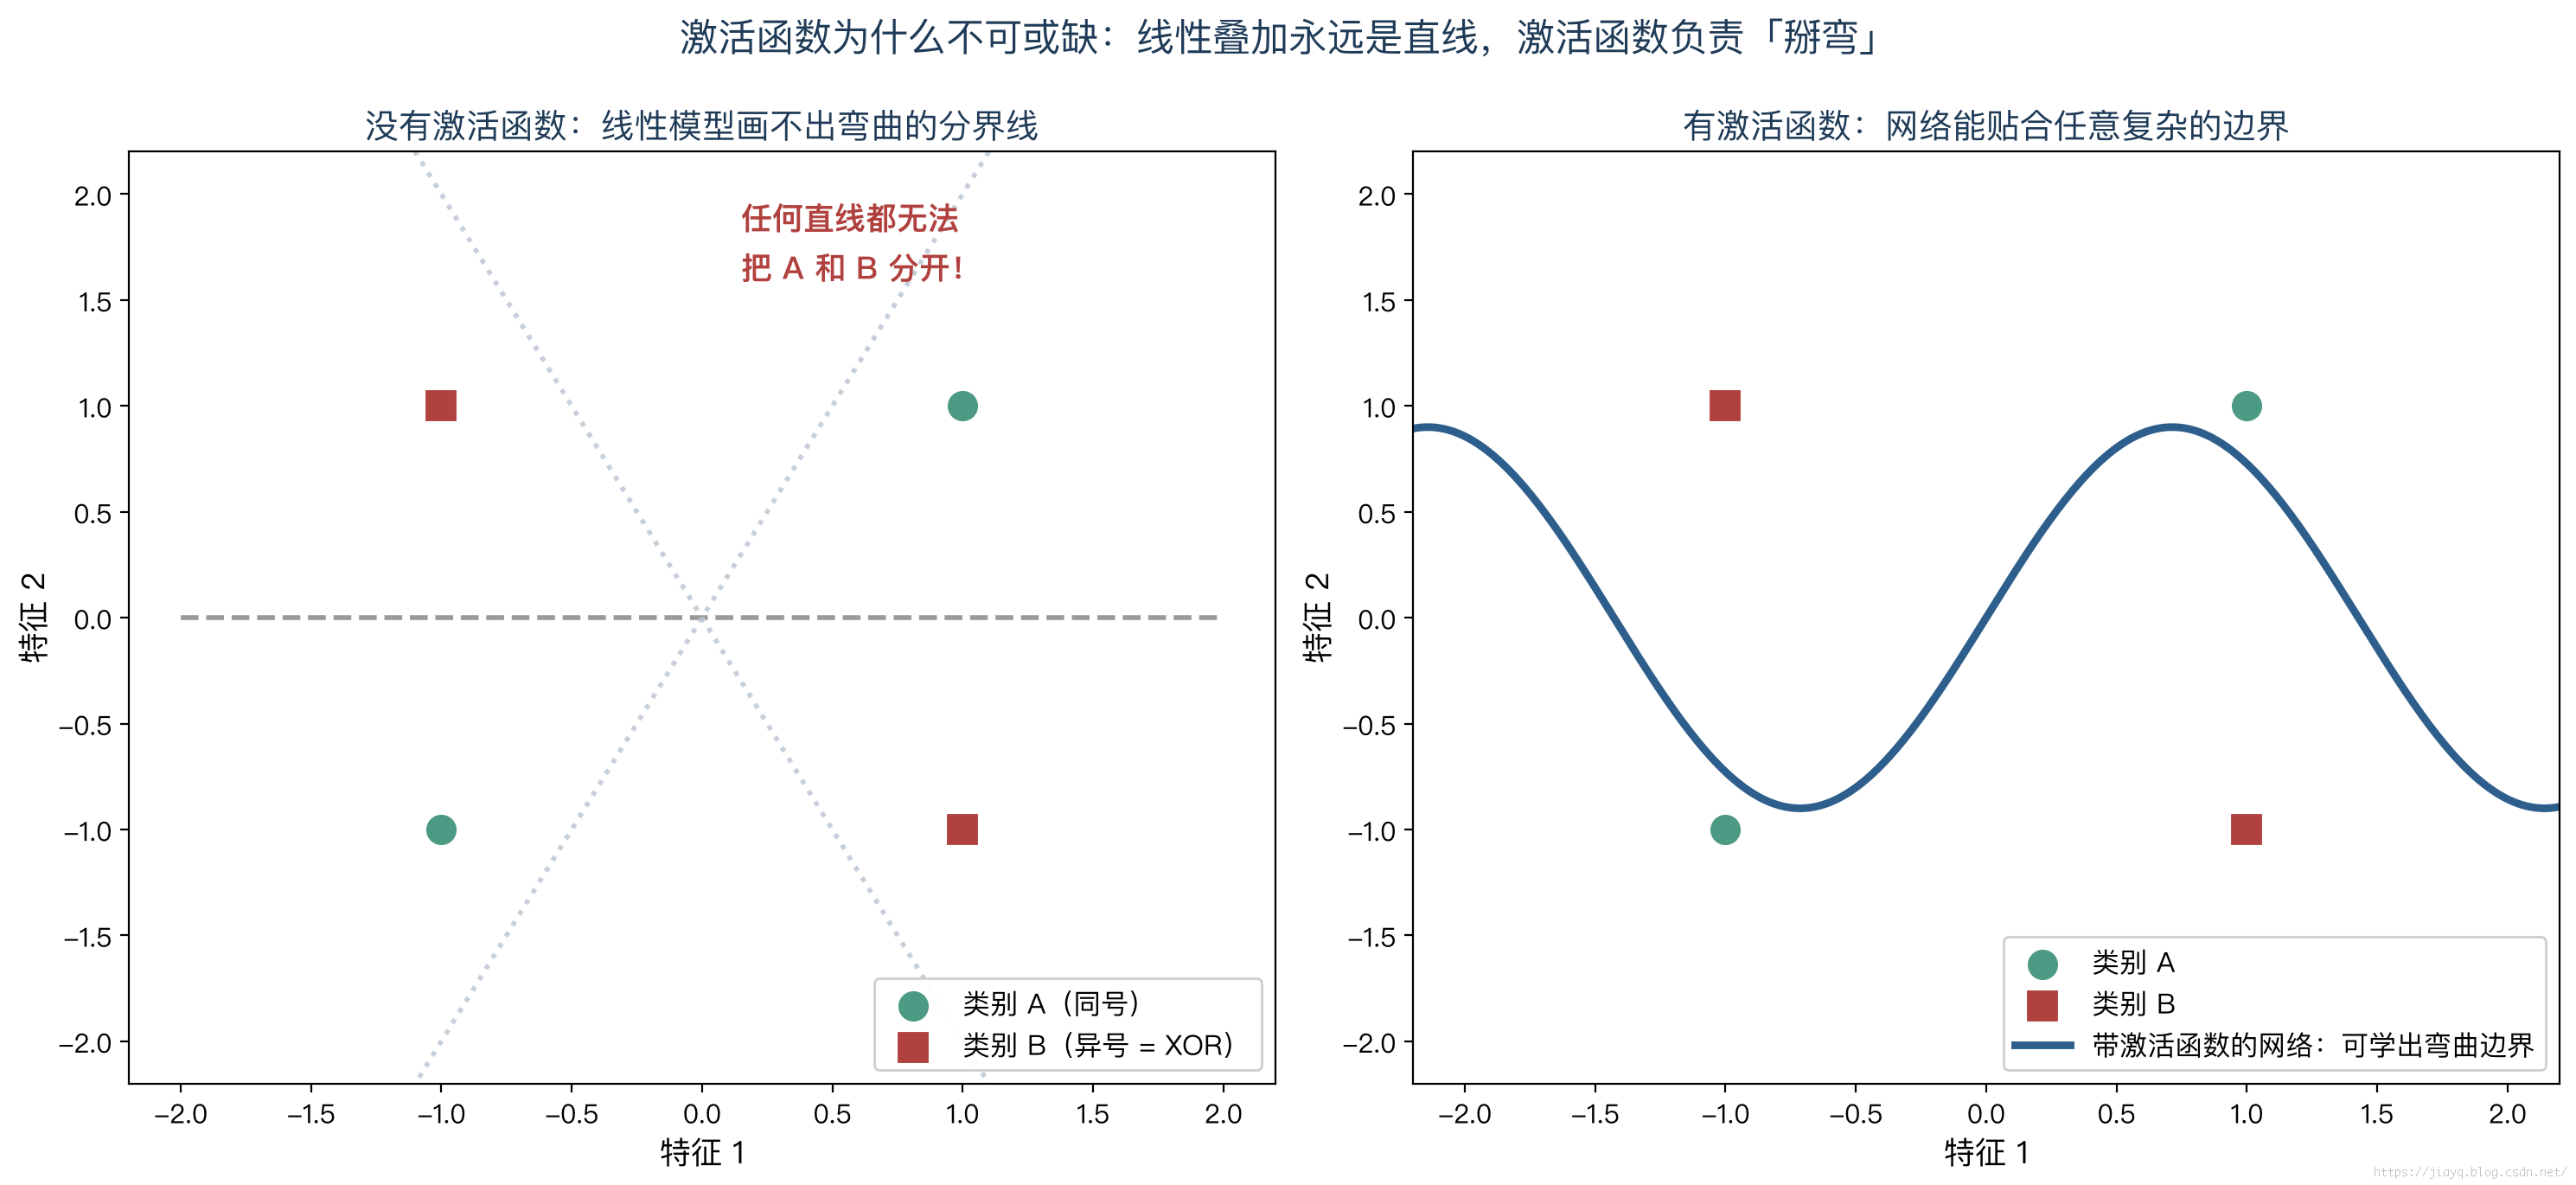
图8-8 激活函数为什么不可或缺:左图无解,右图有解
图上有两类点:绿色圆点是”同号”(x 和 y 正负号相同),红色方块是”异号”。要把绿点和红点分开——这就是著名的 XOR(异或)问题。
- 左图(没有激活函数):模型能做的只有线性变换(旋转、拉伸、平移),画出来的分界线永远是直线。而你看图:不存在任何一条直线能把这两类点分开——无论怎么摆,直线两侧总是绿红混杂。数学上可以严格证明:$\mathbf{W}_2(\mathbf{W}_1\mathbf{x}) = (\mathbf{W}_2\mathbf{W}_1)\mathbf{x}$——两层线性叠加等价于一层,一百层也一样。线性模型连 XOR 都解决不了,遑论理解语言
- 右图(有激活函数):每层之间插入一个非线性函数,直线可以被”掰弯”——带激活函数的深度网络理论上可以贴合任意复杂的弯曲边界(这叫万能逼近定理,1989 年 Cybenko、Hornik 等人分别证明)
一句话定义:激活函数是对每个数字独立做的一次非线性变换——输入一个数,按固定公式输出另一个数。它不训练、不学习(公式是死的),但它引入的”弯”让层层叠加有了意义。
4.2 SiLU:当前主流的激活函数
现代大模型(LLaMA/Qwen/GLM/DeepSeek 全系)用的是 SiLU(Sigmoid Linear Unit,也叫 Swish):
\[\text{SiLU}(x) = x \times \text{sigmoid}(x) = \frac{x}{1 + e^{-x}}\]逐格计算:输入一个数 x,先算 sigmoid(x)(把任意数压到 0~1 之间),再乘回 x。举个具体例子建立直觉:
| 输入 x | sigmoid(x) | SiLU = x×sigmoid(x) | 发生了什么 |
|---|---|---|---|
| 4.0 | 0.982 | 3.93 | 大正数:几乎原样放行 |
| 1.0 | 0.731 | 0.731 | 中等正数:打七折放行 |
| 0.4 | 0.599 | 0.240 | 小正数:打六折放行 |
| -0.3 | 0.426 | -0.128 | 小负数:保留一点(不全杀) |
| -1.0 | 0.269 | -0.269 | 负数:缩小到约四分之一 |
| -4.0 | 0.018 | -0.072 | 大负数:几乎清零(静音) |
表8-1 SiLU 逐点计算表:像门卫的三段处置
三代激活函数的演进曲线如图 8-9 所示。
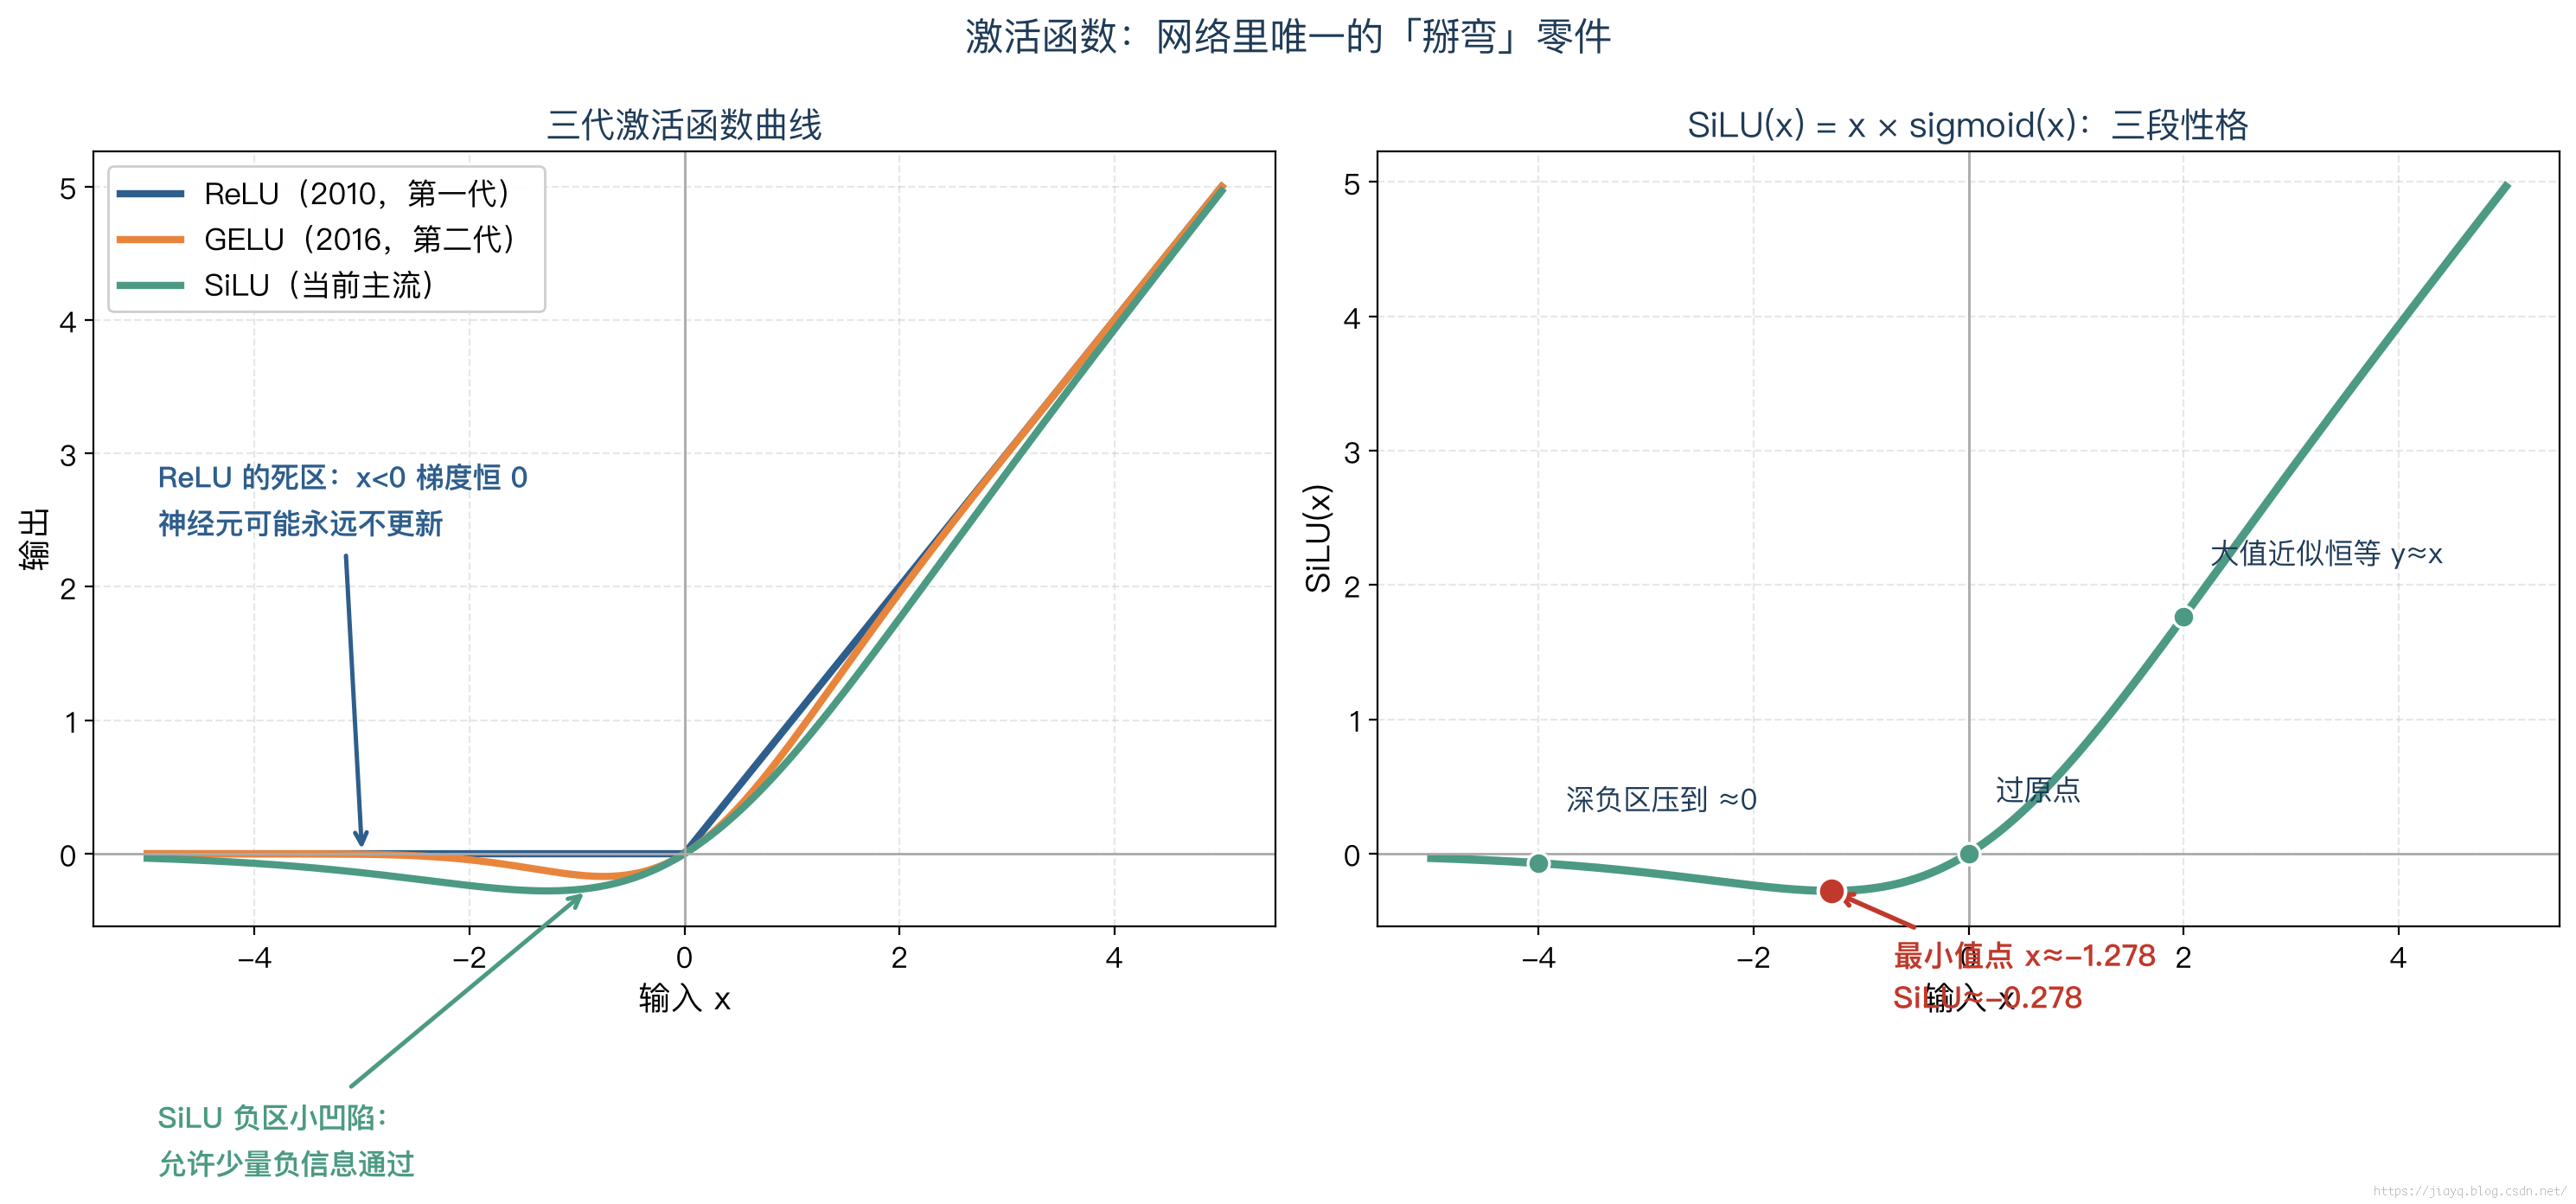
图8-9 三代激活函数:ReLU → GELU → SiLU(右:SiLU 的三段性格)
4.3 激活前后产生了什么变化(贯穿案例解读)
回看「西安」行升维后的 8 个数过 SiLU 的前后对比:
| 升维后 | SiLU 后 | 变化解读 |
|---|---|---|
| 0.401 | 0.240 | 正数打六折——门卫放行但收”过路费” |
| 0.945 | 0.680 | 最大正数打七二折——仍保持最大,但与其他值的差距缩小 |
| -0.315 | -0.133 | 小负数保留 42%——不是所有负信号都该消灭 |
| -1.038 | -0.271 | 大负数砍到 26%——深负区静音 |
| -1.031 | -0.271 | 同上——两个深负值被压到几乎相同 |
表8-2 激活前后对比:SiLU 改变了什么(红色 = 每列最大值)
三个关键变化:
- 数值范围收窄:最大值从 0.945 缩到 0.680,最小值从 -1.038 回到 -0.271——极端值被压向中间,数值更稳
- 大小关系保留:激活前 0.945 > 0.401 > -0.315,激活后 0.680 > 0.240 > -0.133——正区的排序不变,特征的主次保留
- 负区非线性压缩:-0.315 压缩到 42%,-1.038 压缩到 26%——压缩比例随负值深度变化,这是纯线性做不到的(线性只能等比例)
为什么要”门卫”行为:神经网络要学的是”哪些特征重要、哪些是噪声”。SiLU 让重要特征(大正数)近乎无损通过、噪声(深负数)静音、中间地带平滑过渡——下一层的降维矩阵拿到的是”提纯后”的信号。
4.4 怎么训练出来 + 理论支撑
准确地说,激活函数本身不是训练出来的——SiLU 的公式 $\frac{x}{1+e^{-x}}$ 是固定的(自门控设计),训练的是它前后的 $\mathbf{W}{up}$、$\mathbf{W}{down}$。但有两点值得展开:
理论支撑一:万能逼近定理(Universal Approximation Theorem,Cybenko 1989 / Hornik 1991)——只要激活函数是非线性的,单隐层网络理论上就能逼近任意连续函数。它保证了”非线性 + 足够宽”的必要性;深度网络的角色是让”逼近”更高效(同样的函数,深而窄比浅而宽需要的参数少得多)。
理论支撑二:梯度流视角——激活函数处处光滑(SiLU 可导),梯度能顺利流过;ReLU 在 0 点不可导且负区梯度为 0(死区问题),SiLU 的负区小凹陷恰好修复了这一点(少量负梯度通过,死神经元可以被”救活”)。
演进史一句话:sigmoid/tanh(1980s,梯度饱和)→ ReLU(2010,AlexNet 引爆深度学习但死区)→ GELU(2016,BERT/GPT-2 标配,概率软化)→ SiLU/SwiGLU(LLaMA 之后全系标配)——每一代都在”梯度友好”和”表达力”之间找更好的平衡。
4.5 当前主流:SwiGLU
光有 SiLU 还不够。现代大模型实际用的是 SwiGLU 变体:不是”一个矩阵升维 + SiLU”,而是”两个矩阵升维,其中一个过 SiLU 后与另一个逐元素相乘”:
\[\text{FFN}_{SwiGLU}(\mathbf{x}) = \left(\text{SiLU}(\mathbf{x}\mathbf{W}_{gate}) \odot \mathbf{x}\mathbf{W}_{up}\right) \mathbf{W}_{down}\]$\odot$ 表示逐元素相乘。直觉:$\mathbf{W}{up}$ 负责产出”内容”,$\mathbf{W}{gate}$ 过 SiLU 后产出”门控信号”(0~1 的系数)——每个特征自己决定自己通过多少。2020 年 Google 论文《GLU Variants Improve Transformer》实测 SwiGLU 比经典 FFN 略好,从此 LLaMA/Qwen/GLM/DeepSeek 全系采用。代价是多一个矩阵(参数 ×1.5),所以各家把中间维从 4 倍微调到 3.5 倍找补。
5. 各家 FFN 现状
各家 FFN 中间维对比如图 8-10 所示。
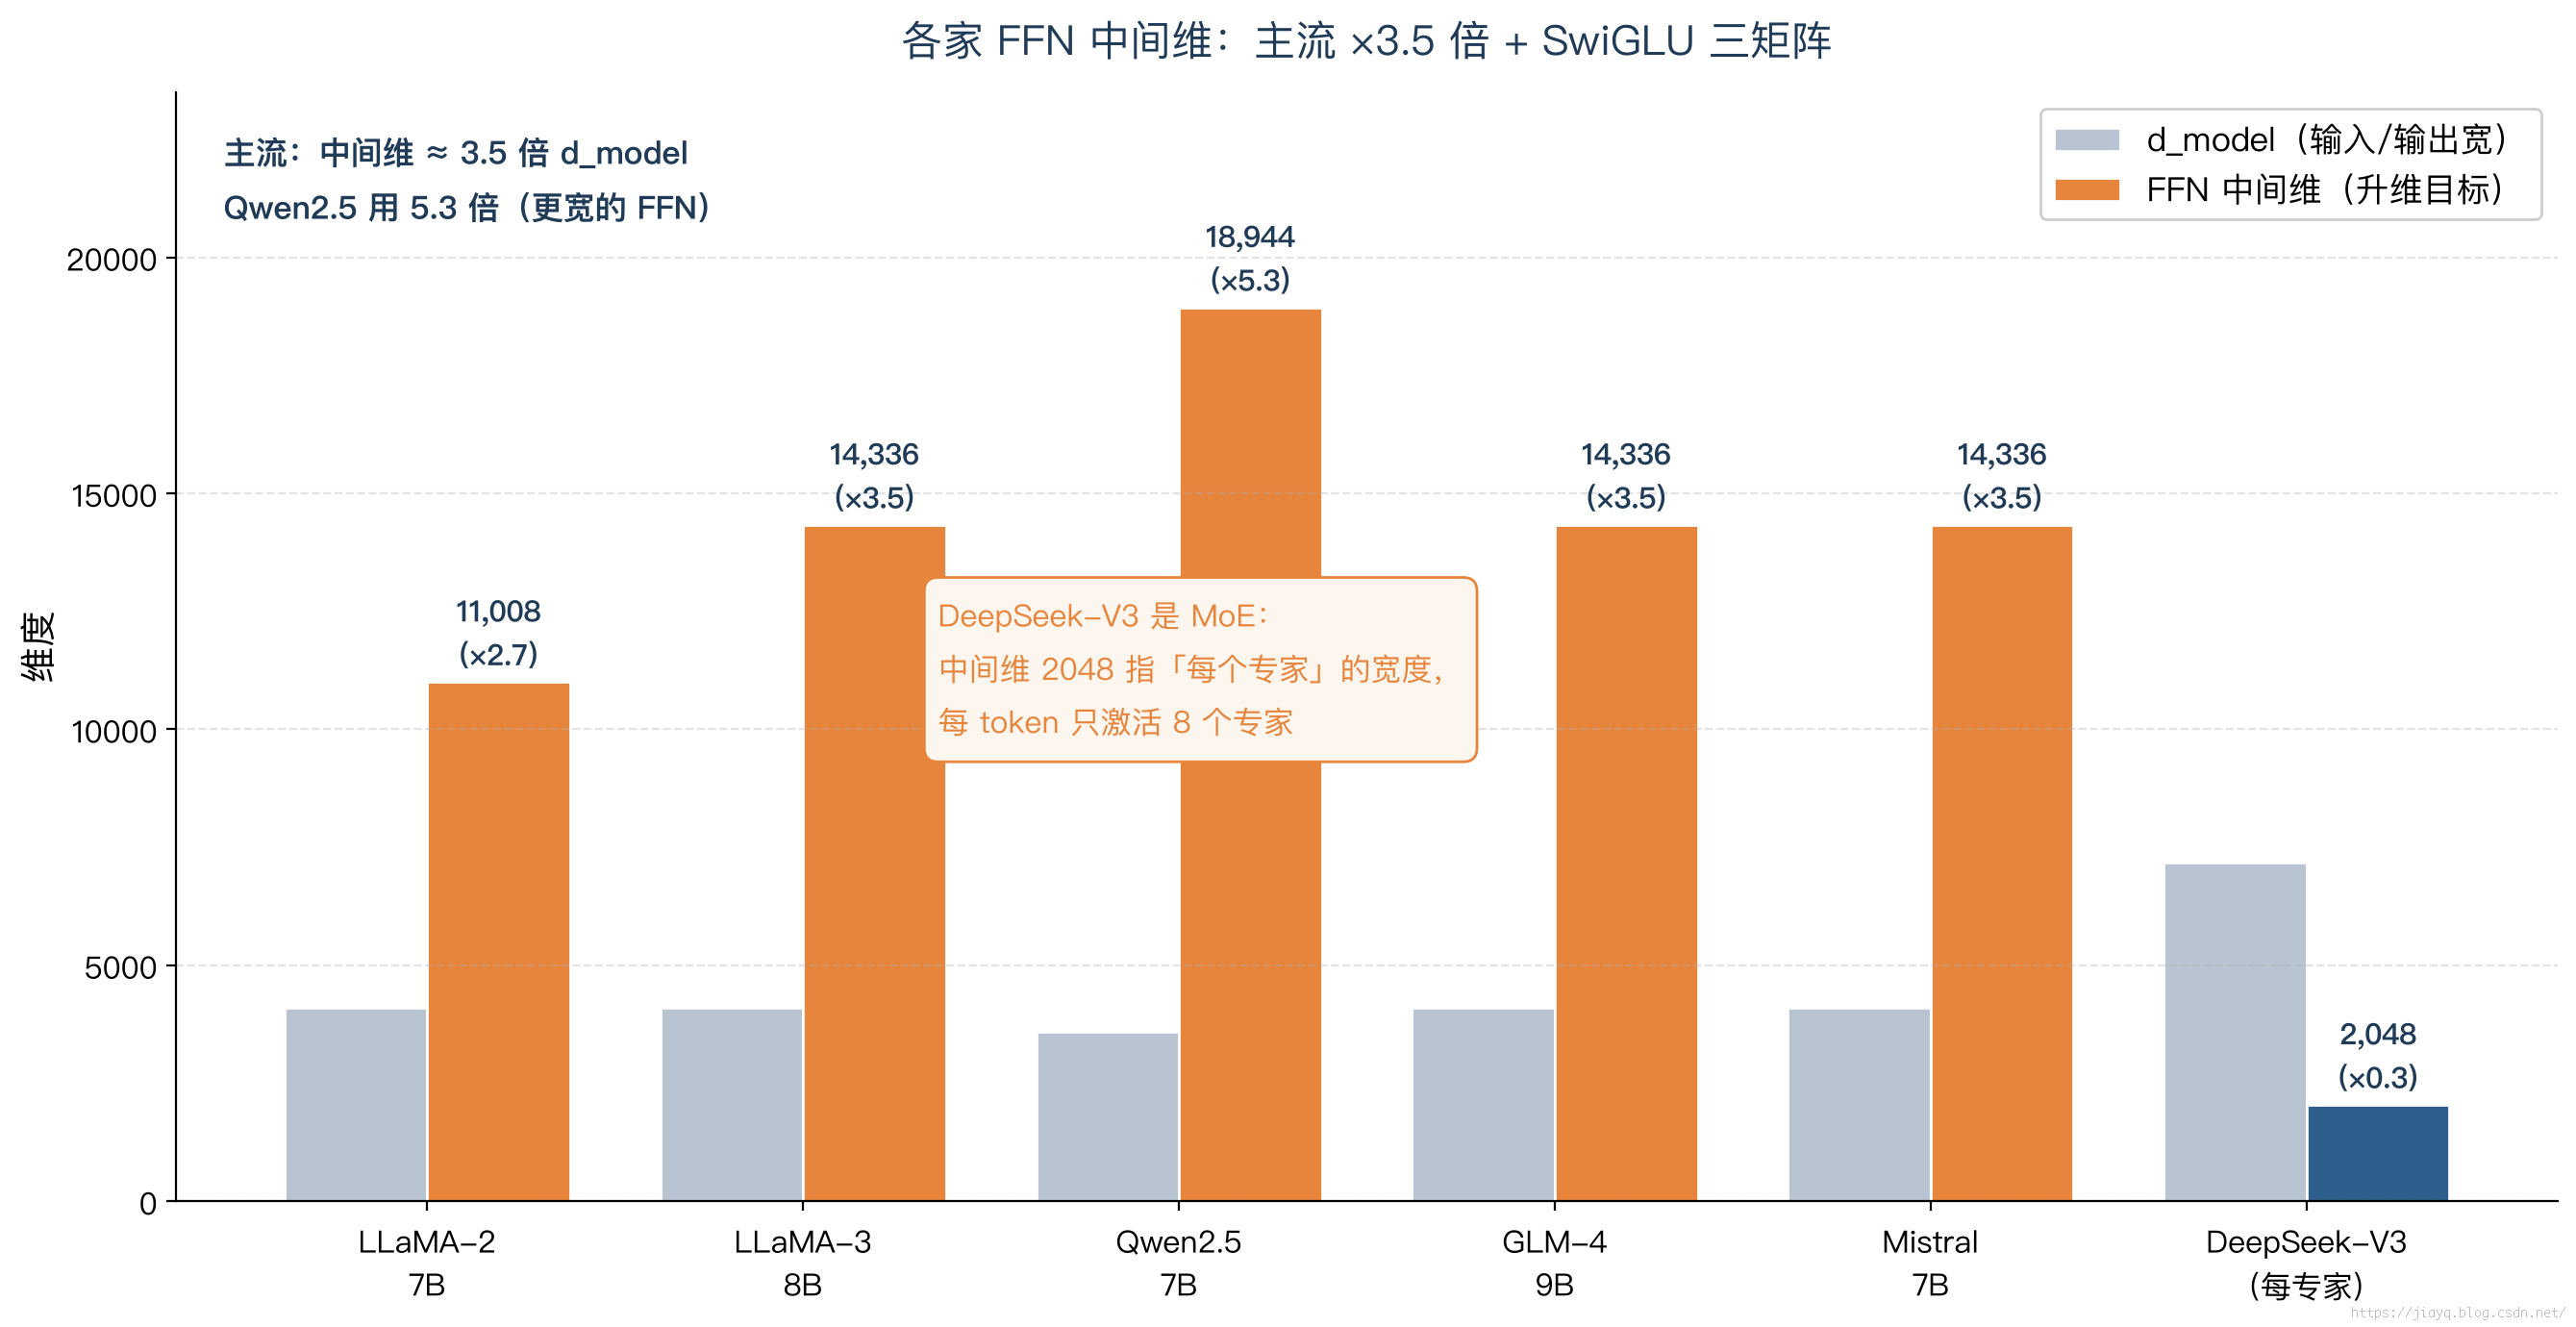
图8-10 各家 FFN 中间维:主流 ×3.5 倍 + SwiGLU 三矩阵
表8-3 各家 FFN 配置
| 模型 | d_model | FFN 中间维 | 倍数 | 激活 |
|---|---|---|---|---|
| LLaMA-2 7B | 4096 | 11,008 | 2.7x | SwiGLU |
| LLaMA-3 8B | 4096 | 14,336 | 3.5x | SwiGLU |
| Qwen2.5 7B | 3584 | 18,944 | 5.3x | SwiGLU |
| GLM-4 9B | 4096 | 14,336 | 3.5x | SwiGLU |
| Mistral 7B | 4096 | 14,336 | 3.5x | SwiGLU |
| DeepSeek-V3 | 7168 | 2,048/专家 | MoE(每 token 激活 8 个专家) | SwiGLU |
DeepSeek-V3 的 MoE 是另一种思路:256 个小专家 FFN,每个 token 只激活 8 个——总参数巨大但单次计算量小(呼应篇1 的 Seed-1.6:230B 总参数、23B 激活,正是这种架构)。
6. 参数加总账:从 1 加回到 75 亿
呼应篇1 的思想实验——当时把 230B 砍到 1 个参数,现在逐篇加回来,看看到了篇8 攒了多少,如图 8-11 所示。
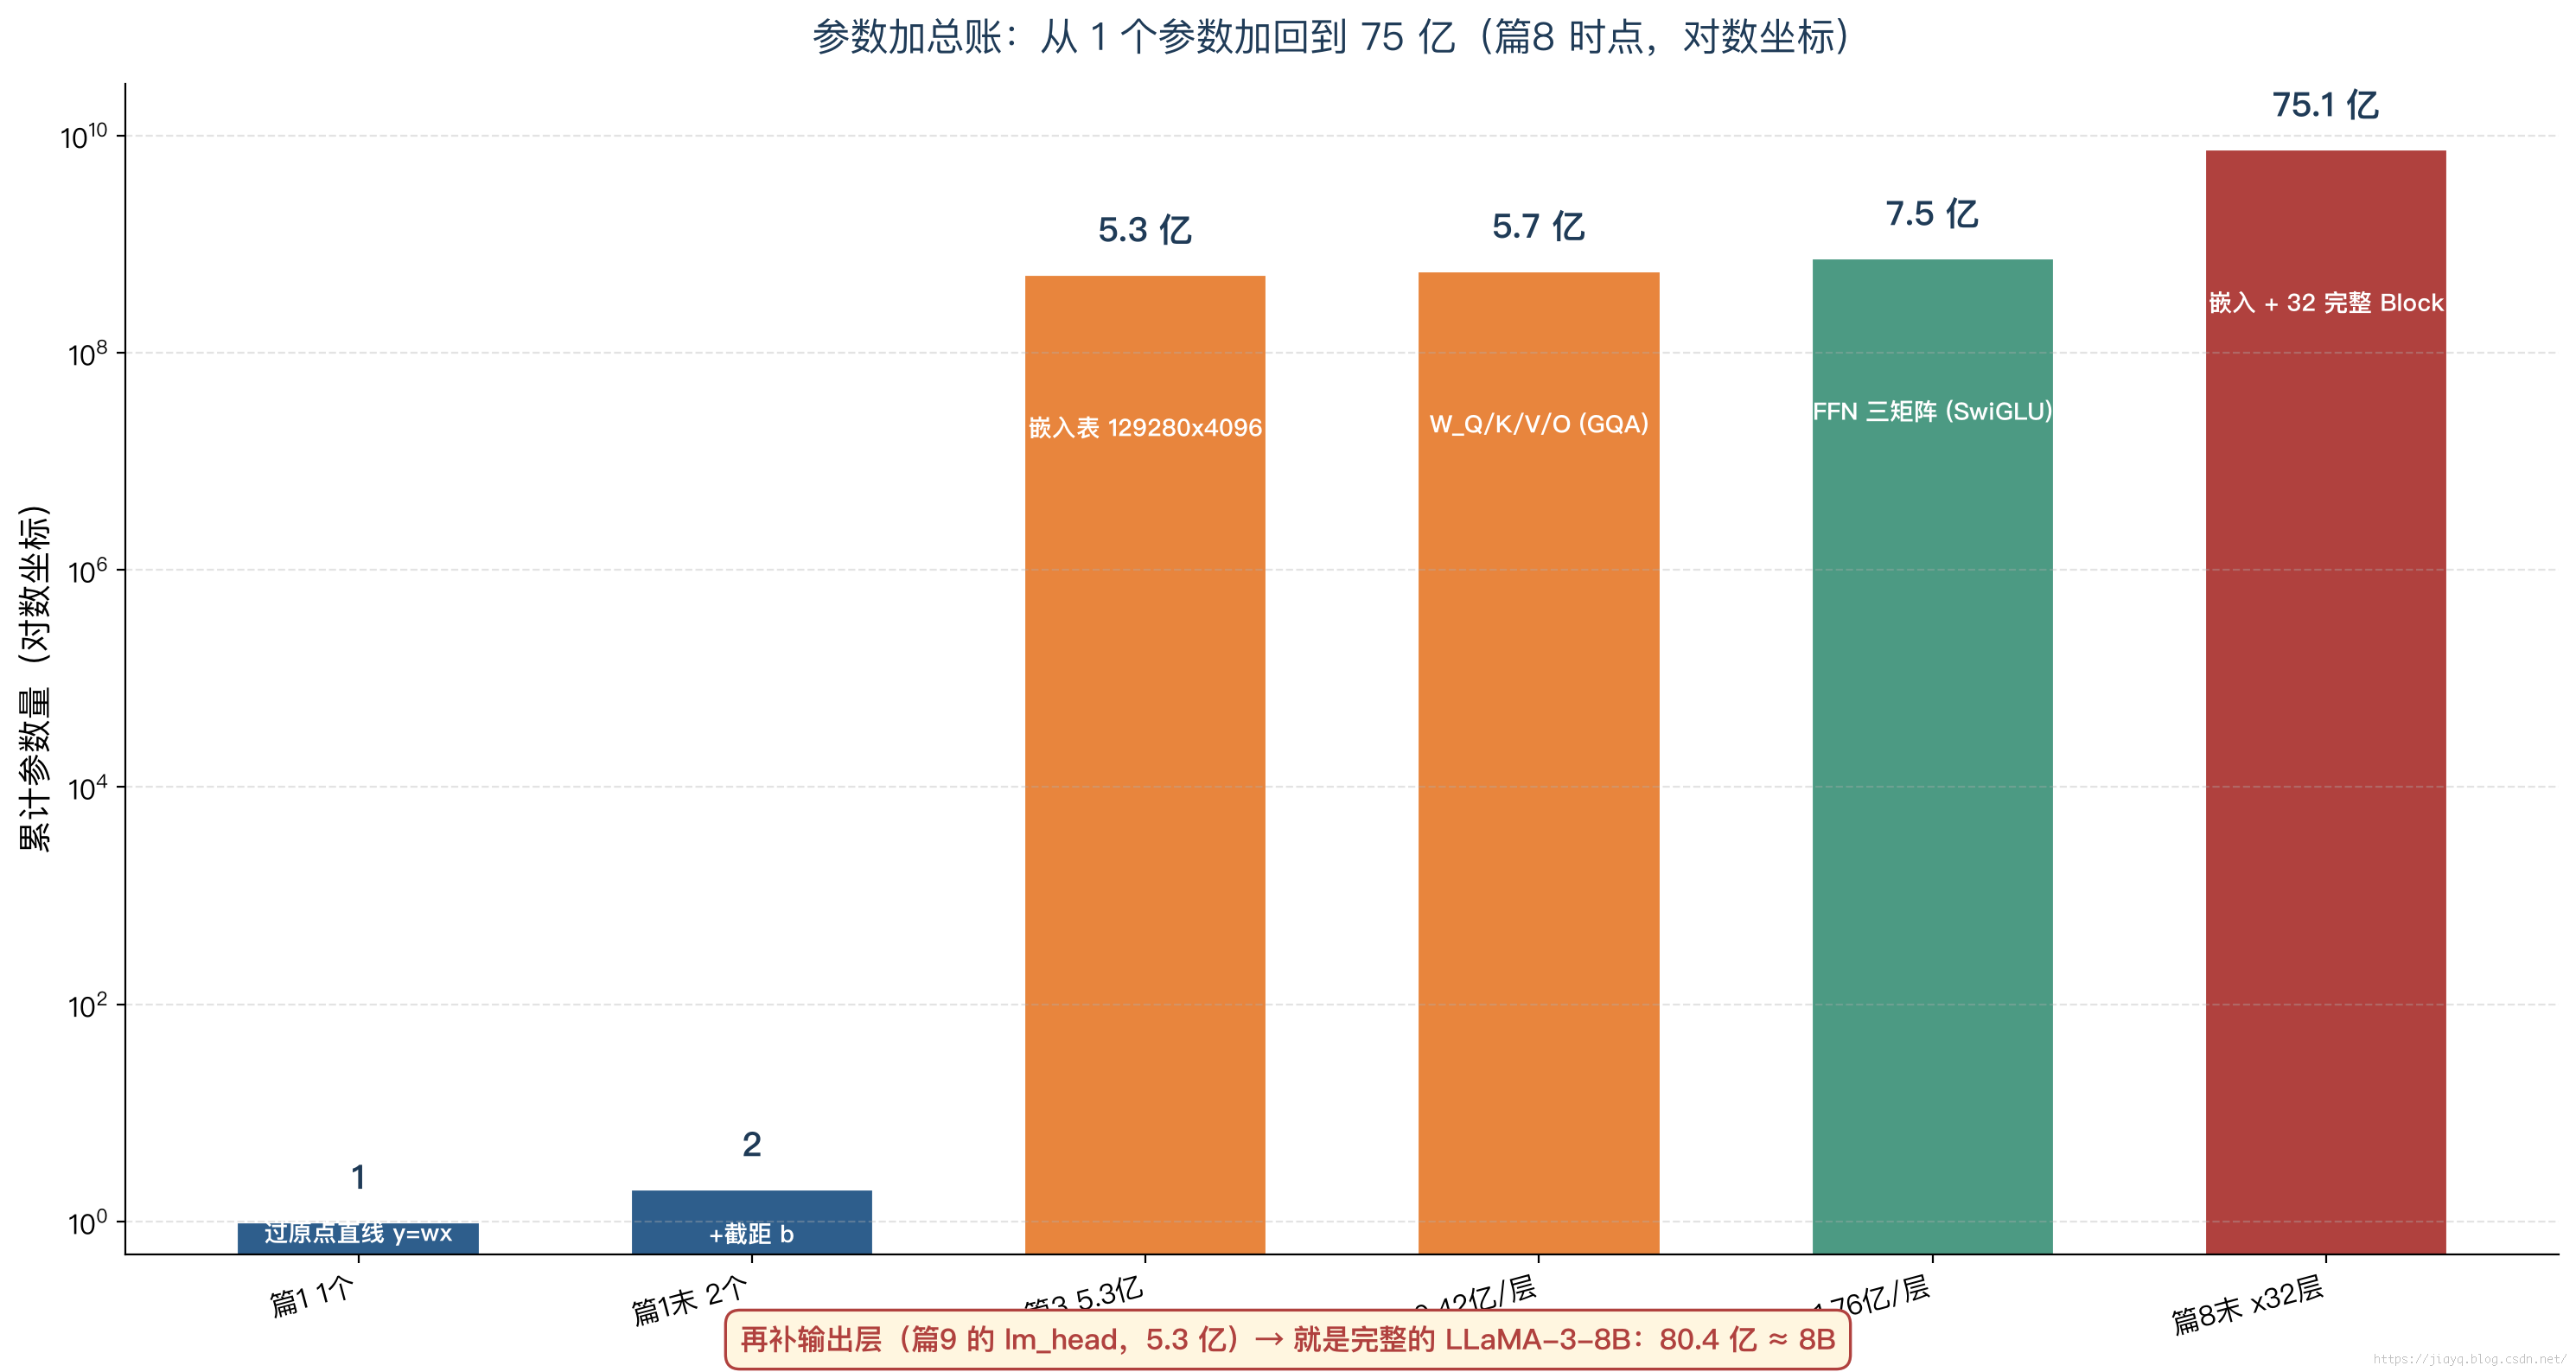
图8-11 参数加总账:从 1 个参数加回到 75 亿(对数坐标)
| 篇 | 新增组件 | 参数量 | 累计 |
|---|---|---|---|
| 篇1 | 1 个参数(过原点直线) | 1 | 1 |
| 篇1 末 | + 截距 b | 1 | 2 |
| 篇3 | 嵌入表(129,280×4096) | 5.30 亿 | 5.30 亿 |
| 篇6/7 | 注意力四矩阵(GQA:W_Q、W_K、W_V 各 4096×1024、W_O) | 0.42 亿/层 | 5.72 亿 |
| 篇5 | LayerNorm(γ、β × 2 处) | 1.6 万/层 | — |
| 篇8 | FFN 三矩阵(SwiGLU 3×4096×14336) | 1.76 亿/层 | 2.18 亿/层 |
| 篇8 末 | × 32 层(嵌入 + 32 个完整 Block) | — | 75.1 亿 |
表8-4 参数账明细(按 LLaMA-3-8B 口径,红色为篇8 时点)
75.1 亿——这就是”从 1 个参数一路加回来”到本篇为止的家底。再加篇9 的输出层 lm_head(5.3 亿),正好是 80.4 亿 ≈ LLaMA-3-8B 的 8B。对照篇1 的 230B:LLaMA-3-8B 约是它的 1/28,而 MoE 架构(如 Seed-1.6)用”稀疏激活”让总参数可以堆得更大、单次计算量却和小模型相当——这正是篇1 那个”230B vs 23B 激活”的悬念在参数层面的完整闭环。
顺带一笔对比账:单个 Block 里 FFN(1.76 亿)是注意力(0.42 亿)的 8 倍——大模型的知识大部分存在 FFN 权重里(Geva et al. 2021《Transformer Feed-Forward Layers Are Key-Value Memories》论证 FFN 像键值记忆库),注意力主要负责”查询调用”。
小结
这一篇,Block 六步全部走通,激活函数补成完整知识块:
- 分工:注意力管词间交换(跨行),FFN 管词内加工(逐行)
- 残差连接:$\mathbf{H} = \mathbf{X} + f(\mathbf{X})$,6 个 token 逐行手算;真正价值是梯度高速路(无残差 61 层梯度 $4\times10^{-19}$);出处 ResNet(何恺明 2015)
- FFN 三段式:升维 ×3.5(高维摊开模式)→ SiLU → 降维;W_up/W_down 与 W_QKV 同理,训练学出
- 激活函数完整闭环:XOR 例子(无它线性永远画不出弯)→ 万能逼近定理 → SiLU 门卫逐点表 → 激活前后三变化(收窄/保序/非线性压缩)→ 不是训练出来但不可导的 ReLU 死区被修复 → SwiGLU 门控是当前全系标配
- 参数账:从 1 加回到 75.1 亿(+篇9 输出层 = 80.4 亿 ≈ LLaMA-3-8B);FFN 是注意力的 8 倍
下一篇预告
单个 Block 出口拿到了。真实模型要把 Block 堆几十层——LLaMA-3 堆 32 层,DeepSeek-V3 堆 61 层。为什么要堆这么多?浅层、中层、深层各学什么?
下一篇讲多层堆叠:语义怎么一级级从”词法”升到”任务级”,以及大模型宽度和深度的配比逻辑。
系列目录:
- 从一条直线到高维空间
- 分词与 token 表
- 隐藏层与嵌入
- 位置编码 RoPE
- Transformer Block 全景与层归一化
- QKV 三剑客
- 注意力权重与多头机制
- 残差连接与前馈网络(当前篇)
- 输出矩阵与多层堆叠
- 首 token 诞生与 KV-Cache
版权声明:本文为博主原创文章,遵循 CC 4.0 BY-SA 版权协议,转载请附上原文出处链接和本声明。